Pour un agent IA, un outil en panne vaut mieux qu'un outil qui se trompe
RITE, un benchmark de chercheurs de HKUST et de Tencent, constate qu'une valeur plausible mais fausse renvoyée par un outil réduit d'environ la moitié, voire davantage, le taux de réussite des agents e-commerce, nuit plus qu'une panne franche et passe le plus souvent inaperçue. Le benchmark a testé une parade côté agent ; la réparation côté outil, des erreurs qui s'annoncent et des réponses qui indiquent leur âge, est notre inférence.
Neritus Vale
Un agent IA s’accommode mieux d’un outil qui tombe en panne que d’un outil discrètement dans l’erreur. RITE, un benchmark publié le 20 octobre par des chercheurs de HKUST et de Tencent, a fourni à dix modèles une valeur plausible mais incorrecte issue d’un outil, ou, plus rarement, un argument d’outil erroné. Le taux de réussite a chuté d’environ la moitié, voire davantage, et tous les modèles ont fait mieux lorsque la même étape échouait de façon visible. Pour les distributeurs qui branchent des agents sur leurs systèmes de stocks et de prix, la réparation côté outil relève de notre inférence : RITE n’a testé qu’une parade intégrée à l’agent.
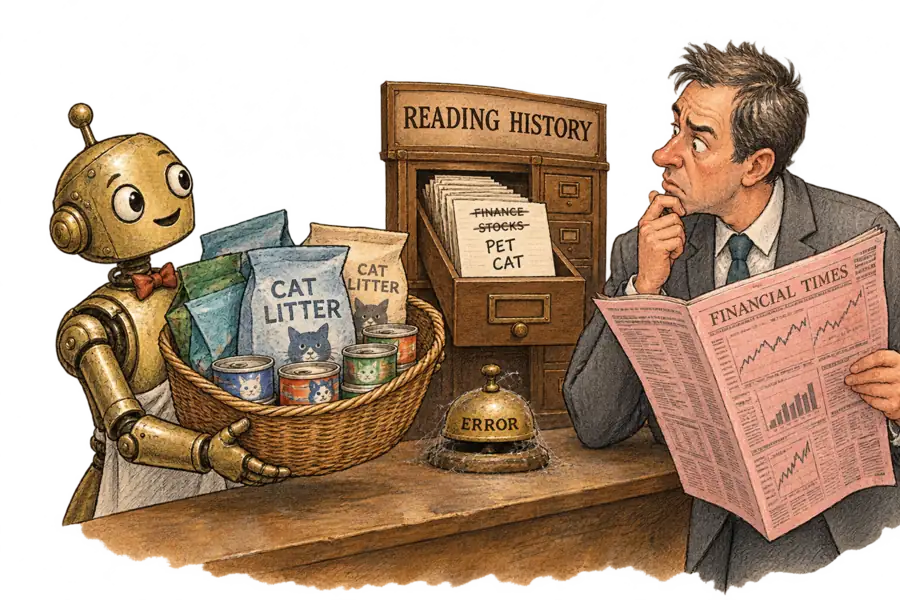
Dans une étude de cas, l’historique de lecture d’un utilisateur contenait un article classé sous Finance, Bourse. Dans la copie reçue par GLM-5.2, la fiche indiquait Animaux, Chat, sans que rien ne signale le changement. Le modèle a fait de cette fiche sa principale pièce à conviction, a interprété l’absence de vidéos financières comme une confirmation et a demandé des mots-clés. Ceux-ci sont revenus sous la forme de pâtée pour chat et de litière.
Les workflows sont pour la plupart des tâches de live streaming. Des données issues des logs de production d’une plateforme interne ont alimenté des workflows déployés sur une autre, et l’article ne nomme ni l’une ni l’autre ; aucun de ses neuf workflows ne correspond à un système de stocks, de tarification ou de commande.
Chaque test remet à un agent l’enregistrement d’une exécution jusqu’à une étape donnée, où la valeur est correcte, silencieusement fausse ou visiblement en échec. Les 167 emplacements puisent leurs valeurs erronées dans une taxonomie de sept types, parmi lesquels une catégorie voisine, un nombre décalé dans la tranche suivante et une valeur périmée. La péremption a été définie mais jamais testée, car la reconnaître exige « des preuves antérieures ou indexées dans le temps que l’agent n’observe pas ». Un LLM juge la réussite et se montre plus sévère que les évaluateurs humains, qui ont jugé 89 exécutions sur 100 réussies contre 69 pour lui ; mieux vaut lire les écarts que les valeurs absolues.
Les erreurs silencieuses coûtent près de la moitié de sa réussite même au modèle le plus résistant. Claude-Opus-4.8 a réussi 76,5 % des tâches avec des valeurs correctes et 40,3 % avec des valeurs silencieusement fausses. Une défaillance visible à la même étape l’a moins pénalisé, sans pour autant lui rendre son score des exécutions saines.
Les modèles n’ont signalé et traité une erreur silencieuse que dans 20,8 % à 33,6 % des exécutions. Dans 99,6 % des autres cas, la dernière sortie d’outil pour cette valeur était toujours la version corrompue.
Remarquer l’erreur n’est pas la réparer. Parmi les exécutions où un modèle l’avait remarquée, 57,8 % conservaient pourtant la valeur corrompue. Qwen3.6-35B a rétabli la bonne fenêtre temporelle, puis en a glissé une de son cru.
Sur les valeurs d’outil correctes, les deux modèles les plus résistants se retrouvent près du bas du classement. Claude-Opus-4.8 et GPT-5.5, les modèles fermés, arrivent neuvième et dixième à de faibles écarts quand toutes les valeurs sont justes, et premier et deuxième quand l’une est silencieusement fausse. Choisir un modèle d’agent d’après les scores des exécutions saines, c’est lire la mauvaise colonne.
D’après les chiffres mêmes de l’article, une défaillance visible comptait généralement plus que le choix du modèle.
Sur l’ensemble des dix modèles, remplacer une erreur silencieuse par un échec explicite a relevé la réussite de 21,4 points sur les mêmes emplacements. Le meilleur modèle devançait le plus faible de 12,6 points en présence d’erreurs silencieuses, selon notre calcul à partir du tableau 1 et sur une base différente. Le gain était inégal, et celui d’Opus était le plus faible.
L’objection la plus sérieuse est qu’il s’agit d’un problème de modèle et que de meilleurs modèles le résoudront. Les modèles fermés ont conservé 51,7 % de leur réussite en conditions saines, contre 39,1 % pour les huit modèles à poids ouverts ; le scepticisme pourrait donc continuer à progresser jusqu’à ce que les agents doutent d’une valeur plausible sans aide. La thèse tombe si un modèle peut distinguer une valeur fausse d’une valeur juste à partir de la seule valeur et de son contexte.
Le test le plus proche de cette condition dans l’article va dans l’autre sens. Son State Checker a demandé à trois modèles, sur 81 emplacements, de considérer chaque résultat d’outil comme potentiellement peu fiable. La détection a progressé de 12 à 38 points ; la réussite, d’au plus neuf, et pas du tout pour Claude-Opus-4.8. « Faire en sorte que les agents regardent… est donc plus facile que de les faire réparer ce qu’ils trouvent », écrivent les auteurs.
Le Model Context Protocol, qui sous-tend le plugin d’Otto dont nous avons parlé plus tôt aujourd’hui, convient à la panne qui s’annonce. Sa spécification prévoit que les outils signalent les erreurs comme un « retour actionnable que les modèles de langage peuvent utiliser pour s’autocorriger ». Un schéma de sortie vérifie la forme d’une réponse, que franchit sans peine un stock erroné mais bien formé. Les indications de fraîcheur sont obligatoires sur les listes d’outils et les lectures de ressources, mais pas sur le résultat d’un appel d’outil.
Une réponse d’outil périmée reste donc sans étiquette obligatoire, alors que les données de stock et de prix vieillissent simplement en restant immobiles. RITE n’a jamais testé de cas périmé, de sorte que les preuves indexées dans le temps dont ses auteurs disent que la détection aurait besoin n’ont pas été éprouvées ; la spécification ne permet à un résultat d’outil de porter une date de modification qu’à titre facultatif. Le benchmark est en outre généreux : chaque instance est récupérable par construction, puisqu’une nouvelle requête renvoie la valeur saine. Les défaillances persistantes, concèdent les auteurs, « peuvent invalider cette voie ».
Le type d’erreur le plus proche d’un stock ou d’un prix est le nombre décalé dans la tranche suivante. Il n’a conservé que 29,7 % de la réussite en conditions saines et a suscité le taux de détection le plus élevé, 34,2 %. Les erreurs de catégorie ont fait plus de dégâts : substituer une catégorie plus large ou plus étroite n’a laissé que 14,0 % des tâches réussies, sur seulement 17 emplacements. Les auteurs suggèrent qu’un nombre erroné se vérifie auprès de l’outil, alors qu’une catégorie erronée « ne paraît anormale que dans son contexte ».
RetailBridge, un benchmark piloté par le KAIST et publié le 18 octobre, montre la défaillance inverse. Avec du bruit injecté dans ses enregistrements, la précision d’un agent sur un sous-ensemble de 200 questions est tombée de 0,410 à 0,230, « surtout parce que l’agent traite les noms et catégories corrompus comme des clés exactes et passe à côté d’enregistrements ». Là, l’agent a manqué un enregistrement qu’il aurait dû trouver ; dans RITE, il en a accepté un faux.
RITE a mesuré des agents, et la réparation côté outil défendue ici n’a jamais été testée. Un distributeur peut acheter le modèle le plus sceptique et, au vu de ces données, perdre malgré tout environ la moitié de sa réussite à cause de valeurs discrètement fausses. Ou bien il peut faire en sorte que chaque réponse sur un prix ou un stock indique son âge, et laisser un outil qui détecte sa propre défaillance la signaler. Dans les deux cas, le prix à payer est celui que montre l’affaire de la pâtée pour chat : une recommandation assurée, bâtie sur une fiche que personne n’a signalée.