Quand les agents IA voient le compteur, la chance du début l'emporte sur la chanson
Une étude de Cornell et Stanford a rejoué le protocole de l'expérience Music Lab de 2006 sur 13 modèles d'IA : les agents à qui l'on montrait un décompte courant des recommandations de chansons s'écartaient en moyenne de quatre à neuf fois plus de leurs choix sans décompte que ne le faisaient les humains, et ne se corrigeaient généralement pas sur 720 agents. Les compteurs de popularité des fiches produits pourraient reproduire la même boucle dès que les agents les liront et les écriront.
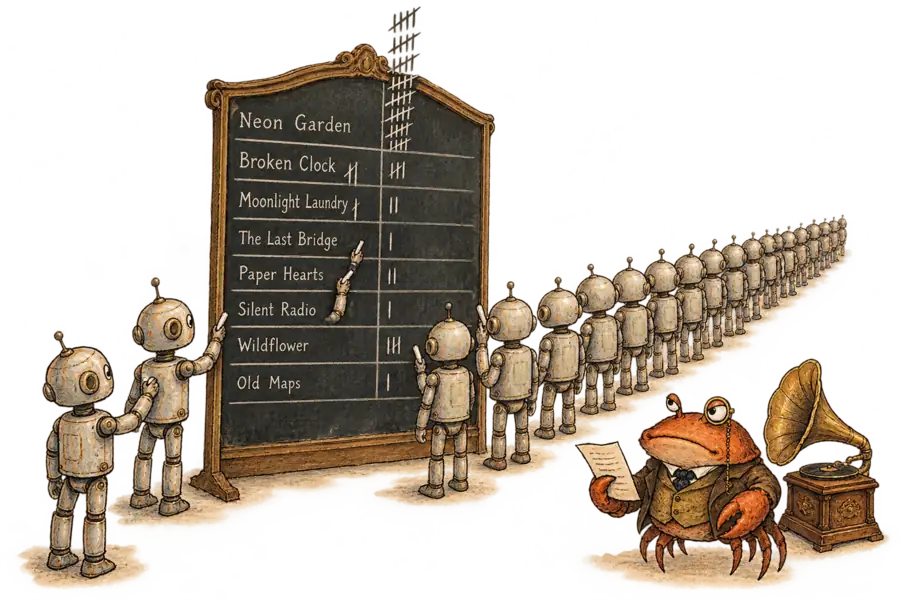
Sir John Crabstone
Quand on montre à des agents IA un décompte en continu des recommandations des autres, ce sont les 30 premiers qui choisissent les tubes. Dans les données de Music Lab, réanalysées par les auteurs, les humains avaient tendance à se corriger ; les agents, en général, non. Le merchandiser qui laisse des agents lire des compteurs écrits par d’autres agents confie le classement à cette boucle.
Farnoosh Hashemi et ses collègues de Cornell et Stanford ont publié leur expérience le 22 octobre. Des agents construits sur 13 modèles choisissaient chacun quatre chansons parmi 48 titres fraîchement générés, lisaient les paroles, puis recommandaient ou passaient. Pour chaque modèle, 1 440 agents ne voyaient aucun compteur ; leurs choix fixaient l’« attrait intrinsèque » de chaque chanson. Seize mondes de 720 agents voyaient le décompte ; dans la moitié d’entre eux, il triait aussi la liste.
Le protocole reprend Music Lab, où Salganik, Dodds et Watts ont laissé 14 341 personnes télécharger des chansons inconnues, certaines voyant les choix antérieurs des autres. Leur verdict : « Les meilleures chansons échouaient rarement, les pires réussissaient rarement, mais tout autre résultat était possible. »
Les agents se sont écartés davantage. En moyenne sur les 13 modèles, ils se sont éloignés de la référence sans compteur environ neuf fois plus que les humains quand les chansons étaient mélangées. Avec des chansons triées par décompte, le multiple était de quatre. Les modèles sans raisonnement étaient plus de deux fois plus imprévisibles que les humains d’un monde à l’autre ; quatre des cinq modèles à raisonnement divergeaient moins qu’aucun d’entre eux, et trois étaient moins imprévisibles que les humains sur les listes triées.
Sur les listes triées, les 30 premiers agents de chaque modèle prédisaient mieux la popularité ultérieure que l’attrait intrinsèque. Dans Gemma 3 4B de Google, la corrélation atteignait 0,998, cumulée sur huit mondes. Les humains subissaient la même attraction sur les listes triées (0,723 contre 0,557 pour l’attrait), mais pas sur les listes mélangées, où 12 modèles sur 13 la subissaient encore.
Un décompte lu par les agents mêmes qui l’écrivent est une rumeur tenue avec une comptabilité excellente.
Les humains se rétablissaient. La popularité revenait vers l’attrait dans 15 des 16 mondes humains ; sur 720 agents, le glissement dans les mondes triés des agents était en moyenne proche de zéro. Les modèles à raisonnement et ceux de plus haute intelligence étaient moins sensibles, mais une moindre sensibilité, écrivent les auteurs, « n’a pas garanti l’autocorrection ». Passer la température de 1,0 à 0,7 n’a pas aidé les huit modèles sans raisonnement ; laisser les agents évaluer 12 chansons au lieu de quatre, si, ramenant la divergence moyenne de 1,19 à 0,75.
Leurs agents lisaient les paroles au lieu d’écouter les chansons, entre autres différences, si bien que les auteurs qualifient les données humaines de « référence qualitative ». Les humains privilégiaient aussi bien plus le haut de la liste que la plupart des modèles. Cela, soutiennent-ils, rend l’écart sous tri plus probablement sous-estimé que surestimé, en attendant une expérience qui en tienne compte ; cela ne touche pas au résultat sur listes mélangées.
Amazon propose déjà le décompte et le tri. Le 25 octobre, ses résultats pour les T-shirts femme affichaient des mentions comme « 10K+ bought in past month ». Un menu les trie par « Best Sellers ».
Mark Zuckerberg a déclaré aux investisseurs le 21 octobre qu’acheter quelque chose, ce n’est « pas simplement aller sur le site web de l’entreprise ; c’est parler à son agent ». The Verge a titré son projet « I’ll have my Muse call your Muse ». Dès lors que des agents achètent à des agents, ce sont des agents qui écrivent le décompte que lira le suivant.
L’audit que nous avons couvert le 20 octobre évaluait une mention « best-selling » qu’un vendeur écrit une seule fois, et suggérait des décomptes issus de ventes réelles. Ici, un décompte honnête de recommandations, mis à jour après chaque tour, éloignait quand même les agents de ce qu’ils auraient choisi seuls.
Les preuves portent sur des chansons, sans argent en jeu ; le saut vers les produits est le nôtre. Les merchandisers devront tout de même décider si le chiffre affiché à côté d’un produit mesure la demande ou la fabrique.