Le commerçant IA sait vendre. Il oublie de réapprovisionner.
Dans StoreBench, une boutique de prêt-à-porter simulée tournant sur un vrai logiciel de commerce, le meilleur agent IA égale onze opérateurs humains sur la croissance des actifs nets et leur cède sur les expéditions et les remboursements. Les échecs les plus fréquents des agents relèvent des corvées d'un employé, ce qui plaide pour des agents travaillant dans des règles fixes plutôt que pour des agents gérant seuls la boutique.
Neritus Vale
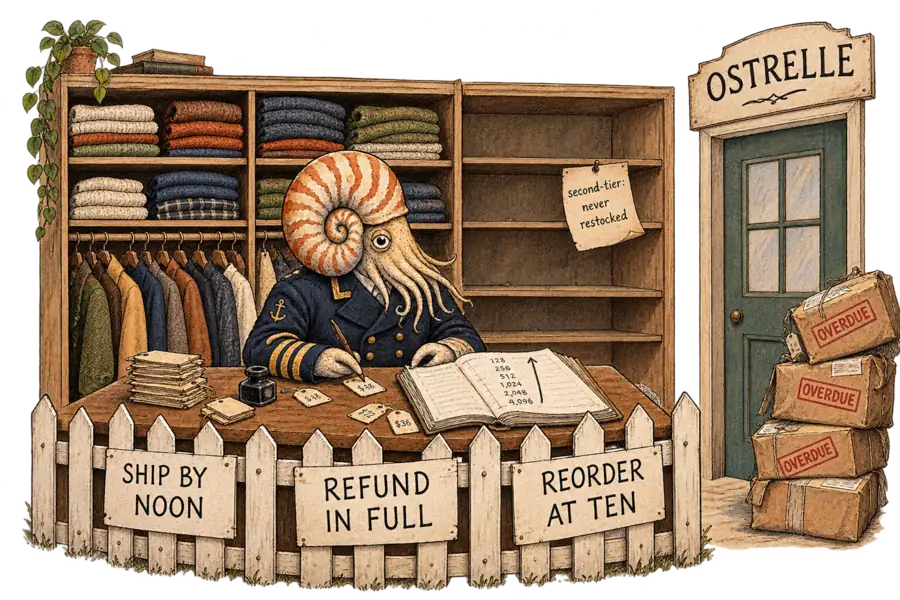
Dans un nouveau benchmark, le meilleur agent IA, DeepSeek-V4-Pro, fait croître les actifs d’une boutique de vêtements en ligne à peu près aussi bien que des opérateurs humains, et leur cède sur les corvées. Une exécution solide de Claude Opus 4.8 d’Anthropic a elle-même nommé son échec : « les vendeurs de second rang sont en rupture de stock … je ne les ai jamais réapprovisionnés ». Une règle écrite à l’avance n’oublie pas un réassort, ce qui plaide pour des agents travaillant dans des règles fixes, et non pour des agents gérant seuls la boutique.
StoreBench, soumis à arXiv le 7 octobre par Daksh Raghuvanshi et deux coauteurs, place un agent aux commandes d’Ostrelle, une boutique de prêt-à-porter fictive de taille moyenne tournant sur la plateforme de commerce open source Medusa. Les fournisseurs changent de prix et défaillent, des chocs scénarisés surviennent, et la demande n’est visible qu’à travers les ventes de la boutique. L’agent dispose des mêmes outils de marchand qu’un opérateur humain, et chaque appel, hormis une sonde d’état gratuite, consomme une opération sur une enveloppe fixe par fenêtre de 12 heures. Un rapport de ventes et une commande expédiée se disputent le même budget.
Aucun modèle n’a battu en moyenne le meilleur des scripts des auteurs. « Smart-triage », un opérateur heuristique utilisant les mêmes outils et les mêmes budgets, a obtenu en moyenne 0,764 au score composite de l’article, construit surtout sur la croissance des actifs nets, avec des pondérations plus faibles pour le service et l’assiduité. Un « checklist clerk » plus simple a obtenu 0,638, devant tous les modèles sauf DeepSeek-V4-Pro et Claude Opus 4.8. Cinq des sept modèles sont tombés sous la checklist.
La comparaison avec les humains a fourni le titre de l’article, qui masque l’endroit où se situe l’écart. Onze prestataires déclarant une expérience en e-commerce ont fait tourner les mêmes scénarios avec les mêmes outils et ont obtenu en moyenne 0,708. Le résumé affirme que les experts humains ont surpassé tous les modèles, ce qui est vrai et n’apprend pas grand-chose au lecteur. Les 0,700 de DeepSeek-V4-Pro restent derrière d’un écart bien inférieur à la dispersion des scores des humains eux-mêmes.
Les humains l’ont emporté sur le service. Leur score de fiabilité, qui fait la moyenne entre expéditions à l’heure et part des retours traités, s’est élevé à 0,944. L’essentiel est de la routine : une commande part à l’heure ou non, et un retour est remboursé avant son échéance ou il est escaladé. Les annulations pour rupture de stock pèsent aussi sur le taux de ponctualité, si bien qu’un réassort manqué abaisse aussi le score. Le meilleur modèle a atteint 0,852, et les commandes non expédiées comme les retours ignorés ont valu des pénalités lors du règlement.
Sur le plan financier, un agent avait rattrapé son retard. Le score business de DeepSeek, la mesure de croissance des actifs nets retenue par l’article, était de 0,614 contre 0,599 pour les humains. Il a été obtenu face à une demande cachée et à des fournisseurs défaillants, là où le jugement est censé distinguer les humains du logiciel.
Ce rattrapage tient à un seul modèle, pas à l’ensemble du champ. Les six autres allaient de 0,226 à 0,573 sur la même mesure. Les auteurs tirent leur conclusion des journaux d’échec : l’écart restant tient « moins à savoir ce que fait une bonne boutique qu’à exécuter de manière constante des obligations de routine ».
Les échecs les plus fréquents des modèles ressemblent à la pire semaine d’un employé, et ils coûtent de l’argent. Les sous-achats et ruptures de stock sont apparus dans 26 % des essais, y compris chez les meilleurs scores : réassorts trop maigres, trop tardifs, ou qui négligeaient les lignes secondaires. C’est l’aveu d’Opus à grande échelle. Dans 60 essais, l’agent n’a jamais passé de bon de commande, la plupart imputables à Gemini 3.8 Flash.
Les remboursements ont mal tourné autrement. Les agents ont remboursé trop peu, les clients ont refusé, et les retours ont dépassé leurs échéances pour finir en pénalités, un résultat pire que de payer en totalité. L’article impute ses trois modes d’échec au score business et les ramène à une seule cause : un budget d’exploitation rare, mal dépensé. C’est pourquoi des règles les corrigent. Un point de commande ou un passage d’expédition systématique ne dépense pas d’opérations en sondes d’état.
Le discours des éditeurs sur le commerce agentique confie les corvées aux agents et laisse la stratégie aux humains. Le guide de Salesforce sur l’usage des agents IA dans le commerce propose un assistant pour « faire le travail ingrat à votre place » et recommande des agents prêts à l’emploi pour « les tâches de commerce courantes (de la création d’un lot de produits à la gestion des stocks) », laissant aux équipes le soin de « se concentrer sur un travail plus stratégique, à plus forte valeur ».
Dans StoreBench, c’est dans le travail ingrat que l’argent s’est perdu.
Les deux opérateurs les moins fiables ont aussi improvisé leur propre automatisation, mal. Dotés d’un shell, Gemini et Muse Spark, de Meta Superintelligence Labs, ont lancé des lots massifs d’expéditions, de remboursements et de réassorts bâtis sur des données périmées, dépensant leur budget en sondes d’état plutôt qu’en écritures. Les deux exécutions de Gemini avec outils natifs ont obtenu en moyenne 0,89, contre 0,55 pour ses exécutions via le shell ; l’échantillon est mince, mais celui, plus large, de Muse va dans le même sens. L’usage du shell ne suffit pas à expliquer les mauvais scores, puisque Opus, Fable et GPT pilotent aussi la boutique via le shell dans presque tous les essais. L’article dit que la ligne de partage suit le modèle plutôt que la tâche.
Les réserves affaiblissent surtout le titre. Les humains ont fourni un résultat sélectionné par cellule, avec une nouvelle tentative autorisée, contre trois tentatives non sélectionnées par cellule de modèle. Notée sur la première tentative menée à terme, la moyenne humaine tombe à 0,656, derrière DeepSeek et Opus ; l’article précise que ce chiffre combine coaching, réaffectation et une exécution affectée, et n’estime pas un effet d’entraînement.
Les humains ont aussi travaillé via une console bâtie sur la surface d’outils des agents, et non sur leur logiciel de boutique habituel, après un briefing d’heuristiques proches de celles de smart-triage. La console ajoutait une vue d’historique, une boîte de réception des retours et des vues en cache relisibles sans dépenser d’opération, ce qui touche directement au traitement des retours, où les humains menaient. Les humains ont franchi le seuil de réussite de l’article dans 39 % des cellules, contre 49 % pour DeepSeek.
Chaque seuil de réussite se situe à mi-chemin entre les deux meilleurs scripts honnêtes, si bien que le taux de réussite de 97 % de smart-triage est en partie intégré à l’échelle. L’environnement complet est tenu secret, personne à l’extérieur ne peut donc le relancer.
La plus forte objection est que les corvées relèvent d’un problème de harnais. Sur une année simulée complète sous Claude Code, DeepSeek a obtenu 0,976 contre 0,700 sur les scénarios courts, et cinq des sept modèles ont fini bien au-dessus du script qui dominait ces scénarios. Si un meilleur échafaudage suffit à apprendre aux agents à réapprovisionner, rembourser et expédier, la clôture est une béquille que le harnais de l’an prochain supprimera.
Le résultat sur l’année complète ne peut pas porter ce poids. Il n’avait pas de chocs scénarisés, un harnais différent et un effort de raisonnement plus élevé, et les auteurs disent qu’il ne permet pas d’isoler l’effet du harnais. Dans quatre tentatives sur neuf, Gemini a affirmé qu’un processus de simulation en arrière-plan faisait tourner la boutique et a attendu au lieu d’agir. Une tentative de GPT-5.6 Sol a déclaré la boutique achevée à la fenêtre 185 sur 365 et s’est arrêtée. Une règle qui expédie toutes les commandes ouvertes à chaque fenêtre ne croit pas aux processus en arrière-plan.
Pour un détaillant, la décision porte sur les choix à retirer à l’agent. Les points de commande des lignes calmes, les remboursements intégraux dans le délai et un passage d’expédition à chaque fenêtre relèvent d’un code que l’agent ne peut pas contourner. StoreBench n’a pas testé cet hybride ; l’argument repose sur ses journaux d’échec. En juillet, RetailBench nous a conduits à conclure qu’un déploiement crédible garde un humain veillant sur la boutique. Ces journaux suggèrent qu’une bonne part de cette surveillance peut être écrite avant la prise de poste.