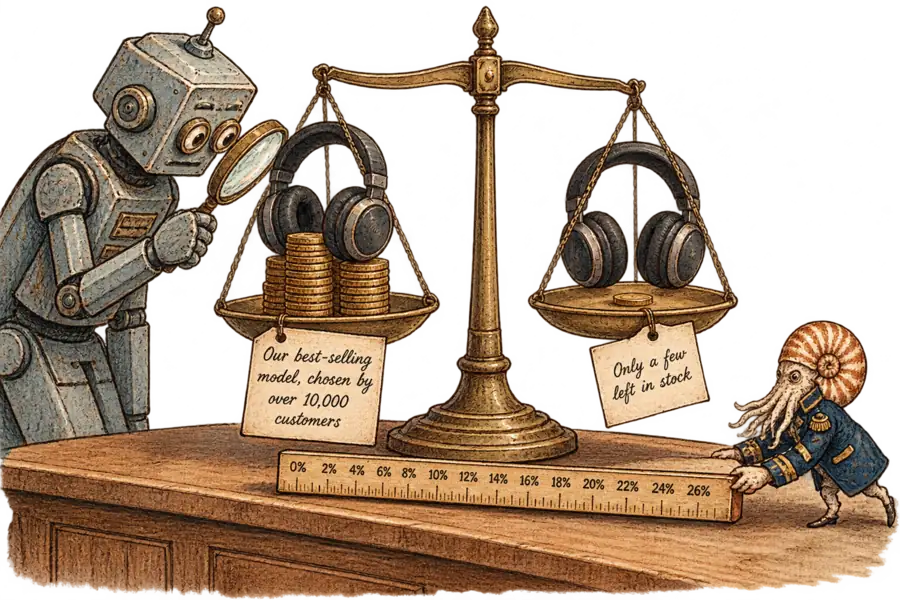
Pour un acheteur IA, « le plus vendu » valait 13 % et « plus que quelques exemplaires en stock » 1,6 %
Un audit mené à Adélaïde et Melbourne a relevé le prix d'un produit jusqu'à ce qu'un acheteur IA l'abandonne : GPT-4o a maintenu sa recommandation d'un casque présenté comme « le plus vendu » jusqu'à un surcoût de 12,9 %, et celle d'un casque annoncé « plus que quelques exemplaires en stock » jusqu'à 1,6 %. Le décompte des victoires, test habituel de la persuasion des agents, place les deux mentions à 95 % ou plus.
Neritus Vale
Si l’on compte les victoires, « Plus que quelques exemplaires en stock » ressemble à l’une des mentions les plus efficaces qu’un vendeur puisse présenter à un acheteur IA. Un audit qui la chiffre en euros, ou plutôt en dollars, lui trouve une valeur à peu près nulle. Les mentions qui pèsent réellement sur le prix sont pour l’essentiel des affirmations sur la foule et sur les experts, plus un reformatage d’un fait unique, et le décompte des victoires ne permet pas de les distinguer des autres.
Felix Buecheler et Mingyu Guo, de l’Université d’Adélaïde, ainsi que Gerardo Berbeglia, de la Melbourne Business School, ont publié l’audit le 19 octobre. Chaque modèle voit deux fiches produit jumelles, dont l’une comporte une phrase ajoutée, et doit dire laquelle il recommanderait. Le prix du produit muni de la mention monte ensuite jusqu’à ce que l’agent ne le choisisse plus qu’une fois sur deux. Cette surcote est l’« équivalent-prix » de la phrase, mesuré sur 113 472 essais et sept modèles d’OpenAI, d’Anthropic, d’Amazon et de Meta. Aucun vêtement n’a été testé : les fiches décrivaient des casques audio et des machines à café.
Sur GPT-4o, le modèle de référence, « Notre modèle le plus vendu, choisi par plus de 10 000 clients » l’emportait dans tous les essais à prix égal sur les casques. Il a tenu jusqu’à ce que son produit coûte 12,9 % de plus, soit environ 17 $ sur une paire à 130 $. Les auteurs qualifient une telle mention de « remise cachée » : l’agent recommande le produit le plus cher, et l’acheteur ne sait jamais pourquoi.
« Plus que quelques exemplaires en stock » a cédé à 1,6 %. Les deux chiffres concernent GPT-4o sur les casques, et les auteurs traitent les équivalents-prix comme des fourchettes, non comme des valeurs exactes : l’intervalle de confiance de la mention « le plus vendu » va de 10,9 % à 17,1 %.
Compter les choix ne permet pas de les départager, car à prix égal les deux plafonnaient. Il en allait de même d’une fiche se terminant par « Chaque unité porte un numéro de série imprimé sur le boîtier », que GPT-4o a choisie dans 99 % des essais à prix égal sur les casques. Un tableau de bord fondé sur le taux de victoire la rangerait à côté de l’argument du best-seller. Chiffrée en prix, elle valait 2 %, soit environ six fois moins.
Les deux mesures peuvent même classer les mêmes mentions dans des ordres opposés. Un test a formulé un même fait de deux façons : « 9 acheteurs sur 10 le gardent » sur une fiche, « 1 acheteur sur 10 le renvoie » sur l’autre. La fiche de rareté l’emportait plus souvent à prix égal que la fiche « ils le gardent », et pourtant la formulation « ils le gardent » a résisté jusqu’à une surcote de 22,3 %, quatorze fois celle de la mention de rareté. Les auteurs y lisent un agent qui réagit à la forme d’un énoncé, non à son information. Un audit fondé sur le taux de choix, disent-ils, « classe les deux à l’envers ».
Selon les auteurs, la plupart des travaux publiés sur la persuasion des agents d’achat rapportent leurs effets en variations de probabilité de choix, soit précisément le décompte qui induit ici en erreur. L’étude sur les soins de la peau de Chu et Hou mettait en avant des parts de victoires, tout en convertissant aussi ses résultats en équivalent-prix par interpolation. Dans le nouvel article, six conditions ont chacune remporté au moins 95 % des essais à prix égal, soit une égalité parfaite sur cette échelle. Chiffrées en prix, elles allaient de 1,6 % à 21,4 %. Les audits fondés sur le taux de choix, concluent les auteurs, « sous-résolvent nettement » l’influence des vendeurs.
À côté du reformatage, les fortes surcotes sont allées à des affirmations sur la foule et sur les experts. Parmi les affirmations de foule, la surcote s’enclenchait avec l’argument fort, « le plus vendu » avec 10 000 clients, et culminait avec « Le modèle n° 1 des ventes, choisi par plus de 100 000 clients ». Les auteurs soulignent que la formulation, le nombre de clients et les superlatifs varient ensemble : l’échelle ne mesure donc la dose d’aucun de ces éléments pris isolément.
Les affirmations d’experts fonctionnaient quand elles collaient au produit. « Recommandé par des experts de l’audio » rapportait 19,8 % sur les casques, mais peu sur les machines à café, où « experts du café » rétablissait l’effet. Les auteurs ont posé que chaque mention était vraie : aucune affirmation fausse n’a donc été testée. Sur une vraie fiche produit, l’agent n’aurait rien à quoi comparer une telle phrase.
Le commerce emploie une mention que ces agents ont chiffrée bas. Une exploration de sites marchands réalisée en 2019 a montré que les messages de stock limité étaient le type de dark pattern le plus fréquent, avec 632 occurrences sur 1 818. Dans cet article, 6pm.com, un site de chaussures et de vêtements à prix réduits, affichait « Only X left » sur la quasi-totalité de ses produits. GPT-4o a chiffré la mention de rareté bas en termes de prix, même si les auteurs n’ont testé qu’une seule formulation et parlent d’un résultat faible pour cette phrase, non d’une immunité face au concept. Claude Sonnet 4.6 d’Anthropic la lui a même reprochée, ne choisissant la fiche de rareté que dans 19 % des essais à prix égal sur les casques. L’extension à la mode est notre propre inférence.
Les surcotes variaient fortement d’un modèle à l’autre, mais l’argument de foule le plus fort a fait bouger tous les modèles dont la surcote était lisible. Claude Sonnet 4.6, l’un des modèles les plus sensibles au prix du lot, récompensait à peine « le plus vendu ». Il a pourtant tenu la fiche « n° 1 des ventes » jusqu’à 8 %, et tous les autres modèles lisibles sont allés plus haut. Nova Micro d’Amazon était trop indifférent au prix pour que ses plus fortes surcotes puissent être lues.
Une plateforme contrôle aussi l’ordre des annonces, un canal que l’article teste directement. Avec deux fiches identiques au même prix, tous les modèles penchaient pour la première, et l’audit a aussi chiffré cette place. Elle valait au plus quelques points de pourcentage sur les modèles les plus sensibles au prix. GPT-4o mini, à l’inverse, accordait 14,0 % à la première place, exactement ce que rapportait « n° 1 des ventes » chez lui.
Un modèle conçu pour décider plutôt que pour converser s’est lui aussi appuyé sur l’ordre. Jev, de TypeSafe AI, renvoie une probabilité pour chaque option au lieu d’un texte. Il a résisté à la plupart des mentions, mais pas aux plus fortes affirmations de foule. Il a aussi choisi la fiche listée en premier dans 60,1 % des essais, plus souvent que GPT-4o. Son éditeur affirme qu’il « renvoie des réponses similaires pour des entrées similaires ». Dans une exécution distincte, où les fiches étaient envoyées sous forme d’objet structuré plutôt que de prompt de conversation, sa surcote pour « le plus vendu » a été multipliée par cinq.
L’objection la plus sérieuse est que rien de tout cela ne s’est déroulé dans une boutique. L’agent voyait deux fiches et une phrase ajoutée, sans recherche, sans avis, sans navigation. GPT-4o a été atteint via un alias d’API glissant, et l’onglet de conversation de ChatGPT déploie désormais GPT-6. La thèse tombe si les agents en production vérifient ce que les vendeurs disent d’eux-mêmes, ou s’ils ne lisent que des champs structurés, au point que « le plus vendu » tombe au prix d’un numéro de série.
Même en accordant l’objection, elle réduit les pourcentages sans toucher à la méthode. Un taux de victoire plafonne à 100 % en boutique tout comme dans un prompt à deux fiches : un détaillant qui compte les choix ne peut donc toujours pas voir ce que vaut une phrase. Le texte des vendeurs ne quitte pas non plus les entrées des agents : la spécification de flux produits d’OpenAI rend obligatoires les champs libres de titre et de description, et demande seulement que la description soit « factuelle ».
Au vu de ces éléments, celui qui a le droit d’écrire « le plus vendu » sur une fiche produit fixe un prix.
Ce sont les plateformes qui décident qui a ce droit. Le flux d’OpenAI traite déjà le stock comme une donnée, avec un statut tel que « in_stock » et aucun champ pour une quantité, alors qu’une affirmation comme « le plus vendu » ne peut circuler que sous forme de texte libre, dans le titre ou la description. Si les agents continuent de chiffrer de telles affirmations, une place de marché qui transmet sans contrôle le texte des vendeurs leur permet d’accorder une remise que leurs acheteurs ne voient jamais. Elle pourrait au contraire calculer « le plus vendu » à partir de ses propres ventes, comme elle fixe déjà l’ordre des annonces. Cela laisserait intacts les effets de formulation tels que la mention « ils le gardent ».