Aucun modèle du benchmark canapé d'Amazon n'a su vérifier de façon fiable une retouche par IA
Le benchmark V-CAPE, conçu par des chercheurs d'Amazon, demandait à des modèles vision-langage si des photos produit retouchées par IA conservaient le produit intact. Avec un prompt simple, le meilleur a obtenu 63,5 % sur les deux sous-ensembles, alors qu'approuver tout rapporte environ la moitié. Photoroom vend un contrôle de fidélité automatisé pour la mode, mais a fait noter son propre benchmark par des personnes, et les règles d'Etsy laissent la vérification finale aux acheteurs.
Neritus Vale
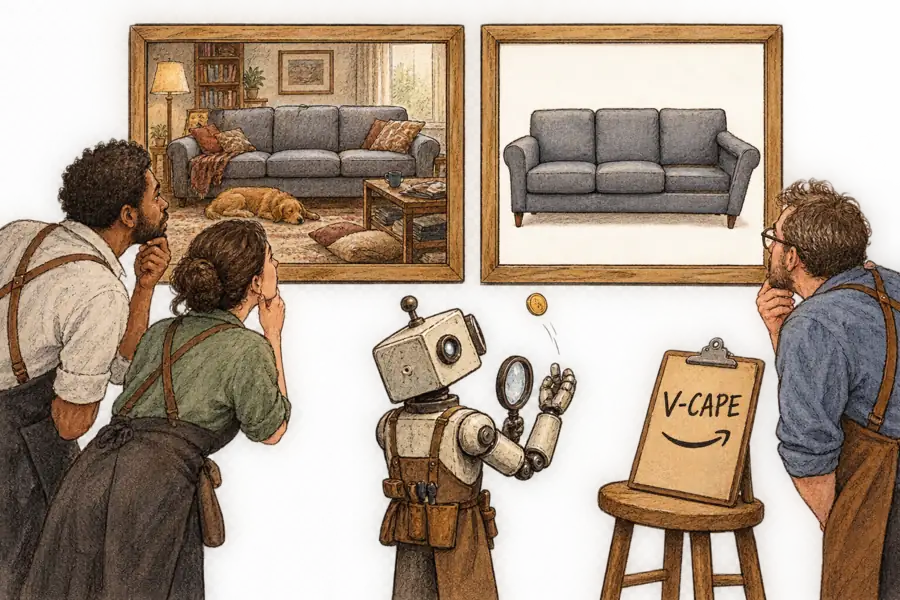
Des chercheurs d’Amazon ont voulu savoir si une IA peut contrôler une photo produit retouchée par une IA, et les résultats laissent le travail aux humains. Leur benchmark, V-CAPE, publié le 28 octobre, demande à des modèles si un produit a survécu à sa retouche. Sur ses deux sous-ensembles, le meilleur modèle testé a obtenu 63,5 % avec un prompt simple, plus proche du pile ou face que d’un inspecteur. Etsy et Vestiaire Collective laissent désormais l’IA retravailler les photos d’annonces ; Etsy s’en remet à la responsabilité du vendeur pour les mauvaises retouches, et Vestiaire s’appuie sur la promesse de fidélité de son prestataire.
Rien dans ce benchmark ne se porte. Son sous-ensemble réel compte 20 000 paires construites à partir de photos de canapés issues d’annonces e-commerce publiques ; un modèle Gemini place chacun sur fond blanc et, si besoin, un second le tourne vers la gauche (section 3.1, annexe A.1). Un sous-ensemble synthétique de même taille génère des chaises, des tables, des lampes et des coussins. Les auteurs insistent : leur pipeline « ne reflète aucun système de production ».
La retouche ressemble à celle que la mode de seconde main achète aujourd’hui, mais elle va plus loin. Sur chaque nouvelle annonce Vestiaire, l’API de Photoroom « supprime l’arrière-plan de la photo principale, ajoute une ombre, centre l’article et corrige l’éclairage », indique Photoroom. Le prompt de V-CAPE demande un « PURE WHITE background » avec des « light shadows », mais il efface aussi l’éclairage d’origine et retire personnes, animaux et décor.
Ce sont des humains qui ont écrit le corrigé. Trois annotateurs formés ont jugé chaque paire, la majorité tranchait, et leur accord a atteint un kappa de Fleiss de 0,77 après cinq cycles d’alignement (section 3.3).
Le sous-ensemble réel est équilibré de sorte qu’approuver toutes les retouches rapporte la moitié des points. Plusieurs modèles ont frôlé la réponse identique pour chaque paire, ce que l’article appelle « near-universal rejection or acceptance » (rejet ou acceptation quasi universels) (section 4.1).
Ni la taille ni le prompting n’ont sauvé les modèles. La liste allait de modèles ouverts Qwen3, Gemma et Mistral à Claude d’Anthropic et à Nova, le modèle d’Amazon ; aucun modèle GPT ou Gemini n’a été testé comme juge. Les auteurs indiquent qu’un prompt optimisé automatiquement a apporté trois à cinq points, mais ce prompt affirme au modèle que ses étiquettes de référence sont correctes, ce qui peut flatter le gain. Ils concluent que le goulot d’étranglement tient « not only in instruction design, but in the underlying perceptual capabilities » (pas seulement à la conception des instructions, mais aux capacités perceptives sous-jacentes).
Sur les canapés réels, le fine-tuning a fait encore moins. Les auteurs ont ajusté un petit modèle Qwen sur 55 exemples, dont 35 réels (tableau 1). La précision est restée autour de 52 %. Son score F1 a bondi, signature d’un modèle qui a troqué le rejet de tout contre l’approbation de tout.
La prémisse et la conclusion de l’article se contredisent. Son résumé qualifie l’inspection manuelle d’« infeasible » (impossible) à grande échelle. Son annexe sur l’impact sociétal affirme que les résultats suggèrent que « human oversight will remain essential for the foreseeable future » (la supervision humaine restera essentielle dans un avenir prévisible). Toute place de marché qui laisse l’IA retoucher des photos se situe entre ces deux phrases.
Le benchmark de fidélité de Photoroom a été noté comme celui d’Amazon, par des personnes. Il a soumis vêtements, chaussures, sacs, bijoux et accessoires à quatre modèles de retouche d’image pour la génération de mannequins virtuels, une tâche différente du nettoyage de V-CAPE, et a posé pour chaque résultat la question : « is this still the same product? » (est-ce toujours le même produit ?). Au moins trois annotateurs formés examinaient chaque image, et un seul signalement valait échec. Ce seuil est plus strict que le vote majoritaire de V-CAPE. Le meilleur modèle a réussi dans 29,0 % des cas.
Aucun des deux benchmarks n’a laissé une machine écrire son corrigé.
Le contrôle que vend Photoroom, lui, est une machine. Dans une preuve de concept, le repassage par IA a fonctionné avec son Fashion Fidelity Rater comme barrière. Le système « processed over 2 million garment images for a fashion marketplace and sent only seven to human review, meeting the brand’s fidelity criteria » (a traité plus de 2 millions d’images de vêtements pour une place de marché de mode et n’en a envoyé que sept à la revue humaine, conformément aux critères de fidélité de la marque), écrit le prestataire.
Sept sur deux millions, c’est le chiffre qu’afficherait un évaluateur quasi parfait. Un évaluateur qui laisse presque tout passer produirait la même poignée, et V-CAPE a observé cette habitude chez des modèles généralistes. Pour les départager, il faut un audit humain de ce qui est passé. Les autres chiffres de Photoroom, 99,9 % des contrôles validés sans revue dans un déploiement réel en seconde main et aucun effet négatif sur les taux de retour lors d’un essai de six semaines, ne testent pas si l’évaluateur est d’accord avec une personne.
Le but affiché d’Etsy est la confiance des acheteurs, mais la photo non retouchée que la plupart des annonces doivent désormais comporter donne aussi à l’acheteur une photo « avant » à laquelle comparer les images retouchées par IA, lesquelles ne doivent pas « make the item appear different » (donner à l’article un aspect différent). Au moment du téléversement, Etsy détecte les images générées par IA et propose des conseils, et indique qu’« over time, we plan to more proactively enforce these requirements as listings are created » (avec le temps, nous prévoyons d’appliquer ces exigences de façon plus proactive à la création des annonces). La plateforme ne dit pas que ces contrôles comparent une retouche à sa photo source. Si le dossier d’un acheteur montre un article « materially different from your listing » (substantiellement différent de votre annonce), le vendeur « may be responsible for refunding the buyer » (peut être tenu de rembourser l’acheteur).
Si le schéma de l’article vaut hors du mobilier, les vêtements sont un cas plus difficile. Six retouches de canapés rejetées sur dix ont échoué sur la géométrie (tableau A.1), un défaut que les auteurs classent comme grossier. La détection de défauts plus fins de texture, de couleur ou de matière reste « close to chance across the board » (proche du hasard sur toute la ligne), rapportent-ils. Le guide QA de Photoroom avance lui-même : « Fashion images present more fidelity risk per pixel than most product categories. » (Les images de mode présentent plus de risque de fidélité par pixel que la plupart des catégories de produits.)
La principale objection est qu’aucune place de marché ne contrôlerait ses photos avec un modèle généraliste et un prompt. Les évaluateurs de Photoroom sont des modèles propres à une catégorie, « available today for food and fashion » (disponibles aujourd’hui pour l’alimentaire et la mode), et les échecs persistants parviennent à une personne « with a confidence score » (avec un score de confiance). L’unique modèle ajusté de V-CAPE n’a vu que 55 exemples. Pour que la thèse tombe, un évaluateur conçu sur mesure doit être d’accord avec des relecteurs formés aussi souvent qu’ils le sont entre eux, et savoir quand il doute.
Les publications de Photoroom ne rapportent aucun test de ce genre, et son guide qualifie toujours la revue humaine de « the exception path, not the default » (la voie d’exception, pas la voie par défaut). Dans sa version la plus forte, l’objection repousse les humains en bout de chaîne, où ce sont toujours eux qui décident.
La revue ne disparaît pas quand une machine ne sait pas la faire ; elle se déplace. Une place de marché peut payer des personnes pour comparer les images avant la mise en ligne d’une annonce. Ou laisser les acheteurs comparer le colis à la photo, comme le font aujourd’hui les règles d’Etsy. Si les machines restent là où V-CAPE les a trouvées, le relecteur le moins cher est le client, et la facture du vendeur arrive sous forme de remboursement.