La recherche de vêtements obtient 0,87 en classement. Interrogée sur la proximité de chaque résultat, elle tombe à 51 %.
Un benchmark conçu par des chercheurs de Glance montre que des modèles de recherche prêts à l'emploi atteignent jusqu'à 0,87 pour classer de courtes listes de produits d'un catalogue, mais n'évaluent correctement la proximité de chaque produit avec une requête qu'environ une fois sur deux. Selon nos calculs, un modèle incapable de distinguer un produit de sa variante proche les battrait tous sur la mesure de classement : les distributeurs devraient donc demander à leurs fournisseurs des scores par variante et par attribut, sur leurs propres catalogues.
Neritus Vale
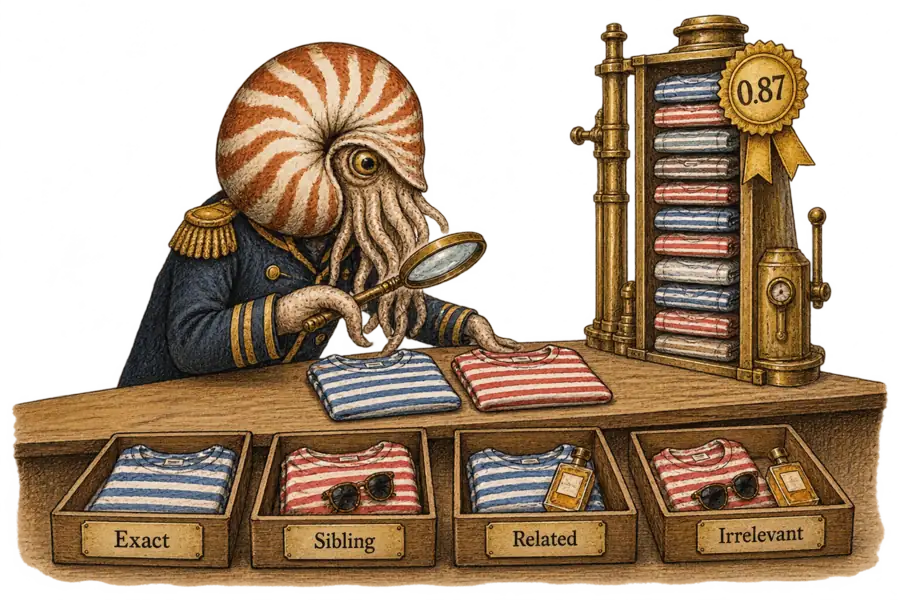
Les scores de classement flattent la recherche de vêtements : un modèle peut obtenir 0,87 sur la mesure standard tout en jugeant mal la proximité des produits dans environ la moitié des cas. FASHION-RQ, un benchmark publié sur arXiv le 13 octobre, rapporte les deux résultats pour les mêmes dix modèles de recherche textuelle prêts à l’emploi. Le score de classement récompense le fait de placer la bonne famille de produits en tête d’une courte liste. Or la recherche de vêtements doit trancher : chaque article est-il la correspondance exacte, une variante proche ou simplement un article apparenté ? C’est ce que mesure la notation.
Six chercheurs de Glance ont construit le benchmark à partir de la structure propre d’un catalogue, sans qu’aucune personne n’évalue la pertinence. L’application de Glance, d’après TechCrunch, habille un avatar généré par IA du client avec des tenues et perçoit des commissions d’affiliation. Le catalogue, un jeu de données Kaggle public que les auteurs attribuent à Myntra, compte 44 446 produits, des chemises aux parfums. Un modèle range chaque produit sous un code en trois parties, du plus grossier au plus fin, comme ceux que détaillent les systèmes de recommandation génératifs. Gemini a rédigé les requêtes qu’« un vrai client taperait » pour chaque groupe. Les niveaux de pertinence découlent du code : un article qui partage les trois parties est exact, celui qui partage les deux premières est un produit frère (« sibling »), celui qui ne partage que la première est apparenté, et aucune partie commune signifie hors sujet.
Les produits frères sont les quasi-réussites du vêtement. L’entraînement a orienté la deuxième partie vers le type de produit et la troisième vers des attributs comme la couleur, le genre, la saison et le niveau de prix. Dans l’arbre du schéma, un T-shirt rouge se trouve à côté du bleu que le client a demandé. Notre lecture : un produit frère est généralement le bon vêtement dans la mauvaise version.
Sur la mesure de classement, chaque requête mobilisait une quinzaine de produits, dont environ la moitié notés simplement apparentés ou hors sujet, et le nDCG@10 évalue les dix premiers. L’article ne précise pas la fonction de gain ; d’après nos calculs, un tirage aléatoire d’un tel lot obtient entre 0,55 et 0,62 selon la convention retenue. Un modèle qui ordonnerait parfaitement les niveaux, sauf qu’il confondrait correspondances exactes et produits frères, obtiendrait entre 0,89 et 0,95.
Ce modèle, incapable de distinguer le T-shirt bleu du rouge, battrait sur cette mesure tous les systèmes de l’article.
La tâche de notation supprime ce coussin, car une quasi-réussite ne rapporte rien. Chaque requête comportait environ huit produits, répartis à parts égales entre les quatre niveaux : au hasard, on tombe juste une fois sur quatre. Le meilleur modèle, Qwen3-Embedding-4B, a noté correctement 51 % des produits. L’article ne dit pas comment les scores de similarité ont été convertis en niveaux.
Le test des produits frères isole la partie difficile. Chaque requête oppose un produit correct à trois ou quatre de ses frères, et le score vérifie s’il se classe parmi les trois premiers sur cinq. Un tirage aléatoire de cinq y parvient 60 % du temps. Le vainqueur, à 83 %, SPLADE++, est un modèle parcimonieux construit sur BERT pour la recherche générale de passages. Le modèle d’embedding 4B de Qwen a légèrement devancé son grand frère 8B sur ce test, alors que le 8B arrive en tête du score de pertinence pondéré de l’article : la taille n’a donc pas aidé de façon constante. L’article indique rapporter des scores @1 ici, mais le tableau 2 ne montre que le @3.
Les scores par attribut montrent où se situent les erreurs. Le type de produit et le genre, que le catalogue consigne dans des champs structurés, dépassent 0,93 pour les modèles les plus performants. La matière a dû être extraite de textes libres et plafonne autour de 0,52. Ce sont des scores de correspondance, pas des taux de réussite : une teinte voisine rapporte un crédit partiel. Le style a à peine bougé d’un modèle à l’autre sur les dix, même pour un modèle jamais entraîné à la recherche, si bien que cette colonne reflète probablement la notation.
La clé de correction demande la même lecture, car la pertinence se réduit à ce que le modèle de codage a regroupé. Un cluster était conservé si au moins quatre de ses articles sur cinq partageaient un type de produit. Chaque article d’un cluster conservé compte comme exact pour toutes ses requêtes, et la consigne demandait une requête distincte par type de produit principal. Une requête visant un type peut donc compter les autres types comme exacts. Le tableau de l’article lui-même donne une pureté de couleur pondérée de 87,9 % pour une taille de codebook de 64. Les auteurs concèdent que la structure dérivée « approche les jugements humains sans les remplacer ».
L’étude humaine a vérifié les requêtes, pas les niveaux. Trente-deux évaluateurs ont noté 20 requêtes issues de chacune de trois sources : le benchmark, un LLM générique et de vrais clients. Les requêtes réelles, étiquetées CHAT, provenaient d’une source non nommée et avaient été filtrées en partie par des LLM jugeant l’intention par vote.
Les requêtes du benchmark étaient comparables aux vraies pour le naturel et les dépassaient pour la clarté de l’intention, 3,91 contre 2,83 sur une échelle de cinq. Les auteurs y voient un appui à la « validité pour une évaluation en conditions réelles ». Cet écart mesure aussi la distance entre le test et la recherche réelle, où la requête la moins bien notée de l’étude, à 1,66, était « Dark green pieces. » Comme les requêtes réelles ont été filtrées sur l’intention, 2,83 flatte peut-être la recherche réelle.
La principale objection est que les 51 % mettent en cause la clé de correction, pas les modèles. Personne n’a vérifié les clusters : même un modèle sans faille serait en désaccord avec certains niveaux. Une notation stricte en quatre catégories sanctionne chaque désaccord pleinement, là où une mesure de classement pardonne une quasi-réussite. Pour que la thèse tombe, il faudrait que le score de classement décrive ce que voit un client dans une boutique réelle.
Ce n’est pas le cas, et l’argument du bruit vaut dans les deux sens. Un catalogue réel ne fournit pas à un modèle quinze candidats dont la moitié viennent d’autres branches : il lui donne tous les T-shirts en stock. Le test des produits frères, lui aussi un classement, se rapproche le plus de ce cadre. Si les niveaux sont trop approximatifs pour noter les choix de variantes d’un modèle, ils le sont trop pour certifier son 0,87.
Les distributeurs peuvent s’inspirer de la conception du benchmark avant que quiconque puisse le reproduire : le code et les données n’arrivent que « à l’acceptation ». Ils peuvent demander à leurs fournisseurs la précision par produit frère et par attribut sur leur propre catalogue, face à des niveaux vérifiés par un merchandiser, ainsi que la fréquence à laquelle le bon article arrive en premier. Un fournisseur qui cite un nDCG sur une courte liste indique seulement dans quelle mesure son modèle évite le mauvais rayon. Les distributeurs peuvent s’en contenter, ou demander quelle chemise du bon rayon leur client reçoit.