Grisez les packs : un acheteur IA donne encore 45 % de sa probabilité au « A »
Un article co-signé par Intellicia, un vendeur coréen de consommateurs synthétiques, constate que des acheteurs IA construits à partir de dossiers de ménages reproduisent les paniers d'épicerie à peu près aussi bien que les propres courses passées de ces ménages. Face à un seul rayon, les mêmes modèles favorisent la lettre A et certaines positions dans l'image. Le correctif est évalué surtout par rapport aux préférences des modèles eux-mêmes, et chaque rayon est présenté comme celui d'un supermarché.
Neritus Vale
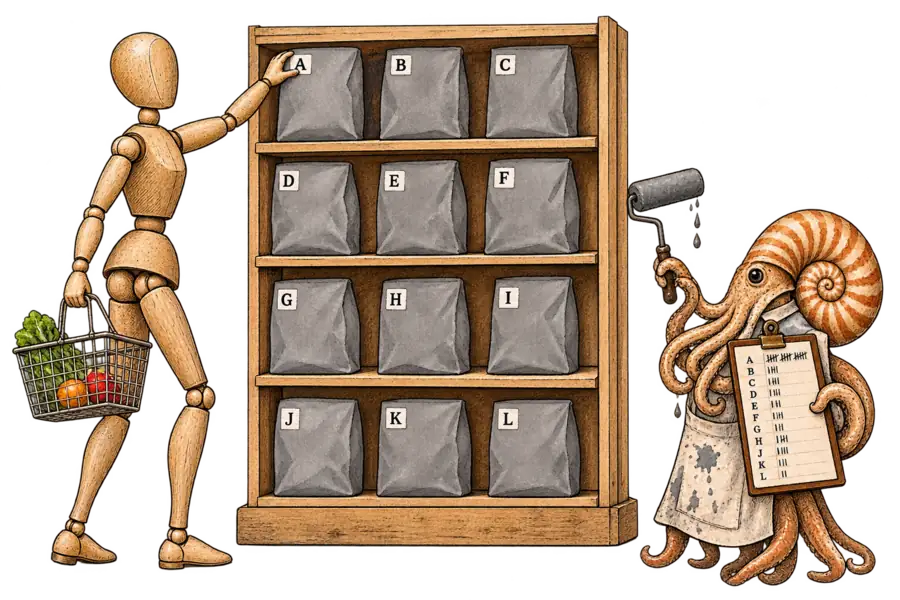
Même avec les produits étiquetés des vraies photos de rayon peints en gris, Qwen3.8-Flash a placé 45,3 % de sa probabilité de réponse sur celui marqué A. Ce résultat vient d’un article de validation co-signé par un vendeur de consommateurs synthétiques. Ses acheteurs IA reproduisent les paniers d’épicerie en agrégat, mais un choix isolé devant un rayon, l’unité d’un test de packaging, note la feuille de réponses autant que le produit.
Deux des trois auteurs, Woongki Kim et Seungkook Baek, travaillent chez Intellicia, une start-up coréenne ; l’auteur correspondant, Minhyeok Lee, est à l’université Chung-Ang. Un programme public, Deep-Tech TIPS, a financé les travaux. Le site d’Intellicia vend des enquêtes auxquelles répondent des consommateurs synthétiques, à partir de 1,2 million de ₩ par projet. L’article ne dit jamais ce qu’Intellicia vend.
Parmi les partenaires d’Intellicia figure BGF Retail, qui exploite les supérettes CU en Corée. En juillet, les deux sociétés ont signé un protocole d’accord pour utiliser ParaStore, le logiciel de jumeau numérique d’Intellicia, afin de « simuler l’implantation des produits, les déplacements des clients et le merchandising » ; Baek, son directeur général, assistait à la signature. Les acheteurs de l’article ont parcouru un magasin dans TwinStore, que Lee a construit sur ParaStore.
Chaque acheteur a été affecté au hasard à Claude Haiku 5.5, Qwen3.8-Flash ou GPT-6 Luna. Le modèle planifiait le trajet à partir d’un plan du magasin et choisissait les produits sur des images de rayon. Certains acheteurs étaient construits à partir de dossiers de ménages ; les acheteurs russes et taïwanais ne disposaient que d’une description du client. Leurs achats ont été confrontés à six jeux de données publics venus des États-Unis, de Russie et de Taïwan.
Le résultat phare est une parité avec la mémoire. Sur le taux de réussite retenu par l’article, c’est-à-dire la fréquence à laquelle les catégories d’un panier réapparaissent dans les courses ultérieures d’un ménage, les paniers synthétiques obtiennent 0,291, au niveau des propres courses antérieures des ménages. Sur cette mesure, la barre est plus basse qu’il n’y paraît. Une liste tirée des mêmes taux d’achat, sans aucun modèle, atteint 0,307. La liste rejoue les dossiers par construction, alors que les modèles ne les reçoivent que comme des suggestions.
Le « deux fois plus fortement » du résumé, une comparaison avec une régression entraînée, est le rapport de deux corrélations faibles. La mesure corrèle l’écart de la part de chaque catégorie, pour chaque groupe démographique, par rapport à la moyenne, dans les achats synthétiques et réels. Avec seulement des moyennes par tranche d’âge, les acheteurs synthétiques atteignent environ 0,28, ce qui laisse l’essentiel du schéma de groupe inexpliqué. Le même tableau place la liste des taux à 0,16 sur les différences entre groupes : ici, les modèles font mieux que la liste simple.
À l’étranger, sans ajustement, les acheteurs ont reproduit certains schémas réels et en ont manqué d’autres. Les groupes synthétiques ont suivi les achats d’alcool plus élevés des hommes et des clients d’âge moyen en Russie, avec une corrélation de 0,56, et ont presque égalé le surplus que les clients éloignés de Taïwan achètent par passage. Le texte principal rapporte une seule mesure par marché. Un tableau en annexe montre ces mêmes acheteurs russes se trompant du tout au tout sur les achats de marques propres, à −0,81.
Chaque rayon testé par l’article est présenté au modèle comme un rayon de supermarché, et aucune de ses 24 catégories de produits n’est du vêtement.
Le benchmark de l’article, ShelfSight, fait tourner 12 produits sur chaque position d’un meuble de rayon et les étiquette de A à L, dans l’ordre de lecture, inversé ou aléatoire. Un modèle factoriel décompose chaque choix en un effet produit et deux « effets de réponse », pour la lettre et pour la position.
Les auteurs énoncent le risque : « Un test de packaging synthétique qui lit ces réponses au pied de la lettre crédite un nouveau pack de l’avantage de son emplacement en rayon et de sa lettre. » Sur des rayons rendus en image de synthèse, la lettre A a multiplié par 8,8 les chances de GPT-6 Luna de choisir un article, par rapport à une lettre moyenne à la même position. Relabelliser le rayon de M à X a montré que l’effet tient à la lettre A elle-même. Sur des photos réelles, par la même conversion, le coefficient de GPT-6 Luna implique environ 25 fois, là encore par rapport à une lettre moyenne.
Sur les rayons rendus en synthèse, les trois modèles hébergés préfèrent aussi le haut de l’image. Ils favorisent l’étagère du haut par rapport à celle du bas à hauteur de 0,66 à 1,18 log-odds. Si l’on retourne l’image, deux d’entre eux, Qwen3.8-Flash et Claude Haiku 5.5, favorisent alors l’étagère physiquement la plus basse.
Les deux petits modèles ouverts du benchmark penchent dans l’autre sens, vers l’étagère du bas, à −0,32 et −0,54. L’attrait du haut est une habitude des modèles hébergés, pas de tous les modèles testés.
Les personnes qui choisissent à partir de photos de rayon affichent 0,11, que l’article marque comme non significatif ; il provient d’une seule étude. Dans une liste textuelle, Claude Haiku 5.5 et GPT-6 Luna ne favorisent l’étagère du haut que lorsqu’elle vient en premier, une habitude de première position que nous avons signalée chez d’autres modèles dans des présélections purement textuelles.
La correction doit être calibrée sur le même type d’image. Les effets estimés sur les rayons rendus de ShelfSight n’ont ramené la part de la première lettre de Qwen3.8-Flash sur les photos grisées qu’à 31,5 %. Les rendus du benchmark ne se transposent aux photographies que partiellement. Des copies masquées d’autres photos réelles ont fait mieux, la ramenant à 13,9 %.
Sur les photos masquées, A est resté au-dessus des 9,0 % qu’un choix uniforme donnerait, alors que sur les photos non masquées le même correctif les a presque atteints. L’article ne rapporte le résultat sur photos que pour Qwen3.8-Flash, pas pour GPT-6 Luna, le modèle le plus attiré par A. Claude Haiku 5.5 n’a rendu de réponses valides que sur 7 % à 17 % des rayons en photos réelles.
Sur les rayons rendus en synthèse, la correction est évaluée par rapport au modèle lui-même. Sa référence est constituée des effets produit que le modèle a montrés sur les 35 autres rendus, et aucun acheteur n’a choisi dans ces rayons. Les effets de position reviennent par un a priori ajusté sur cinq effets d’attention publiés chez l’humain : « L’a priori déplace les choix selon les positions en rayon, tandis que les préférences de produit viennent toujours du modèle. » Un test de packaging lit donc soit le goût du modèle pour une place dans l’image, soit, une fois corrigé, l’effet de position que fournit l’a priori.
Intellicia présente les réponses synthétiques comme plus objectives que celles des humains. Sa page d’accueil promet une recherche « plus rapide, plus objective », affirme que les enquêtes classiques exagèrent (과장 편향) et affiche en titre une corrélation de 91,2 %. Selon le propre récit de l’entreprise, ce chiffre provient d’enquêtes sur les surgelés et les assaisonnements (냉동식품·조미료) et ne dit rien des choix en rayon.
La meilleure défense est que les panels synthétiques servent à trier, pas à décider. L’article de TwinStore dit que la plateforme est conçue pour « trier les alternatives et affiner les hypothèses » avant des tests auprès de vrais clients. La page de référence d’Intellicia qualifie la recherche synthétique de complément plutôt que de remplacement complet (완전한 대체가 아닌 보완), précise qu’elle ne remplace pas les recherches qui exigent un fondement réglementaire ou clinique, et recommande une validation hybride au besoin. La thèse tombe si les erreurs d’un tri n’apparaissent que lorsque de vrais acheteurs rencontrent les finalistes.
Seules certaines erreurs peuvent apparaître, car les options qu’un tri écarte à tort ne sont jamais testées. Un responsable du commerce cité dans un reportage du Korea Herald repris par The Star s’attend à ce que l’IA « élimine les concepts les plus faibles ». Un pack éliminé à cause de son emplacement ou de son étiquette ne rencontre jamais de vrai acheteur ; pour le repérer, il faut des photos masquées, des étiquettes permutées et des réponses répétées.
Si les simulations de CU, ou de n’importe qui, prennent les choix isolés en rayon au pied de la lettre, un pack peut gagner son emplacement grâce à sa place et à sa lettre, sans aucun acheteur derrière le choix. Pour l’habillement, l’article n’apporte aucune preuve, dans un sens ou dans l’autre. Il offre en revanche un test peu coûteux pour le panel de n’importe quel fournisseur : grisez les packs et comptez les A.