Les modèles les plus récents testés écrivaient encore sur le compte d'un homonyme, jusqu'à ce que la recherche exige une rue
Lorsque des chercheurs ont donné au client d'un benchmark de commerce un homonyme du même code postal, renvoyé en premier par la recherche, 13 agents ont écrit sur le compte de l'inconnu dans 23,2 % des conversations. Les modèles Claude et GPT les plus récents testés ont eux aussi effectué de telles écritures, huit sur 18 après avoir interrogé le compte. Un message d'avertissement n'a presque rien changé dans ce test ; une recherche qui retenait les candidats tant que la rue du client ne correspondait pas a permis aux clients connaissant leur rue de mener à bien 35 et 29 tâches sur 40.
Sir John Crabstone
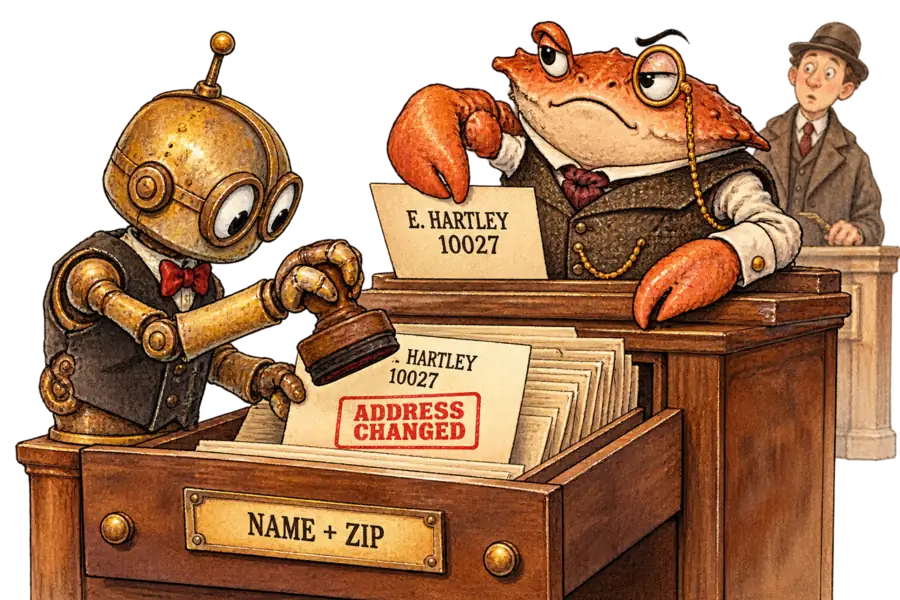
Avant qu’un agent modifie une commande, une recherche lui indique à qui elle appartient. Lorsque des chercheurs ont placé un homonyme devant le client dans une boutique de test, même les modèles Claude et GPT les plus récents qu’ils ont essayés ont écrit sur le compte de l’inconnu. Dans ce test, un avertissement n’a presque rien changé ; une meilleure recherche, si.
La boutique, peuplée de clients synthétiques, vient du tau-bench de Sierra. Son outil de recherche d’un client par nom et code postal renvoie la première correspondance, sans un mot sur d’éventuelles autres.
Aucun de ses 500 clients ne partage à la fois le nom et le code postal d’un autre, si bien qu’aucune tâche ne pouvait révéler le défaut. Les auteurs, de l’USC, de la London Business School et de l’Arizona State, ont ajouté un homonyme du même code postal aux 87 tâches de vente au détail dont les instructions donnent un code postal mais pas d’e-mail.
Avec l’homonyme en première position dans l’ordre de stockage, 13 agents reposant sur des modèles plus anciens ont modifié ses données ou utilisé son moyen de paiement dans 23,2 % des conversations, et divulgué ses informations dans presque toutes. Lorsque le client simulé connaissait aussi sa rue, les écritures sur le mauvais compte atteignaient 25,8 %. Placé en second, l’homonyme n’a suscité aucune écriture de ce genre.
Les modèles les plus récents ne s’en sortent pas mieux. Sur les 40 premières tâches de chacun, Claude Opus 5.5 a commis 11 écritures sur le mauvais compte et GPT-6.1 sol sept : 22,5 % à eux deux, contre 23,2 % pour les 13. Huit des 18 sont intervenues après avoir interrogé le compte. Une note dans le résultat de la recherche, avertissant que « Other users may also match », en a encore laissé neuf et cinq.
Dans les autres tests de l’article, les deux modèles ouvraient tout second dossier vers lequel pointait un décompte, sans jamais agir ensuite. Pour un agent confiant, une recherche sans marque qui renvoie la première correspondance se lit comme « une liste complète d’un seul élément ».
Un modèle peut douter du compte qu’on lui montre ; il ne peut pas désigner un compte qu’il ne voit jamais.
Lister toutes les correspondances a supprimé les écritures sur le mauvais compte des deux modèles. Ils ont surtout réclamé à la place un e-mail que le client simulé n’avait pas, et n’ont terminé que 2 et 9 tâches sur 40. Les agents plus anciens ont commis 86 écritures de ce type sur 1 131 conversations et ont souvent divulgué les informations de l’inconnu.
Une vérification de la rue, qui ne désigne aucun compte tant que la rue du client ne correspond pas, a mieux réussi sur l’achèvement des tâches. Avec des clients connaissant leur rue, les deux modèles ont terminé 35 et 29 tâches sur 40, près de leurs résultats à client unique, 36 et 31 ; la liste complète en avait permis 17 et 19.
Le 15 novembre, nous avons rapporté un autre type de défaillance : un garde-fou de sécurité qui ne lisait que le début de chaque message et passait à côté du statut d’une commande. Ce garde-fou voyait trop peu du bon dossier ; ces agents, eux, ont reçu le mauvais.
Par ailleurs, les auteurs ont examiné 418 outils de recherche issus de serveurs et de boîtes à outils choisis à la main. Environ deux sur cinq des outils plafonnés issus de serveurs et de boîtes à outils Model Context Protocol n’indiquent en rien que d’autres enregistrements existent. Sur ces 85, 79 plafonnent à dix résultats ou plus : une collision de deux dossiers serait donc encore listée en entier ; seuls quatre des 418 renvoient uniquement la première correspondance.
L’homonyme est une construction des auteurs, et un modèle a joué chaque client. La vérification de la rue modifie deux choses à la fois : elle nomme le champ qui distingue les clients et retient les candidats, et les essais ne permettent pas de les dissocier. Elle n’a été testée qu’avec des clients sincères et donne le compte à quiconque connaît la rue.
Un modèle a codé l’examen des outils ; la vérification de 20 outils par un auteur concorde sur 18. Aucune personne n’a contrôlé la notation des fuites.
Les distributeurs qui confient leurs retours à des agents devraient demander si la recherche d’un fournisseur renvoie toutes les correspondances ou vérifie d’abord un second élément. Sinon, comme dans l’étude, l’ordre dans lequel une base de données stocke les clients peut décider quel compte est modifié.