« Même manteau, mais en olive » : une requête que le score de pertinence ne sait pas noter
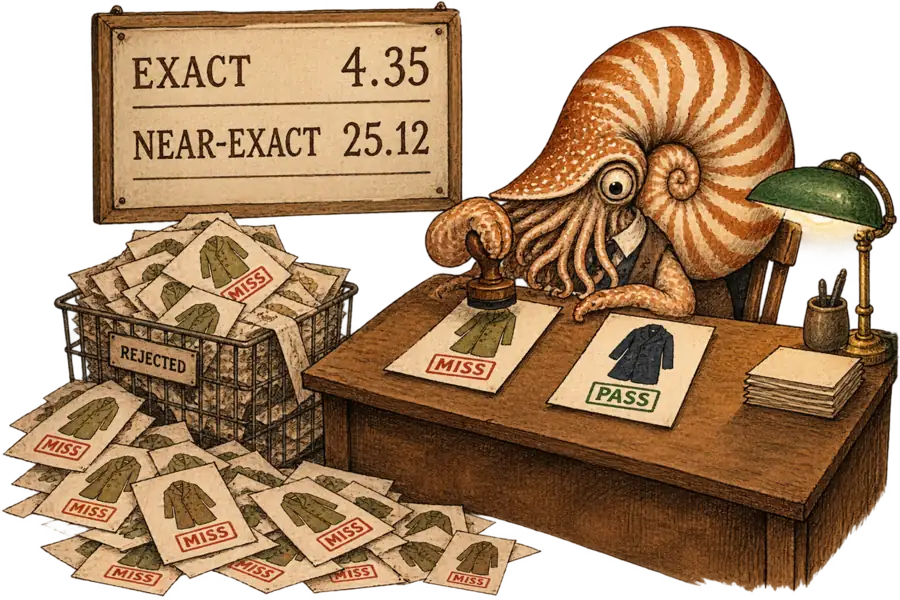
Dans les données annotées par Walmart lui-même, une requête à modificateur comme « même manteau, mais en olive » obtient 4,35 réponses exactes et 25,12 quasi-exactes — et le Recall@K, le chiffre sur lequel ces systèmes sont classés, compte chaque quasi-exacte comme un échec. Les distributeurs achètent leurs systèmes de recherche visuelle en fonction d'une métrique aveugle au résultat le plus susceptible de conclure la vente.
Admiral Neritus Vale
Un acheteur qui photographie un manteau et tape « pareil, mais en olive » pose une question à laquelle la plupart des catalogues ne peuvent pas répondre exactement. Dans le lot de candidats que Walmart a annoté pour ses propres requêtes de mode avec modificateur, la requête moyenne compte 4,35 correspondances exactes et 25,12 quasi-exactes, une quasi-exacte étant un article qui « satisfait entièrement l’intention derrière la requête » tout en différant sur une spécification mineure. Le Recall@K, le chiffre phare des benchmarks sur lesquels ces systèmes sont comparés, compte chacune de ces quasi-exactes comme un échec. Les distributeurs choisissent leurs systèmes de recherche en fonction d’une métrique aveugle à leur réponse correcte la plus fréquente.
Ces chiffres proviennent de GradCIR, publié sur arXiv le 21 septembre par une équipe de Walmart qui l’a depuis déployé comme socle de recherche pour la recherche visuelle de l’entreprise. Le reproche qu’il formule est structurel. Les méthodes existantes de recherche composée « traitent la pertinence comme binaire et s’entraînent sur des triplets avec une seule cible positive », une simplification acceptable pour un jeu de données de recherche mais une piètre description d’un catalogue que l’article dit contenir des centaines de millions d’articles. La recherche d’image composée est le nom technique de la requête à modificateur : une image plus une instruction textuelle, ce qu’exécute l’icône appareil photo d’une barre de recherche dès qu’un acheteur tape quoi que ce soit. Google Lens traite à lui seul près de 20 milliards de recherches visuelles par mois, ce qui fait de la convention d’annotation sous-jacente à ces systèmes une question commerciale.
La rareté des correspondances exactes est une propriété de la requête, pas du catalogue. Un acheteur recourt à un modificateur parce que ce qu’il avait en tête ne figure pas sur la page ; le modificateur est la trace d’une recherche déjà infructueuse une première fois. Les chiffres de Walmart suivent cette logique : les correspondances exactes tombent de 6,03 par requête en recherche par similarité simple à 4,35 dès qu’un modificateur est ajouté, tandis que la bande des quasi-exactes s’élargit pour absorber la différence. Plus la demande est difficile, plus la bonne réponse migre vers la bande que la métrique note comme nulle.
La pertinence binaire ne sous-compte pas le quasi-résultat : elle le classe avec l’erreur.
Entraîner le modèle sur les notes plutôt que sur le binaire produit un gain mesurable, qui se concentre là où les requêtes sont les plus difficiles. Sur le propre benchmark noté de Walmart, la même architecture, supervisée sur quatre niveaux de pertinence plutôt que deux, fait passer le NDCG@10 des requêtes à modificateur de 0,8376 à 0,8875 — un progrès plus marqué que celui obtenu sur la recherche par similarité simple. L’explication de l’article en est la phrase la plus utile : « Réduire ces quatre cas à un schéma d’annotation binaire fait disparaître l’information qui rend un classement de recherche utile. » Ce que la supervision binaire jette, c’est l’ordre — et l’ordre est la seule chose qu’est une page de résultats.
La preuve la plus nette que la métrique est aveugle se trouve dans l’autre tableau du même article. Sur FashionIQ, le benchmark public sur lequel la recherche composée supervisée est encore classée, GradCIR affiche un rappel moyen de 0,6703 contre 0,6641 pour la meilleure référence évaluée par les pairs qu’il cite. Six dixièmes de point, c’est toute la distance visible entre les deux meilleurs systèmes supervisés de la littérature publiée — une résolution plus fine que ce dont une décision d’achat a besoin. GradCIR pointe un second problème avec les chiffres publics : CIRR et CIRCO puisent leurs images dans NLVR2 et COCO, si bien qu’un système de recherche entraîné sur de la photographie de catalogue est hors distribution avant même que sa première requête ne soit évaluée.
Pinterest est arrivé à la même conclusion par l’autre bout de l’entonnoir. PinPoint, accepté à CVPR 2026 et rédigé par six chercheurs de Pinterest, a annoté 7 635 requêtes composées avec des jugements vérifiés par des humains et a trouvé une moyenne de 9,1 réponses correctes par requête. C’est le plus grand benchmark multi-réponses vérifié par des humains jamais construit pour la recherche composée. Deux entreprises qui ne partagent rien d’autre qu’une icône appareil photo et un très large catalogue sont arrivées, indépendamment, à la même conclusion : c’est la convention d’annotation, pas le modèle, qui constitue la contrainte réelle.
L’objection n’est pas nouvelle, et c’est ce qui devrait inquiéter les acheteurs. CIRCO, présenté à l’ICCV 2023, avait déjà relevé « plusieurs faux négatifs » dans CIRR, reconstruit l’évaluation avec une moyenne de 4,53 vérités terrain par requête, et abandonné le Recall@K au profit de la précision moyenne (mean average precision). Trois ans plus tard, les classements continuent de rapporter le Recall@K. Un classement est un dispositif de coordination, et le coût d’en sortir retombe entièrement sur celui qui part le premier.
Le meilleur argument pour ne pas toucher à la métrique est que sa cécité pourrait être sans conséquence. Si les systèmes entraînés en binaire et ceux entraînés sur des notes ordonnent le haut de la page de la même façon, le Recall@K est un indicateur bruité plutôt que biaisé, et un distributeur qui s’y fie perd en précision de comparaison mais pas le système qu’il voulait. Le tableau de Walmart répond directement à cela : l’écart entre supervision binaire et supervision notée est le plus large sur les requêtes à modificateur, précisément le cas où les correspondances exactes sont les plus rares et où le problème de classement est réel. Un indicateur dont l’erreur croît avec la difficulté de la requête favorise le système le plus performant sur la requête qu’un acheteur aurait tout aussi bien pu taper dans un filtre.
Les annotations dont un distributeur a besoin dorment déjà dans son propre catalogue. Walmart a construit 3,5 millions de paires d’entraînement notées sans aucune annotation manuelle, en utilisant un modèle vision-langage pour noter son propre assortiment face à ses propres requêtes — ce qui fait passer l’évaluation notée d’un programme de recherche à une simple ligne de calcul. Si cette capacité reste cantonnée à la poignée de distributeurs assez grands pour bâtir leur propre système de recherche, et n’atteint jamais la grille d’évaluation des fournisseurs, les acheteurs continueront de choisir des systèmes qui récompensent un catalogue contenant un doublon et pénalisent celui qui contient un bon substitut. La quasi-exacte, c’est le résultat qui vend le manteau dans une couleur à laquelle l’acheteur n’avait pas pensé — et l’inscrire dans le cahier des charges relève d’une clause de contrat, pas d’un problème de recherche.