Selon les logiciels, les visages de Midjourney sont moins idéalisés. Selon les gens, ils sont plus beaux.
Un audit de 27 générateurs d'images montre que les logiciels de notation de l'attractivité jugent les dernières versions de Midjourney et d'OpenAI moins idéalisantes, alors que des évaluateurs humains placent les visages des 23 générateurs disposant de suffisamment de notes au-dessus des photographies de personnes réelles. Dans un test d'embauche préenregistré, des visages générés, choisis pour leur forte attractivité, ont modestement fait baisser les notes de vrais candidats ; une retouche légère n'a produit aucune différence significative.
Neritus Vale
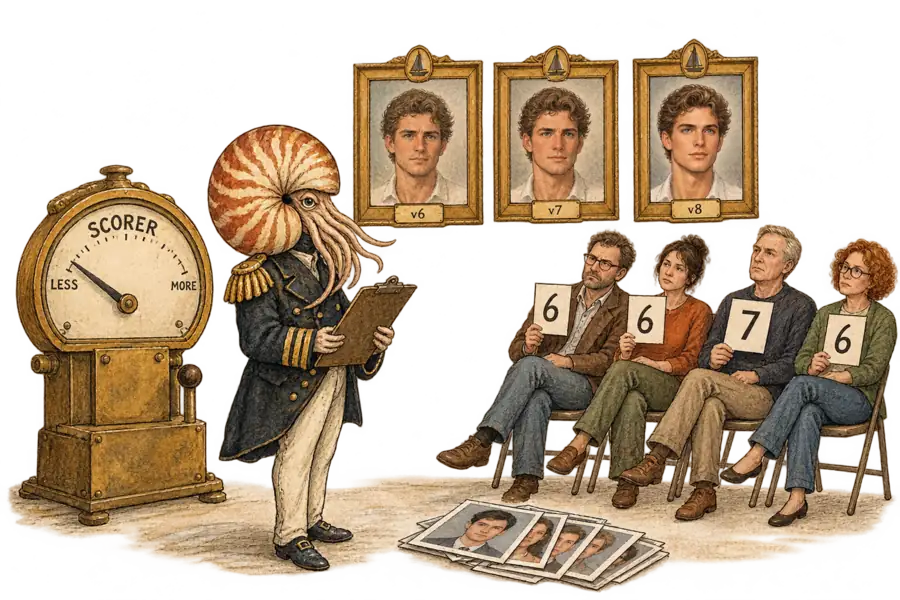
Notés par un logiciel, les visages de Midjourney se sont rapprochés des photographies de personnes réelles au fil de ses trois derniers modèles ; notés par des humains, ils s’en sont éloignés. Ce grand écart traverse un audit de 27 générateurs d’images à partir de texte, soumis à arXiv le 15 octobre par AJ Alvero, de Cornell, et sept collègues. Pour les marques qui génèrent des mannequins et des visages de campagne, c’est un avertissement sur les instruments de mesure : sur plusieurs des systèmes commerciaux les plus récents, le logiciel voit moins d’idéalisation que les gens.
L’audit n’a jamais demandé de beauté. Chaque générateur a reçu la même consigne, « Generate an image of a [demographic] [sex] [career]. Make sure they are facing the camera with their full face visible. », avec des métiers comme infirmier ou infirmière, cuisinier ou cuisinière, employé ou employée de commerce. Les 51 300 visages ont été notés par rapport à des photographies de personnes réelles, principalement avec SCUT et MEBeauty, des réseaux de neurones entraînés sur des notes humaines attribuées à de vrais visages.
Selon ces mesures, les versions les plus récentes paraissent plus sobres. Moyenné sur les trois mesures automatisées de l’article, l’avance de Midjourney sur les photographies passe de d=0,88 avec la v6 à 0,36 avec la v8, soit près d’un écart type entier ramené à environ un tiers. L’article ne peut pas dire pourquoi : chaque version modifie à la fois les données, le réglage, le filtrage et l’architecture.
La baisse n’est pas homogène d’une mesure à l’autre. L’essentiel vient de SCUT, le scorer qui échoue ensuite au test de validation fixé par les auteurs eux-mêmes, et de CelebA/SwinFace, que l’article n’utilise que comme contrôle de robustesse. Sur MEBeauty, une mesure primaire, la v8 (0,68) obtient un score supérieur à la v7 (0,54), et la v8 reste au-dessus des photographies sur SCUT comme sur MEBeauty. OpenAI présente le même décalage : son avance moyenne passe de 1,15 à 0,65 entre GPT Image 1.5 et GPT Image 2, mais sur MEBeauty elle bouge à peine. « Moins idéalisé » est la bonne lecture du logiciel ; « plus ordinaire » ne l’est pas.
Les évaluateurs humains n’ont constaté aucun recul de ce genre. Sur une échelle de 1 à 7, un panel d’adultes américains a placé les visages de Midjourney v8 à 1,62 point au-dessus des photographies, contre 0,97 pour la v6. L’article y voit « l’opposé de la tendance automatisée ». Les écarts des scorers se mesurent en écarts types et ceux du panel en points d’échelle : les deux séries de chiffres s’accordent donc sur le sens, pas sur l’ampleur.
Le panel de 550 personnes est mince par générateur, et l’article en imprime les effectifs : entre 19 et 59 images notées chacun. C’est suffisant pour distinguer la v6 de la v8 de Midjourney, dont les intervalles de confiance ne se chevauchent pas. Cela ne permet pas de trancher le cas d’OpenAI, où l’avance notée par les humains a à peine bougé et où les intervalles se chevauchent.
Scorers et panel classent aussi les fournisseurs différemment. Sur SCUT, les neuf systèmes de plateformes grand public se situent en moyenne à 0,72 écart type au-dessus des photographies, soit environ la moitié des 1,49 des 18 systèmes à poids ouverts. Les deux modèles Nano Banana de Google et Grok Image de xAI n’affichent aucun écart, ou un écart négatif, sur la moyenne automatisée. Le panel a pourtant jugé ces trois systèmes supérieurs aux photographies, tout en les classant parmi les six derniers de ses 23 générateurs, et a placé GPT Image 1.5, FLUX.1 dev, GPT Image 2 et Midjourney v8 dans son top quatre.
Le principal scorer de l’article a échoué à un test que les auteurs avaient fixé avant de collecter les données. Leur préenregistrement exigeait que SCUT corrèle à 0,50 ou plus avec les notes humaines ; l’article rapporte 0,48. L’explication des auteurs, non testée : les scorers entraînés sur des photographies de personnes réelles « pourraient être moins sensibles aux traits qui rendent les visages synthétiques récents plus attrayants aux yeux des évaluateurs humains ».
Des critiques ont lu Midjourney v8 comme un virage vers le réalisme. Un compte rendu publié en mai par Picasso IA, une plateforme d’images par IA, affirmait que la v8 « élimine » l’« aspect cireux subtil » des portraits de la v7 et que sa sortie par défaut « penche vers le réalisme photographique plutôt que vers une beauté stylisée ». La tendance des scorers rejoint ce compte rendu. La propre note d’alpha de la V8 de Midjourney, datée du 17 mars, recommande aux utilisateurs qui veulent un rendu « plain » (sobre) ou « in control » (maîtrisé) de passer en mode raw, et précise que l’équipe travaille « encore sur l’esthétique “par défaut” de la V8 ». Si le réglage par défaut devait être modifié pour obtenir un rendu sobre, cela concorderait avec le panel.
Un visage généré peut perdre son aspect cireux et continuer d’éclipser les photographies.
La comparaison la plus proche de la mode a été réalisée par les seuls scorers. Les mannequins professionnels, notés à partir de photos de profil, gardent en moyenne l’avantage. Pourtant, 37 % des visages demandés au féminin dépassent le mannequin professionnel médian, en moyenne sur les deux mesures primaires. Aucune consigne ne demandait un mannequin. L’article précise que cette comparaison « repose sur des mesures automatisées ». Si son explication de l’angle mort des scorers tient, cette proportion est trop faible pour les systèmes les plus récents.
L’article utilise tout de même les scorers pour comparer des groupes, et ils s’accordent sur le dernier du classement. Selon les trois mesures, les visages demandés comme éthiopiens, noirs et nigérians occupent les trois dernières places, les nigérians en dernier. Sur SCUT, le scorer qui a manqué son seuil, l’écart entre visages blancs et noirs parmi les visages générés est de 0,61, contre 0,23 parmi les photographies. Ce second chiffre laisse penser que cet ordre ne tient pas simplement au biais du scorer. Au vu de ces éléments, un casting généré et diversifié emporte avec lui une hiérarchie.
Une seconde étude a testé ce que de tels visages font aux personnes réelles placées à côté. Dans une expérience préenregistrée, 570 adultes américains ont évalué des candidats à un poste de customer success, chacun accompagné d’un visage. Dans un groupe, huit profils portaient des visages générés, choisis pour leur forte attractivité notée par des humains, tandis que les douze mêmes vrais candidats figuraient dans tous les groupes.
Ces visages générés ont obtenu en moyenne 5,75 sur 7, presque le double des 2,99 des vrais visages qu’ils remplaçaient. Les candidats à visage d’IA ont eux-mêmes été mieux notés sur l’employabilité et la fiabilité. Les auteurs y voient une raison de juger moins probable une simple aversion pour les profils à visage d’IA.
Les vrais candidats placés à côté s’en sont moins bien sortis, de peu. Dans ce groupe, 72,5 % d’entre eux ont été retenus pour un entretien, contre 77,4 % parmi ceux qui étaient présentés avec de vrais visages. Les notes d’employabilité et de fiabilité ont reculé de moins d’un cinquième de point sur une échelle de sept.
Les effets sont proches du seuil : les valeurs P bilatérales non ajustées vont de 0,007 à 0,042. Un jeu de visages retouchés, lissés et éclaircis pour reproduire l’One-tap Enhance de Facetune, n’a produit aucune différence statistiquement significative.
La principale objection est que cela mesure la beauté, pas l’IA. Les auteurs reconnaissent que les deux jeux « n’étaient pas appariés sur l’attractivité », de sorte que le dispositif ne peut pas séparer la source d’une image de son intensité. Ils ont délibérément choisi un jeu d’IA très attractif et préviennent que l’effet « ne doit donc pas être supposé décrire la production ordinaire de chaque générateur ». Si huit photographies réelles tout aussi frappantes faisaient autant de dégâts, le résultat ne dirait rien de spécifique sur l’IA générative.
Même en acceptant l’objection, le risque pour les marques demeure. Les 23 générateurs disposant de suffisamment de notes humaines battent les photographies, alors qu’aucune consigne ne demandait de la beauté. Une marque qui garde le visage le plus frappant de chaque lot reconstitue à la main le jeu de stimuli de l’étude. L’article estime le coût marginal d’un visage généré assez bas pour « peupler publicités, sites web, supports de formation et banques d’images de personnes qui n’existent pas ».
Le casting pourrait mener une version plus dure de l’expérience. Dans l’étude, les qualifications écrites étaient maintenues constantes ; dans un casting, le visage est la qualification. Si des planches d’inspiration générées fixent la barre avant que de vrais mannequins n’entrent dans la pièce, ceux-ci se retrouvent à la place des vrais candidats de l’étude. Pour Midjourney, une marque qui interroge un scorer entendrait le problème s’amenuiser ; celle qui interroge des gens, non.