Target a publié sa pile de recherche, mais gardé les pondérations
Lors des tests en conditions réelles de Target, un modèle d'embeddings prêt à l'emploi a laissé la demande de recherche par visiteur 7,14 % sous celle de la seule recherche par mots-clés, tandis qu'un modèle entraîné sur les données de clics, de paniers et de commandes de Target l'a fait progresser de 1,10 %. L'article nomme les briques qu'un distributeur peut acheter et passe sous silence les réglages d'étiquetage et de fusion appris auprès des clients de Target.
Admiral Neritus Vale
Pendant quatre semaines, Target a ajouté un modèle d’embeddings prêt à l’emploi à sa recherche par mots-clés sur du trafic réel, et la demande par visiteur (valeur des commandes divisée par le nombre de visiteurs) s’est établie 7,14 % en dessous de celle de la recherche par mots-clés seule. Un modèle ultérieur, entraîné sur l’historique de ce que les clients de Target consultent, ajoutent au panier et achètent, puis fusionné avec les résultats par mots-clés selon des pondérations réglées sur le trafic de Target, s’est établi 1,10 % au-dessus. La comparaison regroupe plusieurs changements, et l’article ne précise pas quelle règle de fusion le test du modèle prêt à l’emploi utilisait. L’article qui rapporte les deux tests, soumis à arXiv le 25 septembre, nomme les briques qu’un distributeur peut acheter et passe sous silence les réglages appris auprès de ces clients : les pondérations et seuils des étiquettes, ainsi que les pondérations de fusion.
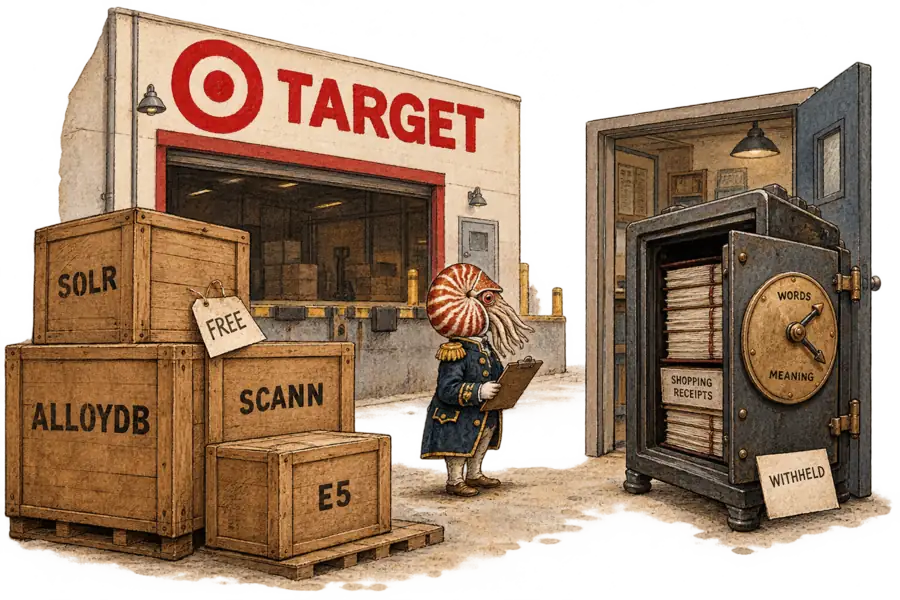
Dans Retail Product Search: A Practical Approach at Target, Darshan Sonagara, Qujiaheng Zhang, Ankit Singh et Alex Li, du groupe Data Sciences de Target, décrivent un système construit pour l’essentiel à partir de composants que n’importe qui peut télécharger ou louer. Apache Solr, un moteur open source, assure la recherche par mots-clés. Les vecteurs destinés à la recherche par le sens résident dans AlloyDB, la base de données de Google, indexés avec ScaNN, un type d’index d’AlloyDB. L’encodeur qui transforme les requêtes et les textes produits en ces vecteurs part de e5-small-v2, téléchargeable gratuitement sous licence MIT et assez petit pour tourner sur des serveurs CPU standard. Le chiffre de l’article sur les recherches sans résultat, une baisse d’environ 50 %, provient du test du modèle affiné déployé.
Les notes de confidentialité de l’article énumèrent ce que Target a gardé pour lui. Target ne publie que des gains relatifs, « conformément à la politique de l’entreprise », et passe sous silence les réglages qui transforment ses journaux en étiquettes d’entraînement. Les journaux, agrégés par requête et par produit plutôt que par personne, ont été sous-échantillonnés dans les catégories dominantes comme la maison et l’habillement afin de laisser de la place aux plus petites, puis filtrés pour aboutir à environ 20 millions de paires étiquetées. Une paire n’était jugée désirée que si son score hebdomadaire, qui pondère les commandes au-dessus des ajouts au panier et les ajouts au panier au-dessus des clics, se maintenait au-delà d’un seuil pendant plusieurs semaines. Les produits affichés pour une requête au moins un certain nombre de fois sans le moindre clic, ajout au panier ou commande devenaient des négatifs : selon les termes de l’article, « souvent montrés et systématiquement ignorés ».
Rien dans la liste des composants de l’article n’a vu ce que les clients de Target ont choisi et ce qu’ils ont ignoré.
La règle qui fusionne les deux listes de résultats a changé l’effet du premier modèle affiné sur les commandes. Avec la fusion par rang réciproque (RRF), qui promeut les produits classés par les deux listes, les résultats ont été mitigés : la demande par visiteur a progressé de 0,49 % et les ajouts au panier ont augmenté, mais les clics ont reculé et le taux de conversion en commande a chuté de 1,20 %. Les auteurs l’expliquent par le faible recouvrement des deux listes : l’accord que récompense la RRF était rarement au rendez-vous. L’entrelacement pondéré remplit chaque emplacement à partir d’une liste ou de l’autre, proportionnellement à un poids fixé. Target a réglé ces poids au fil de tests A/B successifs, en partant d’un partage égal, et ne communique pas les valeurs retenues.
Elastic et Google documentent tous deux la RRF comme moyen de fusionner résultats par mots-clés et résultats vectoriels. La documentation d’Elastic indique que la RRF « ne nécessite aucun réglage » et supprime « le besoin de déterminer la pondération appropriée par combinaison linéaire » des scores. La documentation AlloyDB de Google, pour la base qui héberge les vecteurs de Target, décrit la recherche hybride comme des recherches vectorielle et textuelle distinctes, dont les résultats sont ensuite « combinés et reclassés grâce à la fusion par rang réciproque (RRF) ». Sa requête d’exemple utilise la constante de 60 que Target a employée dans son propre test de RRF. L’affirmation d’Elastic porte sur le mélange de scores, un problème différent des parts de canal que Target a réglées. Les tests de Target opposent la RRF à l’entrelacement, et l’entrelacement s’en est mieux sorti sur la conversion en commande ; l’article ne compare pas des poids réglés à un partage égal.
Le premier modèle entraîné sur les données de Target avait déjà fait progresser la demande à peu près autant que le modèle final. Entrelacé avec les résultats par mots-clés, il a fait monter la demande par visiteur de 1,11 % et la conversion en commande de 0,74 %. Le modèle déployé y a ensuite ajouté des données d’entraînement élargies, des négatifs difficiles, des marqueurs de champs et des mises en avant de produits, entre autres changements. Les clics et la conversion ont encore progressé, tandis que la demande par visiteur est restée stable.
La recherche vectorielle exigeait aussi un filtre qui connaisse le catalogue de Target. Un module de contrôle de la précision écarte les résultats vectoriels qui contredisent le genre, la taille ou la marque cités dans une requête, ou le type d’article et la catégorie qu’un classificateur de requêtes en déduit. Sans filtres, la précision à dix était de 0,836 : environ un produit sur six parmi les dix premiers du canal vectoriel n’était donc pas un résultat souhaitable. Avec les deux jeux de filtres, la précision est montée à 0,885, soit environ un sur neuf. Les exemples de l’article viennent des serviettes de bain, de l’épicerie et des produits pour animaux, et aucun résultat limité à l’habillement n’est publié ; dans le vêtement, où le genre et la taille décident si un résultat peut seulement être porté, les filtres devraient compter davantage. Le seuil de chaque filtre a été réglé avant le lancement, un autre réglage que l’article omet.
La principale objection est que les modèles e5 testés par Target sont plus anciens, et qu’un modèle plus récent et plus grand pourrait se passer des données de Target. Pour cela, il faudrait qu’un modèle générique classe les produits de Target comme le feraient les clients de Target, sans jamais avoir vu leurs choix. Les propres tests de Target donnent peu de raisons de croire que la taille comble cet écart. Sur des requêtes évaluées par des annotateurs humains pour leur pertinence thématique, le plus gros e5-large-v2 a devancé le petit modèle de 0,0068 en NDCG, un score de classement courant. Les auteurs attribuent la perte en conditions réelles à un modèle « entraîné pour la similarité sémantique générale plutôt que pour les produits que les utilisateurs choisissent d’acheter ». Si les modèles génériques continuent de progresser, la perte en zero-shot pourrait se réduire, mais les choix resteront dans les journaux de Target.
Pour un distributeur qui achète une recherche pilotée par l’IA, la décision qui compte est de savoir qui apprend les réglages et qui les conserve. Un éditeur ne peut pas livrer les données, mais il peut apprendre les réglages sur le trafic du distributeur. Le test du modèle prêt à l’emploi chez Target montre ce que fait le système avant que quiconque ait appris ces réglages. Si les modèles et les bases de données vectorielles continuent de baisser de prix, ce sont les réglages qui distingueront la recherche d’un distributeur de celle d’un autre. La clause à lire dans le contrat est celle qui précise si les étiquettes, les seuils et les pondérations de fusion restent la propriété du distributeur dont les clients les ont produits.