Le recommandeur évolué par agents de Tencent a gravi quatre échelons de preuve, et seul le dernier avait de vrais utilisateurs
Dans l'article TGR-EvoDAG de Tencent, des agents LLM ont fait évoluer un recommandeur génératif sur un petit jeu de données Amazon, et le résultat, réentraîné pour une plateforme de médias, a augmenté le taux de clic de 0,40 % lors d'un test en conditions réelles de 14 jours. Les chiffres les plus spectaculaires viennent d'avis rejoués et d'utilisateurs simulés tournant sur le même modèle que celui qui a rédigé les critiques lues par les agents pendant l'évolution : c'est le type de preuve dont disposerait un distributeur privé du trafic de Tencent.
Neritus Vale
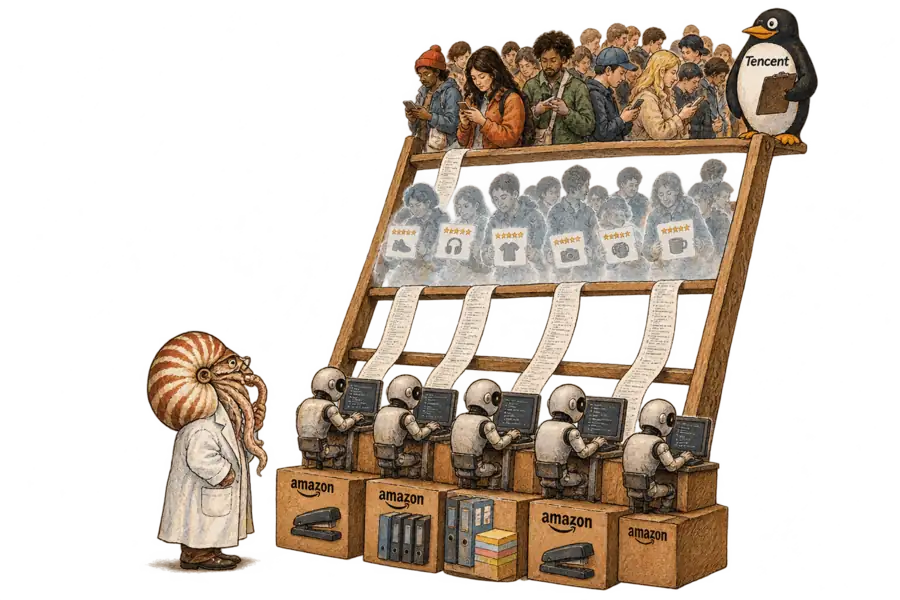
Des chercheurs de Tencent ont laissé des agents LLM réécrire le code d’entraînement d’un recommandeur, et la modification a passé un test en conditions réelles. Leur article, TGR-EvoDAG, soumis à arXiv le 23 octobre, rapporte le gain sur quatre échelons de preuve qui s’achèvent sur ce test, et le chiffre fond à chaque échelon. Un distributeur incapable de mener un tel test jugerait les modifications écrites par des agents sur les deux premiers échelons, les moins coûteux à produire.
Les agents ont travaillé sur un recommandeur génératif entraîné en trois étapes. Un tokenizer transforme chaque article en un code court, un modèle apprend à écrire le code du prochain article d’un utilisateur, et une étape d’alignement affine ses choix. Comme toute modification du tokenizer impose de réentraîner l’ensemble, le système répartit le temps GPU par étape et garde plusieurs branches concurrentes en vie. Sept agents se partagent le travail, dont un relecteur de code.
Le premier échelon est un rejeu sur un petit jeu de données Amazon. Le résumé parle de « jeux de données Amazon publics », mais l’annexe situe toutes les expériences d’évolution dans la catégorie Office Products, avec 4 905 évaluateurs. Aucune catégorie d’habillement n’a été testée.
Sur ces données, le modèle évolué a dépassé APAO, la méthode conçue par des humains la plus solide du comparatif, de 37,4 % en NDCG@10, un score qui mesure la hauteur à laquelle le bon article se classe dans le top dix. Mais les agents sont partis du code publié d’APAO, y ont empilé des modifications et ont refusionné la branche APAO à la fin. La comparaison mesure jusqu’où des agents peuvent pousser un travail humain déjà publié.
L’article chiffre cette recherche en heures GPU, 24 pour chaque cadre comparé. Les tokens de modèle de langage consommés par les agents sont comptabilisés hors de ce budget et ne sont pas rapportés, et aucun chiffre n’est donné pour la recherche humaine qui a produit APAO.
Le deuxième échelon remplace les évaluateurs réels par des évaluateurs simulés. Agent4Rec construit des agents LLM à partir de profils d’utilisateurs réels et leur fait parcourir les recommandations, les noter et décider quand partir. Un panel de ces agents a noté le modèle final de chaque cadre, et leur satisfaction a progressé de 19,7 % par rapport à APAO. Les auteurs y voient la confirmation de « recommandations réellement meilleures ».
Ce contrôle partage un moteur avec la recherche qu’il évalue. L’article précise que les scores d’Agent4Rec n’ont jamais servi à sélectionner des modèles et parle d’une « mesure comportementale réellement indépendante ». Pourtant, un panel d’utilisateurs simulés a noté les modèles finaux et un autre a rédigé les critiques lues par les agents pendant l’évolution ; les deux tournaient sur DeepSeek-v4-flash. Les panels sont séparés, mais ils parlent toujours au nom d’un seul modèle, dont les préférences ont orienté la recherche avant de noter son résultat.
Ce type de simulateur s’accompagne de ses propres mises en garde. Les auteurs d’Agent4Rec ont fait état d’une « déviation » en plus de l’alignement entre leurs agents et les préférences des utilisateurs. Lorsque des simulateurs ont rejoué un test A/B réel dans UserArena, leurs lectures allaient de presque rien à une surestimation, comme nous l’avons rapporté le 23 octobre.
Le troisième échelon passe chez Tencent, mais pas dans une boutique. Les auteurs ont réentraîné de zéro l’architecture évoluée, ainsi qu’APAO, sur les journaux de ce que l’article appelle « la plateforme commerciale de médias à grande échelle de Tencent ». Elle compte plus de 10 millions d’utilisateurs actifs par jour, et une interaction positive y est un clic ; l’article ne rapporte aucune mesure d’achat. Les agents n’ont jamais travaillé sur ces données.
Sur ces journaux, le résumé cite un gain de 12,16 % en Hit@1, c’est-à-dire la fréquence à laquelle l’article cliqué était classé en premier. C’est l’écart le plus large du graphique des seuils de l’article. À Hit@10, un seuil que les tests Amazon utilisaient aussi, le gain est de 1,52 %. Un canal de récupération transmet des candidats à un classeur ; sa première place compte donc vraisemblablement moins que la présence de l’article dans sa liste.
Le quatrième échelon est le seul qui mesure des personnes réagissant au nouveau système. Déployé pendant 14 jours comme canal de récupération supplémentaire, le modèle évolué a augmenté le taux de clic global de 0,40 %, avec p = 0,019 après réduction de variance et correction des comparaisons multiples. L’article ne publie pas les valeurs absolues de taux de clic : les 0,40 % ne peuvent donc pas être convertis en clics ni en chiffre d’affaires. Le précédent article TGR de Tencent rapportait la lecture et le temps de visionnage en plus des clics ; celui-ci ne rapporte aucune mesure du temps passé.
Ce test a porté sur 5 % du trafic réel, soit plus d’un million d’utilisateurs. Un distributeur disposant d’une fraction de ce trafic aurait besoin d’un effet bien plus grand pour qu’un test le distingue du bruit. L’article n’offre pas non plus de taux de change entre les échelons, puisque chacun mesure quelque chose de différent.
Le passage du code évolué à la production est l’endroit où l’article en dit le moins. La configuration de Tencent diffère de celle d’Amazon, avec des historiques d’utilisateurs allant jusqu’à 500 interactions et des textes d’articles incluant des légendes d’images générées par machine. L’article ne dit pas ce qui a changé lors du portage, ni si un ingénieur a lu le code évolué avant sa mise en ligne.
Le seul relecteur de code qu’il décrit est un autre agent.
La principale objection est que rien de tout cela n’est propre aux agents. Le modèle BARGE de Tencent, issu du même article TGR, a amélioré le Hit@5 hors ligne de plusieurs dizaines de pour cent. Après déploiement complet, il a augmenté le taux de clic de 0,60 % : les scores hors ligne ont donc aussi flatté un modèle conçu par des humains. La thèse tombe si les échelons bon marché classent au moins les candidats dans l’ordre qu’un test en conditions réelles donnerait, de sorte qu’un distributeur pourrait désigner les gagnants sans en connaître l’ampleur.
Un seul test en conditions réelles ne peut pas démontrer cet ordre, et l’article n’en a mené qu’un. Le système d’agents que des chercheurs de Google exploitent chez YouTube part du principe que l’ordre peut échouer : son agent hors ligne évite les « trajectoires sans issue qui paraissent prometteuses dans les proxys hors ligne mais n’ont historiquement pas amélioré les métriques en ligne ». La dernière étape des ingénieurs consiste à examiner les « métriques d’expérience collectées par l’agent en ligne ». Les deux reposent sur des tests en conditions réelles, ce dont un distributeur débutant ne dispose pas.
TGR-EvoDAG tourne dans Uppimo, une plateforme interne de Tencent qui, selon l’article, s’ouvrira à un essai public. Si c’est le cas, les distributeurs pourraient utiliser la moitié du processus que les agents ont rendue bon marché, la recherche hors ligne de meilleur code. L’autre moitié, un test en conditions réelles assez grand pour déceler une variation de 0,40 %, n’est pas livrée avec le logiciel. Un distributeur qui adopte la moitié bon marché sans construire le test en conditions réelles a choisi d’expédier sur les deux types de preuve les moins coûteux de l’article.