Poussés à réfléchir davantage, la plupart des agents d'achat sont devenus plus sûrs d'eux, sans cesser de commettre les mêmes erreurs
Dans une préimpression de l'université de Chicago qui teste dix modèles de pointe sur des listes figées de dix produits, passer l'effort de raisonnement de faible à élevé a fait monter significativement la confiance déclarée dans 17 des 30 comparaisons modèle-benchmark, et la précision dans une seule, après correction pour les tests multiples. Les modèles se trompent aussi ensemble : sur WebShop à faible effort, 47 des 493 tâches ont mis en échec les dix modèles, là où des erreurs indépendantes n'en prédiraient pratiquement aucune.
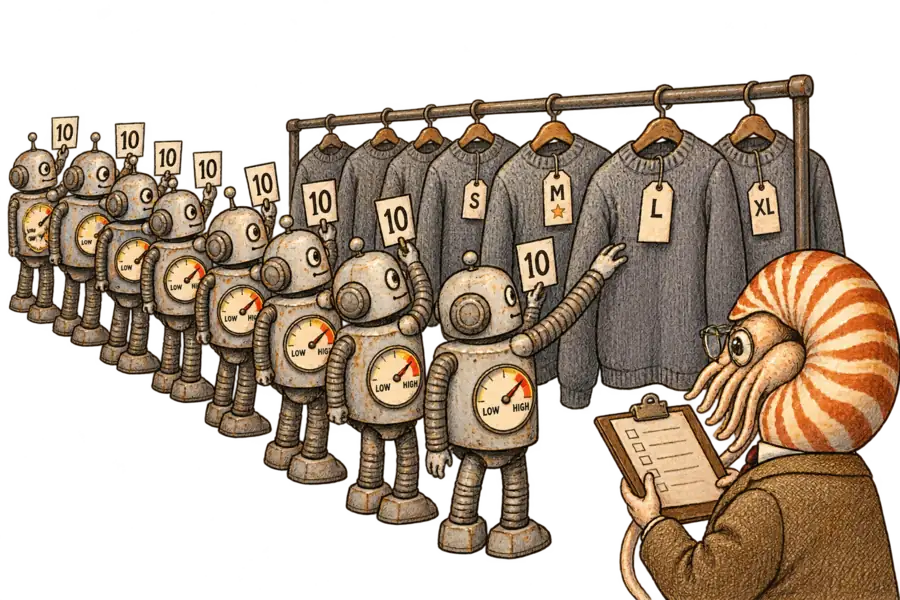
Neritus Vale
Régler un agent d’achat pour qu’il réfléchisse davantage l’a rendu plus sûr de son choix, mais a rarement rendu ce choix mesurablement meilleur. Dans une préimpression de l’université de Chicago portant sur dix modèles de pointe, publiée le 17 novembre, les agents ont aussi eu tendance à échouer ensemble, souvent sur le même mauvais produit. Deux remèdes prêts à l’emploi, davantage d’effort de raisonnement et l’avis d’un second modèle, laissent ces erreurs intactes.
Adi Krishnamoorthy et X.Y. Han ont soumis à chaque modèle une demande et une liste figée et mélangée de dix produits comportant une seule bonne réponse, tirée de WebShop, de SQID d’Amazon ou de WANDS de Wayfair, limité au texte. Les modèles : GPT-6 Astra, GPT-6.1 Sol et GPT-6 Luna d’OpenAI ; Claude Fable 5.1 et Claude Opus 5.5 d’Anthropic ; Gemini 4 Argon et Gemini 3.1 Pro de Google ; DeepSeek V4.1 Flash ; Qwen 3.8 Max d’Alibaba ; et Kimi K3 de Moonshot. Chacun a été exécuté à effort faible, moyen et élevé, lorsque ces niveaux existaient, en notant chaque choix sur 10.
Les limites du dispositif conditionnent tous les chiffres qui suivent. Les listes figées excluent la recherche, la pagination et la navigation, où l’effort pourrait compter davantage, selon les auteurs. WebShop est noté par un programme, mais une vérification manuelle a jugé 15 des 100 distracteurs échantillonnés potentiellement acceptables (intervalle de confiance à 95 % : 9 % à 23 %). SQID et WANDS reposent sur des étiquettes issues du crowdsourcing, dont le bruit peut gonfler les erreurs partagées apparentes, puisqu’une tâche mal étiquetée met tous les modèles en faute. Chaque condition n’a été exécutée qu’une fois, et la confiance était un simple entier renvoyé avec la réponse. Les auteurs indiquent que les tâches, les journaux et le code seront publiés ultérieurement.
La précision a à peine bougé entre l’effort faible et l’effort élevé, pour des niveaux allant, selon les dix modèles, de 74,0 % à 88,1 % sur WebShop, de 43,7 % à 50,6 % sur SQID et de 65,8 % à 73,7 % sur WANDS. Sur les trente comparaisons du tableau 1, résumées ci-dessous, un seul gain entre effort faible et élevé a survécu à la correction de Holm pour les tests multiples, que les auteurs ont appliquée à 26 contrastes par jeu de données : Qwen 3.8 Max sur WebShop. Son gain est intervenu entièrement au passage à l’effort moyen, tout comme celui de GPT-6 Luna sur WANDS, qui a lui aussi résisté à la correction. Les auteurs y voient la preuve qu’un effort faible est « véritablement insuffisant » pour certaines tâches.
| Faible → élevé | WebShop | SQID | WANDS |
|---|---|---|---|
| Variation du taux de réussite, points | -1,4 à +5,5 | -2,0 à +2,0 | -2,1 à +5,2 |
| Variation de la confiance, points | -0,6 à +3,2 | -0,8 à +2,5 | -0,8 à +4,5 |
| Modèles passant Holm, réussite puis confiance | 1, 8 | 0, 4 | 0, 5 |
La confiance déclarée, elle, a évolué dans un seul sens. Sur WebShop, elle a augmenté pour neuf modèles sur dix, le plus souvent à partir de niveaux déjà trop élevés.
Gemini 3.1 Pro illustre l’écart. L’effort élevé a porté sa précision sur WebShop de 3,2 points, un gain qui n’a pas survécu à la correction. Son AUROC sur WebShop, qui mesure la capacité de la confiance à séparer les bonnes réponses des mauvaises, est passé de 0,66 à effort faible à 0,54 à effort élevé, 0,5 correspondant au hasard.
« Élevé » n’a pas non plus signifié partout le même travail. OpenRouter, la passerelle utilisée par les auteurs, facture les jetons de raisonnement comme des jetons de sortie. À effort élevé, Qwen 3.8 Max a dépensé près de cinquante fois plus de jetons de raisonnement par tâche WebShop que GPT-6.1 Sol. La même étiquette achète donc des quantités très différentes de réflexion facturée.
La calibration a suivi le modèle plus que le réglage. Les modèles Claude d’Anthropic ont été les mieux calibrés dans l’ensemble sur chaque benchmark d’après l’erreur de calibration attendue, même si Gemini 4 Argon a devancé les deux sur le score de Brier de WebShop. L’avance est relative : sur SQID, les deux modèles Claude surestimaient encore leur réussite de 12,4 et 10,8 points, et sur WebShop, les huit autres la surestimaient jusqu’à 15,8 points.
Le réglage a toutefois fait bouger la calibration par endroits. L’erreur de calibration de Qwen 3.8 Max sur WebShop est tombée de 12,0 à 6,7 points à mesure que l’effort augmentait, et l’AUROC de Gemini 3.1 Pro a chuté comme indiqué plus haut. Un agent calibré, dit l’article, « peut rendre la décision à l’utilisateur lorsqu’il a un doute ». Un seuil qui attraperait la plupart des erreurs des modèles trop confiants écarterait, d’après les auteurs dans un supplément, la plupart de leurs bonnes réponses.
Les auteurs avancent deux explications au fait que l’effort ait acheté de la confiance plutôt que de la précision. Le choix pourrait être « borné par la lecture plutôt que par le raisonnement », ou bien une longue trace de raisonnement pourrait donner au modèle « le sentiment d’avoir vérifié, qu’il restitue ensuite sous forme de confiance ». Dans les tests de Paderborn dont nous avons rendu compte le 9 novembre, les agents conservaient le plus souvent un produit présélectionné, avec ou sans raisonnement.
Un deuxième avis échoue pour une autre raison : les modèles se trompent ensemble. Sur WebShop à faible effort, 47 tâches sur 493 ont mis en échec tous les modèles, là où des erreurs indépendantes n’en prédiraient pratiquement aucune.
Les benchmarks étiquetés par le crowdsourcing présentent la même forme. À faible effort, 185 tâches SQID sur 500 ont mis en échec tous les modèles, contre presque aucune attendue par le seul hasard. Le bruit des étiquettes, préviennent les auteurs, peut expliquer une partie de cette grappe. Sur WANDS, 55 tâches se sont trouvées dans ce cas, et un effort plus élevé n’a presque pas modifié la corrélation des erreurs.
Les mauvaises réponses se sont aussi concentrées. Parmi les tâches comportant plusieurs mauvais choix à faible effort, plus de 80 % allaient au mauvais produit le plus populaire de chaque tâche, contre 32 % à 36 % par hasard. Sur WebShop, le choix partagé est généralement un « presque-bon plausible » qui échoue sur « une contrainte secondaire telle que la taille, le parfum ou le prix ». Sur SQID, le choix partagé est le plus souvent un substitut dont le titre ressemble presque à celui du bon produit. L’article ne décrit pas le choix partagé sur WANDS, et laisse la cause ouverte : « données d’entraînement partagées, indices d’annonce partagés, ou les deux ».
Aucun benchmark ne cible l’habillement, même si WebShop inclut des annonces de mode d’Amazon ; l’article ne rapporte rien par catégorie. Son presque-bon est, à notre lecture, l’état normal d’un catalogue de vêtements : la plupart des modèles existent en de nombreuses tailles et couleurs sous des titres quasi identiques, un peu comme le supplément de SQID décrit des substituts qui sont souvent « le même produit dans une autre taille, couleur ou quantité par lot ». Une annonce presque-bonne qui attire les agents, écrivent les auteurs, « capte la demande de tous les agents à la fois ».
Du côté du vendeur, des agents qui s’accordent sur la mauvaise taille pourraient passer pour un best-seller.
La plus forte objection est que l’article a testé la partie facile et l’a étiquetée imparfaitement. Le test mode d’Ozan Candogan, cité par l’article, a soumis trois agents grand public (dots, Instinct et Muse) à 10 pulls décrits par trois attributs, puis à 50 robes décrites par 12, et a constaté qu’ils « se sont montrés beaucoup moins performants dans ce cadre plus riche ». Il a testé des produits plutôt que des modèles de base et n’a pas fait varier l’effort, et il a noté que la stratégie de recherche « peut façonner le choix final autant que le modèle ». La thèse tombe si la réflexion supplémentaire est payante dans la recherche, ce que les auteurs jugent possible, ou si la plupart des erreurs partagées sont des artefacts d’étiquetage.
Un bénéfice dans la recherche réduirait la thèse au choix final, où aboutit tout pipeline. Là, dans les comparaisons de chaque modèle avec lui-même sur des listes de dix articles et des étiquettes identiques, le cadran a augmenté la confiance sans augmenter de façon fiable la précision. L’objection sur les étiquettes porte en partie : l’article ne vérifie jamais combien d’erreurs partagées tombent sur ses distracteurs potentiellement acceptables. Une fois les données publiées, un nouveau scoring des 47 tâches qui ont mis en échec tous les modèles montrerait la part imputable au benchmark.
Reste donc à savoir pour quoi payer. Choisir un modèle calibré, concluent les auteurs, « compte plus que de pousser son effort » ; notre propre conseil est de tester la calibration en interne plutôt que de croire la parole d’un fournisseur. Si les agents d’achat lisent les compteurs de ventes comme les agents de la réédition de Music Lab dont nous avons rendu compte en octobre lisent un décompte, un presque-bon partagé pourrait grimper dans les classements grâce à des votes issus tous de la même erreur.