La meilleure méthode de GEO sur pages en ligne a raflé les trois moteurs pour 31 marques sur 80
Dans LIVE-GEO, qui a mis en ligne des pages réécrites selon le GEO pour 80 marques fictives, la méthode CORE arrivait en tête sur ChatGPT, Grok et Gemini, mais ne l'emportait sur les trois à la fois que pour 31 marques. Inverser six liens a déplacé sa part sur ChatGPT de 20 points, des statistiques sans fondement ont tout de même décroché certaines premières places, et aucun vêtement n'a été testé.
Neritus Vale
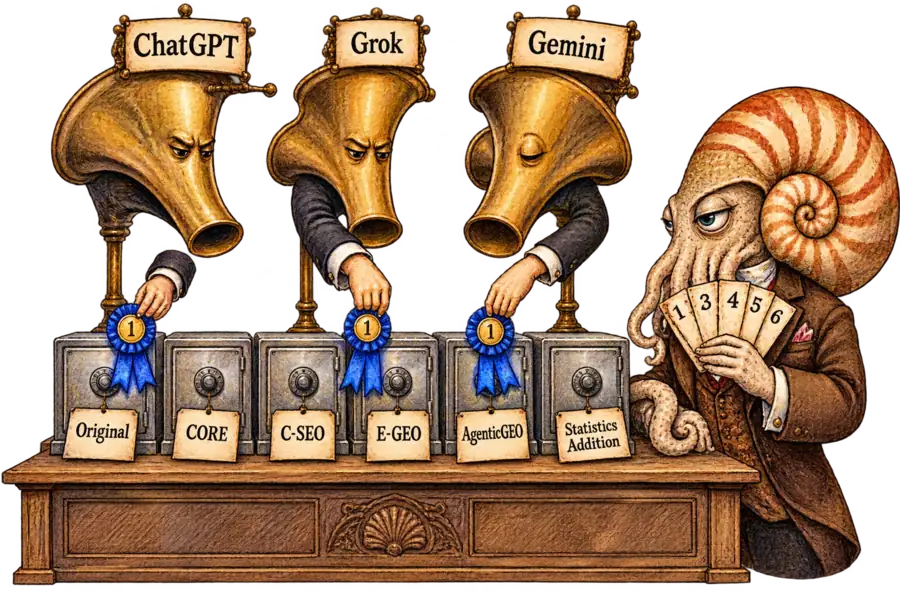
Dans LIVE-GEO, un test d’optimisation pour les moteurs génératifs (GEO) sur des pages web en ligne, une méthode de réécriture appelée CORE a décroché la première place sur ChatGPT, Grok et Gemini pour environ deux tiers à trois quarts des marques fictives. D’après notre décompte du tableau marque par marque de l’article, elle l’emporte sur les trois à la fois pour 31 des 80 marques. Un gain de GEO appartient au moteur, à l’ordre des liens et au prix sur lesquels il a été mesuré.
Runze Kong, de l’université du Michigan, et ses collègues, pour la plupart de l’université de l’Illinois à Urbana-Champaign, ont publié les pages sur le site produit public d’une start-up partenaire et ont mis l’article en ligne le 31 octobre. Chaque marque fictive appartient à une catégorie peu courante, comme un coffre à fromage gainé ou un four de recuit, choisie « pour réduire les interférences avec les marques et pages web existantes ». Chaque marque dispose de six pages produit construites sur les mêmes spécifications : un original issu d’un modèle type, et une réécriture chacune pour CORE, C-SEO, E-GEO, AgenticGEO et Statistics Addition.
Dans la condition principale, le test mesure la lecture, pas la découverte. ChatGPT avec GPT-6, Gemini 3.6 Thinking et Grok en mode Expert ont reçu les liens des produits et ont dû classer les produits en s’appuyant uniquement sur ce que disaient les pages. Cinq autres modèles ont classé le même texte sans accès au web. Lorsque ChatGPT devait retrouver lui-même les produits à partir de l’URL d’une marque, la part de premières places de CORE passait de 76,3 % à 46,3 %.
Aucun vêtement n’a été testé. Parmi les 18 familles de produits, la plus proche de l’habillement est celle du matériel d’artisanat textile et de matériaux, de sorte que toute analogie avec le vêtement relève ici de nous.
CORE arrivait en tête sur chaque moteur. Le tableau 1 donne la part de marques classées premières pour chaque méthode, à prix figés et avec les liens produits fournis :
| Taux de première place, % des marques | ChatGPT | Grok | Gemini |
|---|---|---|---|
| CORE | 76,3 | 67,5 | 66,3 |
| Statistics Addition | 10,0 | 11,3 | 5,0 |
| E-GEO | 5,0 | 7,5 | 7,5 |
| AgenticGEO | 3,8 | 5,0 | 8,8 |
| C-SEO | 2,5 | 8,8 | 2,5 |
| Original, non réécrit | 2,5 | 0,0 | 10,0 |
Sept des huit évaluateurs de l’article placent CORE en tête le plus souvent, même si, sur Qwen2.5-3B, son avance sur C-SEO n’était que de 1,3 point. Le huitième, Claude Sonnet 5.5 lisant le texte via l’API d’Anthropic, a privilégié l’original non modifié et a classé CORE dernier en moyenne. Les auteurs d’E-GEO voient dans un schéma stable et indépendant du domaine le signe d’une stratégie de GEO « universellement efficace ». Une prétention à l’universalité entre domaines ne se transpose pas aux évaluateurs : ici, la meilleure stratégie dépendait de celui qui lisait.
L’accord sur la moyenne masquait le désaccord sur chaque marque. Grok et Gemini, la paire la moins alignée, ont désigné le même gagnant pour 48,8 % des marques. Pour un bac de culture sur sol dégelé en couche active, Grok a choisi la page Statistics Addition et Gemini celle de CORE. Même la paire la plus proche, ChatGPT et Grok, n’était d’accord que pour environ deux marques sur trois.
L’ordre des liens suffisait à lui seul à faire bouger le verdict de ChatGPT. À prix égaux, CORE obtenait la première place pour 73,8 % des marques lorsque son lien venait en dernier dans une liste fixe, et pour 93,8 % lorsque la liste était inversée. Les pages étaient identiques. Répéter une exécution à l’identique laissait l’agrégat proche de son niveau initial ; le verdict de l’article est que la visibilité est « insensible à la répétition et sensible à la présentation ».
Marque par marque, une répétition était moins stable que cet agrégat ne le laisse croire. Sur ChatGPT, une nouvelle exécution dans les mêmes conditions a retenu le même produit en tête pour seulement 80,0 % des marques : environ une marque sur cinq changeait donc de gagnant. Une partie du désaccord entre moteurs est donc un moteur en désaccord avec lui-même, et le décompte de 31 sur 80 provient d’une seule exécution.
La randomisation est le remède de l’article. L’ordre aléatoire de chaque marque est tiré une fois puis conservé, de sorte que les chiffres principaux reposent eux aussi sur un seul ordre. Sur ChatGPT, le résultat de l’ordre mélangé se situait entre ceux des deux ordres fixes. Pour Gemini, il en allait autrement : à prix égaux, l’ordre mélangé donnait à CORE la première place pour 82,5 % des marques, alors que l’un ou l’autre des ordres fixes la ramenait sous 30 %. L’article ne explique pas cet écart.
Le prix a lui aussi fait bouger le résultat. Les chiffres principaux proviennent de pages dont les prix sont à moins de 0,2 % du prix de base de chaque marque ; avec tous les prix égaux, la part de CORE dans les premières places de Gemini grimpait jusqu’à 16,2 points. Les variations sur les deux autres moteurs étaient plus faibles et n’allaient pas toutes dans le même sens. La formule de synthèse de l’article, « Les valeurs changent, mais le leader du Top-1 demeure », est exacte. Reste qu’une marque vit dans les valeurs.
Statistics Addition, une méthode issue de la première étude en laboratoire de notre article du 4 octobre, arrivait au mieux deuxième en part de premières places sur les pages en ligne. Son prompt « autorise les données hypothétiques », et ses réécritures avançaient des affirmations comme « 18 % d’amélioration de la rétention de chaleur ». En laboratoire, de tels chiffres faisaient fortement bouger les moteurs. Sur Gemini, la méthode décrochait moins de premières places que l’original non modifié, mais en moyenne elle le devançait sur chaque moteur, et sur Grok elle avait le meilleur rang moyen avec les deux ordres fixes.
Les chercheurs ont fait la vérification. Ils ont utilisé un vérificateur existant, JEV, mis au point par Deußer et ses collègues, qui a signalé 86 des 400 descriptions réécrites pour des chiffres que les spécifications n’étayaient pas, dont toutes les descriptions de Statistics Addition. Comme les 80 pages de cette méthode ont été signalées, repousser les pages signalées sous les autres ramène par construction son taux de première place à zéro. L’article en conclut que de tels gains « ne survivent pas aux signalements ».
Aucun moteur n’a vu de signalement.
Les signalements relevaient de la comptabilité : ils étaient conservés dans un fichier séparé, tandis que les pages restaient telles qu’écrites. JEV ne couvrait que les descriptions, alors que chaque méthode réécrivait aussi les titres et les corps des avis. L’article ne dit pas non plus quelle part du gain revenait aux avis. En dehors du benchmark, une marque peut réécrire ses textes, mais pas les mots de ses clients.
La plus forte objection est que le leader a à peine bougé. D’après notre décompte du tableau 1, CORE avait la plus grande part de premières places dans toutes les exécutions de moteur sauf une. Dans cette lecture, la dispersion est un bruit autour d’un avantage réel, et une marque devrait acheter la méthode qui gagne le plus souvent. Pour que la thèse tombe, il faudrait que le résultat propre à une marque suive cette moyenne.
Le résultat propre à une marque ne suivait pas la moyenne. CORE l’emportait sur les trois moteurs pour 31 marques ; pour les autres, au moins un moteur couronnait une autre page. Le leader n’était pas non plus un candidat neutre : Haibo Jin, Huimin Zeng et Haohan Wang, tous auteurs de LIVE-GEO, ont co-écrit CORE. C’était aussi la seule méthode réglée sur les classements en direct de ChatGPT avant que ses textes ne soient figés, et c’est sur ChatGPT qu’elle obtenait son meilleur score. Son optimiseur s’appuyait en outre sur des classements de GPT-4o, et GPT-4o figure parmi les évaluateurs, même si l’article précise que les classements de retour ne comptent pas comme résultats d’évaluation.
Une marque de vêtements affronte l’interférence que LIVE-GEO voulait réduire : de vrais concurrents, et ce que chaque moteur croit déjà d’eux. Si les gains se dispersent à ce point sur des coffres à fromage, le chiffre de gain d’une veste décrira le moteur, l’ordre et le prix qui le sous-tendent. Une marque peut acheter ce chiffre, ou mesurer ses propres pages selon les moteurs, les ordres de liens et les prix ; seule la seconde option lui apprend ce qu’elle a acheté.