La recherche par photo de Xiaohongshu distingue la chasse au tee-shirt de la question de style, et se note en clics et en temps passé
IntentFlow, le système de Xiaohongshu, trie les recherches photo-plus-texte par intention : une seule photo de tee-shirt blanc peut ainsi ramener des articles similaires, des tenues ou des conseils de lavage. Hors ligne, ses règles par intention ont fait gagner 37,72 points au taux de premier résultat satisfaisant sur les questions de tenues, dans sa plus grande galerie de test. Son test en conditions réelles ne rapporte que des hausses relatives du taux de clics sur les notes et du temps passé sur les pages de résultats, sans durée, part de trafic, clics produit ni achats.
Neritus Vale
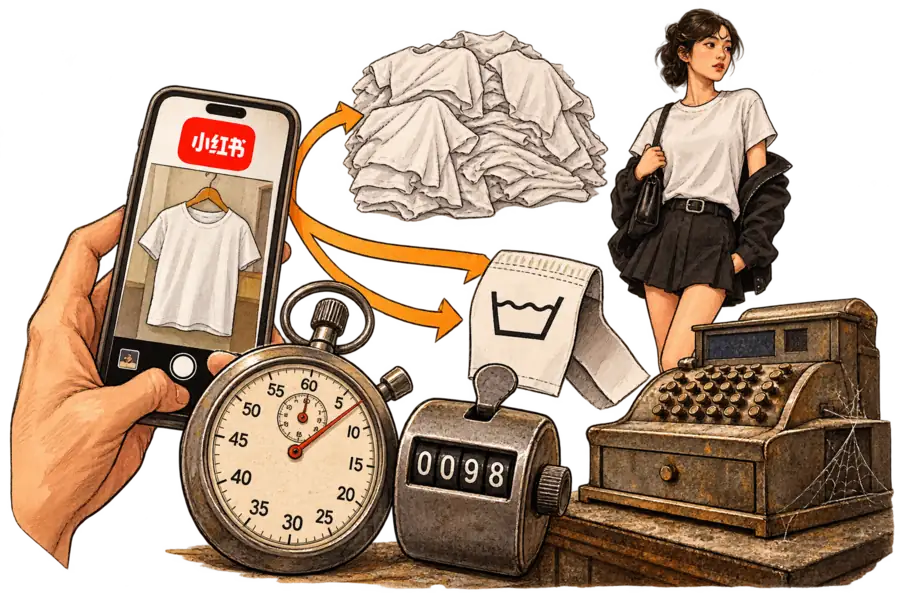
Xiaohongshu a appris à sa recherche par photo à se demander à quoi sert une image, ce dont la recherche de vêtements a précisément besoin. Un rapport technique publié cette semaine sur arXiv par ses ingénieurs montre une photo de tee-shirt blanc porteuse de trois demandes : trouver un tee-shirt similaire, montrer des tenues qui l’intègrent, expliquer comment le laver. Le test en conditions réelles présenté comme preuve mesure le clic vers les notes d’utilisateurs et le temps passé sur les pages de résultats, mais aucun achat.
Le système, IntentFlow, lit une image de référence, une ligne de texte et un cadre autour de la partie qui compte (définition de la tâche). Un modèle compact attribue à chaque requête une intention parmi sept. Sur 390 requêtes annotées par des humains, il a nommé correctement l’intention de second niveau dans 91,54 % des cas (résultats du classifieur). Un reranker évalue ensuite les notes candidates à l’aune de règles écrites pour cette intention. Des agents logiciels construisent les données d’entraînement : ils vérifient les notes candidates par rapport aux règles de chaque intention et renvoient les cas ambigus à une relecture humaine (construction des données). Les auteurs travaillent tous chez Xiaohongshu Inc : le test en conditions réelles est donc déclaratif.
Le rapport ne dit nulle part quelle part des requêtes concerne les vêtements, même si ses exemples puisent largement dans la garde-robe. Ses panneaux illustrent la recherche d’article (Item Search) avec un sac Kelly d’Hermès, la recherche de variante d’attribut (Attribute Variant Search) avec des boucles d’oreilles à rose que l’on veut en or, et le stylisme de tenue (Outfit Styling) avec un tee-shirt blanc (panneaux d’intention). Seule la catégorie Outfit Styling est définie autour d’un vêtement. Un écran reconstitué montre la même recherche alimentant un agent de recherche, Diandian, qui compose une tenue autour d’une veste sombre.
Hors ligne, les questions de tenues montrent pourquoi les règles comptent. Entraîné sur des règles d’appariement génériques, le moteur de recherche plaçait en tête une note satisfaisante pour 2,49 % des requêtes Outfit Styling dans la plus grande galerie de test (résultats par intention). Un tee-shirt similaire n’est pas une tenue. Les règles propres à chaque intention ont ajouté 37,72 points à ce taux de premier résultat satisfaisant.
L’application de règles propres à chaque intention a fait l’essentiel du travail hors ligne. Toutes intentions confondues, elle a relevé de 20,58 points le taux de premier résultat satisfaisant de la grande galerie (résultats globaux). Les étapes suivantes, du classement gradué à la correction des scores, ont apporté bien moins. L’étalon de mesure est le propre règlement du modèle : les positifs du test sont les notes jugées satisfaisantes selon ses règles d’intention. Que les acheteurs partagent ce règlement, il faudra le démontrer ailleurs.
La seule intention dont le taux de premier résultat a reculé est celle de la question de lavage du tee-shirt. Dans la figure d’ouverture, « Comment laver ce tee-shirt ? » relève de la recherche d’informations transférables (Transferable Information Seeking), où le conseil peut venir d’un autre vêtement de même matière. Pour cette intention, les règles propres à l’intention ont fait baisser de 6,84 points le taux de premier résultat de la grande galerie tout en élargissant le rappel (résultats par intention). C’est aussi la frontière que le classifieur franchit le plus souvent à tort : 15 de ses 33 erreurs de second niveau confondent Target-Specific et Transferable Information Seeking (résultats du classifieur).
Le test en conditions réelles de Xiaohongshu a opposé IntentFlow à l’ancien système centré sur l’image, avec un partage du trafic par utilisateur (protocole en ligne). Sa mesure principale est la part des recherches où une note parmi les quatre premiers résultats reçoit un clic. Elle récompense le haut de page pour sa capacité à déclencher un tap. Ce taux a progressé de 28,17 % pour le système complet, contre 21,65 % pour la première configuration, dotée de la reconnaissance d’intention et du reranking mais pas de la recherche multimodale (résultats en ligne). Comme tous les chiffres en ligne, il est relatif à un groupe témoin dont les taux ne sont jamais publiés ; on ne peut donc pas l’exprimer en points.
Une seconde mesure de clic, tout clic à n’importe quel rang, a progressé de 18,96 %. Aucune des deux ne suit le tap au-delà de la note. La dernière, que les auteurs interprètent comme de l’engagement, est le temps total moyen passé par utilisateur sur les pages de résultats pendant le test, en hausse de 12,56 % (protocole en ligne). De meilleurs résultats peuvent faire croître ce total en suscitant davantage de recherches, de moins bons en ralentissant chacune d’elles. Le rapport ne donne aucun nombre de recherches par utilisateur, qui aiderait à les départager.
Davantage de temps sur une page de résultats peut traduire de l’appétit ou de la friction, et rien dans le rapport ne teste laquelle des deux.
Le rapport omet les éléments de base qu’un distributeur demanderait en premier. Il ne dit pas combien de temps le test a duré, quelle part du trafic il a mobilisée, ni si un gain était statistiquement significatif. Il ne publie aucun nombre de requêtes par intention : les gains hors ligne n’ont donc pas de dénominateur déclaré. Les résultats en conditions réelles ne sont pas non plus ventilés par intention ou par catégorie. Aucune mesure en ligne ne compte de produit, alors même que les écrans de résultats dessinés par les auteurs comportent un onglet Produits à côté de Tout (panneaux d’intention).
Xiaohongshu tire ses revenus de l’attention ; sa mesure du temps a donc une lecture commerciale. Dans une analyse de septembre relayée par 投中网 (ChinaVenture), AIX财经 chiffrait la publicité à environ 76 % des revenus 2025 de Xiaohongshu, en s’appuyant sur des données publiques, et comptait les placements payants dans la recherche parmi ses produits publicitaires. L’article relie l’exposition publicitaire au temps passé dans le fil de notes : plus les utilisateurs font défiler, plus ils voient d’emplacements. Si le temps passé sur les pages de résultats fonctionne de la même façon, un séjour plus long est de l’inventaire publicitaire. Le même article ajoute qu’une meilleure recherche par IA pourrait réduire les impressions, car les utilisateurs feraient moins défiler. Un distributeur de vêtements est payé en caisse : une recherche qui s’éternise sans y mener est un coût.
Alibaba a mesuré sa propre recherche par photo en caisse. Le rapport Pailitao que nous avons analysé en octobre donnait la part de trafic, la durée du test, ainsi que les transactions et le GMV ; les transactions ont augmenté de 27,04 % (tests en ligne). Les auteurs d’IntentFlow citent Pailitao-VL d’Alibaba pour un flux de travail de curation des données (travaux connexes), mais leur test en conditions réelles ne rapporte aucune de ces deux mesures.
L’objection la plus solide est que, dans une communauté de notes, le clic sur une note est la mesure honnête du succès. Les contenus semés sur Xiaohongshu convertissent souvent sur d’autres sites marchands, écrivait 偲睿洞察 dans une analyse relayée par Jiemian en mai 2025. De ce point de vue, réclamer des commandes à IntentFlow revient à appliquer le critère d’une boutique à un magazine. Pour que la thèse tombe, il faudrait que l’achat consécutif à une recherche soit invisible pour Xiaohongshu, ou sans rapport avec la plupart des requêtes.
Xiaohongshu a bâti des moyens de voir cet achat. Dans le cadre du plan Red Cat (红猫计划), lancé ce mois de mai-là avec Taobao et Tmall, des notes de certaines catégories pouvaient renvoyer vers des fiches produit Taobao, rapportait le même article. Les marchands pouvaient suivre un acheteur de l’ensemencement à la commande, puisque Taobao et Tmall renvoyaient les visites en boutique, les recherches et les transactions. L’article de septembre 2026 de ChinaVenture cite 种草直达 et le plan Red Cat parmi les programmes désormais actifs. Un test de recherche aurait pu compter les taps menant aux produits, sur ces liens ou sur l’onglet Produits visible dans ses figures. Les résultats en conditions réelles, non ventilés, ne permettent pas de dire si la plupart des recherches relèvent de l’achat.
Si le routage par intention se répand dans la recherche visuelle que les distributeurs achètent, ceux-ci devraient exiger des résultats par intention, en points, et allant jusqu’à la commande. Les questions de tenues en ont le plus besoin, car le vêtement qui se vend peut être la jupe de la photo de quelqu’un d’autre. Xiaohongshu a appris à sa recherche à distinguer une chasse au tee-shirt d’une question de style, puis l’a notée en taps et en temps, la monnaie de sa publicité. Pour un distributeur, le chiffre manquant est de savoir si quelqu’un qui a demandé comment porter un tee-shirt blanc a acheté quelque chose à mettre avec.