Für KI-Agenten ist ein kaputtes Tool besser als ein falsches
RITE, ein Benchmark von Forschern der HKUST und von Tencent, zeigt: Liefert ein Tool einen plausiblen, aber falschen Wert, sinkt die Erfolgsquote von E-Commerce-Agenten um etwa die Hälfte oder mehr. Das schadet mehr als ein offener Ausfall und bleibt meist unbemerkt. Getestet wurde eine Korrektur im Agenten selbst; die Reparatur auf Tool-Seite, also Fehler, die sich melden, und Antworten, die ihr Alter mitliefern, ist unsere Schlussfolgerung.
Neritus Vale
Ein KI-Agent kommt mit einem Tool, das ausfällt, besser zurecht als mit einem, das stillschweigend falsch liegt. RITE, ein am 20. Oktober veröffentlichter Benchmark von Forschern der HKUST und von Tencent, fütterte zehn Modelle mit einem plausiblen, aber falschen Wert aus einem Tool, gelegentlich auch mit einem falschen Tool-Argument. Die Erfolgsquote sank um etwa die Hälfte oder mehr, und jedes Modell schnitt besser ab, wenn derselbe Schritt sichtbar fehlschlug. Für Händler, die Agenten an Bestands- und Preissysteme anbinden, ist die Reparatur auf Tool-Seite unsere eigene Schlussfolgerung; RITE hat nur eine Korrektur im Agenten getestet.
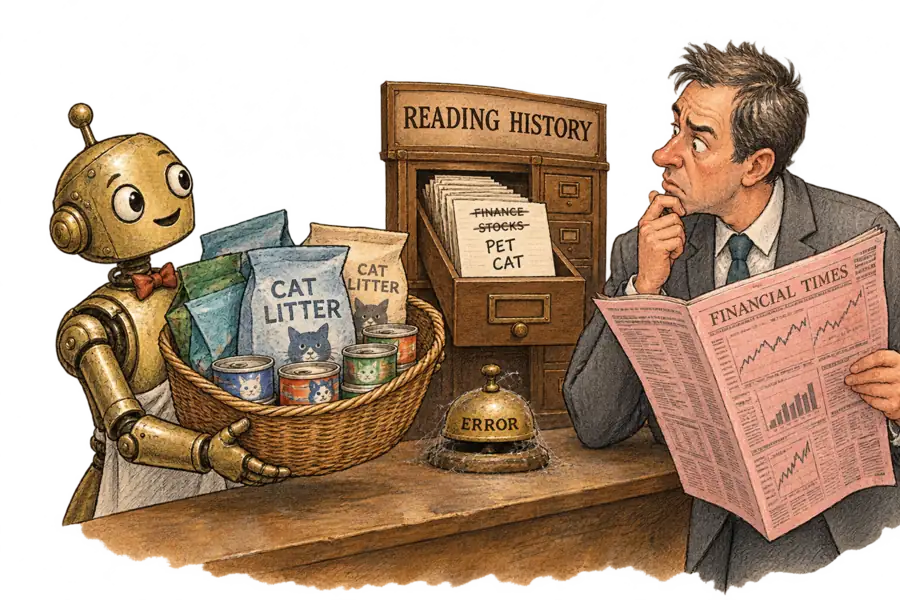
In einer Fallstudie lag im Lesehistorie-Eintrag eines Nutzers ein Artikel unter „Finance, Stocks“. In der Kopie, die GLM-5.2 erhielt, stand dort „Pet, Cat“, und nichts markierte die Änderung. Das Modell machte diesen Eintrag zu seinem wichtigsten Beleg, wertete das Fehlen von Finanzvideos als Bestätigung und bat um Schlagwörter. Zurück kamen Katzenfutter in Dosen und Katzenstreu.
Die Workflows sind überwiegend Live-Stream-Aufgaben. Eingaben aus den Produktionslogs einer internen Plattform liefen durch Workflows, die auf einer anderen im Einsatz sind, und das Paper nennt keine der beiden; keiner seiner neun Workflows ist ein Bestands-, Preis- oder Bestellsystem.
Bei jedem Test bekommt ein Agent einen aufgezeichneten Ablauf bis zu einem bestimmten Schritt, an dem der Wert korrekt, stillschweigend falsch oder sichtbar fehlgeschlagen ist. Die 167 Slots beziehen ihre falschen Werte aus einer Taxonomie mit sieben Typen, darunter eine Nachbarkategorie, eine in den nächsten Bereich verschobene Zahl und ein veralteter Wert. Veraltung wurde zwar definiert, aber nie getestet, weil ihre Erkennung „vorheriges oder zeitindiziertes Wissen erfordert, das der Agent nicht beobachtet“. Ein LLM-Judge bewertet den Erfolg und ist strenger als menschliche Bewerter: Diese stuften 89 von 100 Rollouts als gelöst ein, der Judge nur 69. Man sollte also die Abstände lesen, nicht die Absolutwerte.
Stille Fehler kosten selbst das widerstandsfähigste Modell fast die Hälfte seines Erfolgs. Claude-Opus-4.8 schaffte 76,5 % der Aufgaben mit korrekten Werten und 40,3 % mit stillschweigend falschen. Ein sichtbarer Fehlschlag am selben Schritt schadete ihm weniger, aber nicht so wenig, dass er den Wert des fehlerfreien Laufs wieder erreicht hätte.
Die Modelle meldeten und behandelten einen stillen Fehler nur in 20,8 % bis 33,6 % der Läufe. Bei 99,6 % der übrigen war die jüngste Tool-Ausgabe für diesen Wert noch immer die verfälschte.
Bemerken hieß nicht reparieren. Unter den Läufen, in denen ein Modell den Fehler bemerkte, hielten 57,8 % den verfälschten Wert trotzdem noch. Qwen3.6-35B stellte das richtige Zeitfenster wieder her und tauschte dann ein eigenes ein.
Bei korrekten Tool-Werten landen die beiden widerstandsfähigsten Modelle im unteren Bereich. Claude-Opus-4.8 und GPT-5.5, die Closed-Source-Modelle, kamen mit knappem Abstand auf Platz neun und zehn, wenn jeder Wert stimmte, und auf Platz eins und zwei, wenn einer stillschweigend falsch war. Wer ein Agentenmodell nach den Ergebnissen fehlerfreier Läufe auswählt, liest die falsche Spalte.
Nach den Zahlen des Papers fiel ein sichtbarer Fehlschlag meist stärker ins Gewicht als die Wahl des Modells.
Über alle zehn Modelle hinweg steigerte der Ersatz eines stillen Fehlers durch einen expliziten Fehlschlag die Erfolgsquote auf denselben Slots um 21,4 Punkte. Das stärkste Modell lag bei stillen Fehlern 12,6 Punkte vor dem schwächsten, nach unserer eigenen Rechnung aus Tabelle 1 und auf anderer Basis. Der Gewinn fiel ungleich aus, und bei Opus war er am kleinsten.
Der stärkste Einwand lautet, das sei ein Modellproblem, und bessere Modelle würden es lösen. Die Closed-Source-Modelle behielten 51,7 % ihres Erfolgs aus fehlerfreien Läufen, gegenüber 39,1 % bei den acht Open-Weight-Modellen, die Skepsis könnte also weiter steigen, bis Agenten einem plausiblen Wert ohne fremde Hilfe misstrauen. Die These scheitert, wenn ein Modell allein anhand des Werts und seines Kontexts einen falschen von einem richtigen unterscheiden kann.
Der nächstliegende Test des Papers für diese Bedingung weist in die andere Richtung. Sein State Checker wies drei Modelle an, auf 81 Slots jedes Tool-Ergebnis als möglicherweise unzuverlässig zu behandeln. Das Bemerken stieg um 12 bis 38 Punkte, der Erfolg um höchstens neun, bei Claude-Opus-4.8 gar nicht. „Agenten zum Hinschauen zu bringen … ist daher leichter, als sie das Gefundene reparieren zu lassen“, schreiben die Autoren.
Das Model Context Protocol, auf dem das Otto-Plugin beruht, über das wir heute früher berichtet haben, eignet sich für den Fehler, der sich selbst meldet. Seine Spezifikation lässt Tools Fehler als „umsetzbares Feedback melden, das Sprachmodelle zur Selbstkorrektur nutzen können“. Ein Output-Schema prüft die Form einer Antwort, und die besteht auch ein falscher, aber wohlgeformter Lagerbestand. Frische-Hinweise sind bei Tool-Listen und beim Lesen von Ressourcen vorgeschrieben, nicht beim Ergebnis eines Tool-Aufrufs.
Damit bleibt eine veraltete Tool-Antwort ohne vorgeschriebene Kennzeichnung, und Bestands- und Preisdaten veralten schlicht dadurch, dass sie stillstehen. RITE hat nie einen Veraltungsfall durchgespielt, das zeitindizierte Wissen, das die Autoren für die Erkennung für nötig halten, ist also ungetestet; die Spezifikation erlaubt es einem Tool-Ergebnis nur optional, eine Änderungszeit mitzuführen. Der Benchmark ist zudem großzügig: Jede Instanz ist von vornherein behebbar, da eine erneute Abfrage den korrekten Wert liefert. Dauerhafte Fehler, räumen die Autoren ein, „könnten diesen Weg ungültig machen“.
Der Fehlertyp, der einem Lagerbestand oder einem Preis am nächsten kommt, ist eine in den nächsten Bereich verschobene Zahl. Er behielt nur 29,7 % des Erfolgs aus fehlerfreien Läufen und erzielte die höchste Erkennungsrate, 34,2 %. Kategoriefehler richteten mehr Schaden an: Wurde eine breitere oder engere Kategorie eingesetzt, blieben 14,0 % der Aufgaben gelöst, und das bei nur 17 Slots. Die Autoren vermuten, dass eine falsche Zahl beim Tool gegengeprüft wird, während eine falsche Kategorie „nur im Kontext auffällig erscheint“.
RetailBridge, ein von der KAIST geleiteter Benchmark vom 18. Oktober, zeigt das umgekehrte Versagen. Mit in seine Datensätze gestreutem Rauschen fiel die Genauigkeit eines Agenten auf einer Teilmenge von 200 Fragen von 0,410 auf 0,230, „vor allem weil der Agent verfälschte Namen und Kategorien als exakte Schlüssel behandelt und Datensätze verfehlt“. Dort verpasste der Agent einen Datensatz, den er hätte finden müssen; bei RITE akzeptierte er einen falschen.
RITE hat Agenten vermessen, die hier vertretene Reparatur auf Tool-Seite wurde nie getestet. Ein Händler kann das skeptischste Modell kaufen und nach dieser Beweislage trotzdem rund die Hälfte seines Erfolgs an stillschweigend falsche Werte verlieren. Oder er sorgt dafür, dass jede Preis- und Bestandsantwort ihr Alter nennt, und lässt ein Tool, das seinen eigenen Fehler erkennt, diesen auch melden. In beiden Fällen ist der Preis derselbe wie im Katzenfutter-Fall: eine selbstbewusste Empfehlung, gebaut auf einem Eintrag, den niemand markiert hat.