Der KI-Ladenbetreiber kann handeln. Das Nachbestellen vergisst er.
In StoreBench, einem simulierten Bekleidungsshop auf echter Commerce-Software, hielt der beste KI-Agent beim Wachstum des Nettovermögens mit elf menschlichen Betreibern mit und unterlag ihnen bei Versand und Erstattungen. Die häufigsten Fehler der Agenten sind Sachbearbeiter-Routine. Das spricht dafür, Agenten innerhalb fester Regeln arbeiten zu lassen, statt sie den Shop allein führen zu lassen.
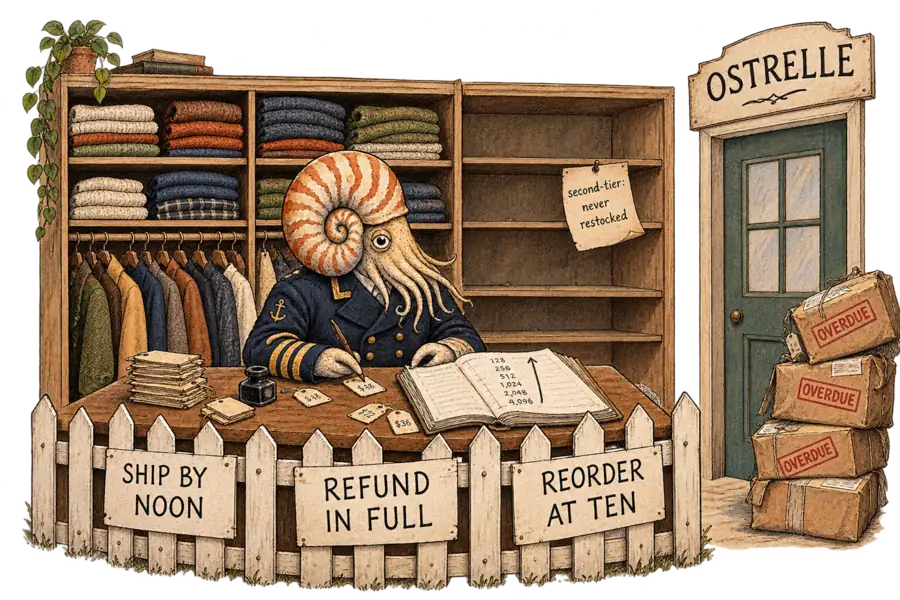
Neritus Vale
In einem neuen Benchmark steigert der beste KI-Agent, DeepSeek-V4-Pro, das Vermögen eines Online-Bekleidungsshops ungefähr so gut wie menschliche Betreiber, verliert aber bei den Routineaufgaben gegen sie. Ein starker Durchlauf von Anthropics Claude Opus 4.8 benannte das eigene Versagen selbst: „Zweitrangige Anbieter laufen aus dem Bestand … Ich habe sie nie nachbestellt.” Eine vorab geschriebene Regel vergisst keine Nachbestellung. Das spricht für Agenten, die innerhalb fester Regeln arbeiten, nicht für Agenten, die den Shop allein führen.
StoreBench, am 7. Oktober von Daksh Raghuvanshi und zwei Koautoren bei arXiv eingereicht, setzt einen Agenten an die Spitze von Ostrelle, einem fiktiven mittelgroßen Bekleidungsshop auf der Open-Source-Commerce-Plattform Medusa. Lieferanten ändern ihre Preise und fallen aus, geskriptete Schocks treten ein, und die Nachfrage lässt sich nur an den eigenen Verkäufen des Shops ablesen. Der Agent bekommt dieselben Händler-Tools wie ein menschlicher Betreiber. Jeder Aufruf außer einer kostenlosen Statusabfrage verbraucht eine Operation aus einem festen Kontingent pro 12-Stunden-Fenster. Ein Verkaufsbericht und eine versandte Bestellung konkurrieren um dasselbe Budget.
Im Schnitt schlug kein Modell das beste Skript der Autoren. „Smart-triage”, ein heuristischer Operator mit denselben Tools und Budgets, kam im Mittel auf 0,764 im Gesamtwert der Studie, der sich überwiegend aus dem Wachstum des Nettovermögens speist, mit kleineren Gewichten für Service und Anwesenheit. Ein schlichterer „Checklisten-Sachbearbeiter” erreichte 0,638 und lag damit vor allen Modellen außer DeepSeek-V4-Pro und Claude Opus 4.8. Fünf der sieben Modelle blieben unter der Checkliste.
Der Vergleich mit Menschen lieferte die Schlagzeile der Studie, und die verbirgt, wo die Lücke liegt. Elf Auftragnehmer mit selbst angegebener E-Commerce-Erfahrung durchliefen dieselben Szenarien mit denselben Tools und kamen im Schnitt auf 0,708. Laut Abstract übertrafen menschliche Experten jedes Modell. Das stimmt, sagt dem Leser aber wenig. DeepSeek-V4-Pro liegt mit 0,700 um weit weniger zurück als die Streuung unter den Werten der Menschen selbst.
Die Menschen gewannen beim Service. Ihr Zuverlässigkeitswert, der Pünktlichkeit beim Versand und den Anteil bearbeiteter Retouren mittelt, lag bei 0,944. Das meiste davon ist Routine: Eine Bestellung geht pünktlich raus oder nicht, und eine Retoure wird bis zur Frist erstattet oder eskaliert. Stornierungen wegen fehlender Ware zählen ebenfalls gegen die Pünktlichkeitsquote, eine versäumte Nachbestellung senkt den Wert also auch. Das beste Modell kam auf 0,852, und nicht versandte Bestellungen und ignorierte Retouren zogen bei der Abrechnung Strafen nach sich.
Beim Geld hatte ein Agent aufgeschlossen. DeepSeeks Business-Wert, das Maß der Studie für das Wachstum des Nettovermögens, lag bei 0,614 gegenüber 0,599 bei den Menschen. Erzielt wurde er gegen verdeckte Nachfrage und ausfallende Lieferanten, also genau dort, wo Urteilsvermögen Menschen eigentlich von Software unterscheiden soll.
Das Aufholen gelingt einem Modell, nicht dem Feld. Die anderen sechs lagen bei demselben Maß zwischen 0,226 und 0,573. Die Autoren ziehen ihren Schluss aus den Fehlerprotokollen: Die verbleibende Lücke liege „weniger im Wissen, was ein guter Shop tut, als in der konsequenten Erledigung routinemäßiger Pflichten”.
Die häufigsten Fehler der Modelle lesen sich wie die schlimmste Woche eines Sachbearbeiters, und sie kosten Geld. Zu knappe Einkäufe und Fehlbestände traten in 26 % der Durchläufe auf, auch bei den Besten: Es wurde zu wenig, zu spät oder bei den Nebensortimenten gar nicht nachbestellt. Das ist das Opus-Geständnis im großen Maßstab. In 60 Durchläufen gab der Agent nie eine einzige Bestellung auf, die meisten davon bei Gemini 3.8 Flash.
Bei den Erstattungen lief es anders schief. Agenten erstatteten zu wenig, Kunden lehnten ab, und die Retouren liefen über ihre Fristen hinaus in Strafen, ein schlechteres Ergebnis als die volle Erstattung. Die Studie rechnet alle drei Fehlerarten dem Business-Wert an und führt sie auf eine einzige Ursache zurück: ein knappes Betriebsbudget, schlecht ausgegeben. Deshalb helfen Regeln. Ein Meldebestand oder ein Versand-Durchlauf verbraucht keine Operationen für Statusabfragen.
Das Versprechen der Anbieter für Agentic Commerce überlässt den Agenten die Routine und den Menschen die Strategie. Salesforces Leitfaden zum Einsatz von KI-Agenten im Commerce bietet einen Assistenten an, der „die Fleißarbeit für Sie erledigt”, und empfiehlt vorgefertigte Agenten für „Routineaufgaben im Commerce (vom Erstellen eines Produktbundles bis zur Bestandsverwaltung)“, damit sich Teams „auf strategischere, wertvollere Arbeit konzentrieren” können.
In StoreBench ging das Geld genau bei dieser Fleißarbeit verloren.
Die beiden unzuverlässigsten Operatoren bauten sich außerdem eigene Automatisierungen, und zwar schlecht. Mit einer Shell ausgestattet, schickten Gemini und Muse Spark von Metas Superintelligence Labs Massenläufe für Versand, Erstattungen und Nachbestellungen los, die auf veralteten Daten beruhten, und verbrauchten ihr Budget für Statusabfragen statt für Schreibzugriffe. Geminis zwei Durchläufe mit nativen Tools kamen im Schnitt auf 0,89, die Shell-Durchläufe auf 0,55. Die Stichprobe ist dünn, aber Muses größere weist in dieselbe Richtung. Die Shell allein erklärt schwache Werte nicht, denn auch Opus, Fable und GPT steuern den Shop in fast jedem Durchlauf über die Shell. Die Studie sagt, die Trennlinie folge dem Modell und nicht der Aufgabe.
Die Einschränkungen schwächen überwiegend die Schlagzeile. Die Menschen lieferten pro Zelle ein ausgewähltes Ergebnis, mit einem erlaubten Wiederholungsversuch, die Modelle drei nicht ausgewählte Versuche pro Zelle. Nach dem ersten abgeschlossenen Versuch gewertet, fällt der Mittelwert der Menschen auf 0,656 und liegt damit hinter DeepSeek und Opus. Die Studie sagt, dieser Wert vereine Coaching, Neuzuweisung und einen betroffenen Durchlauf und sei keine Schätzung eines Trainingseffekts.
Die Menschen arbeiteten zudem mit einer Konsole, die auf der Tool-Oberfläche der Agenten aufbaute, nicht mit ihrer gewohnten Shop-Software, nach einem Briefing mit Heuristiken ähnlich denen von Smart-triage. Die Konsole brachte eine Verlaufsansicht, einen Retouren-Posteingang und zwischengespeicherte Ansichten, die sich ohne Verbrauch einer Operation erneut lesen ließen. Das betrifft unmittelbar die Retourenbearbeitung, bei der die Menschen vorn lagen. Die Menschen erreichten die Bestehensschwelle der Studie in 39 % der Zellen, DeepSeek in 49 %.
Jede Bestehensschwelle liegt in der Mitte zwischen den beiden besten ehrlichen Skripten, die Bestehensquote von 97 % für Smart-triage ist also zum Teil in die Skala eingebaut. Die vollständige Umgebung wird zurückgehalten, niemand von außen kann sie erneut ausführen.
Der stärkste Einwand lautet, die Routineaufgaben seien ein Problem des Harness. Über ein volles simuliertes Jahr unter Claude Code erzielte DeepSeek 0,976 gegenüber 0,700 in den kurzen Szenarien, und fünf der sieben Modelle landeten deutlich über dem Skript, das in jenen Szenarien vorn lag. Wenn schon besseres Scaffolding den Agenten das Nachbestellen, Erstatten und Versenden beibringt, ist der Zaun eine Krücke, die das Harness des nächsten Jahres überflüssig macht.
Das Ergebnis über das volle Jahr kann diese Last nicht tragen. Es hatte keine geskripteten Schocks, ein anderes Harness und mehr Reasoning-Aufwand, und die Autoren sagen, es lasse den Effekt des Harness nicht isolieren. In vier von neun Versuchen behauptete Gemini, ein Hintergrundprozess der Simulation führe den Shop, und wartete, statt zu handeln. Ein Versuch von GPT-5.6 Sol erklärte den Shop in Fenster 185 von 365 für abgeschlossen und hörte auf. Eine Regel, die in jedem Fenster alle offenen Bestellungen versendet, glaubt nicht an Hintergrundprozesse.
Für einen Händler lautet die Entscheidung, welche Entscheidungen er dem Agenten abnimmt. Meldebestände für die ruhigen Sortimente, volle Erstattungen innerhalb der Frist und ein Versand-Durchlauf in jedem Fenster gehören in Code, den der Agent nicht überschreiben kann. StoreBench hat diesen Hybriden nicht getestet, die Argumentation stützt sich auf die Fehlerprotokolle. Im Juli führte uns RetailBench zu dem Schluss, dass ein glaubwürdiger Einsatz einen Menschen braucht, der den Shop im Blick behält. Diese Protokolle legen nahe, dass sich ein Großteil dieses Beobachtens schon vor Schichtbeginn niederschreiben lässt.