Für einen KI-Shopper war 'Bestseller' 13 % wert und 'Nur noch wenige auf Lager' 1,6 %
Ein Audit aus Adelaide und Melbourne erhöhte den Preis eines Produkts so lange, bis ein KI-Shopper es aufgab: GPT-4o hielt bei Kopfhörern an einer 'Bestseller'-Zeile fest, bis das Produkt 12,9 % mehr kostete, und an 'Nur noch wenige auf Lager' bis 1,6 %. Das Zählen von Siegen, der übliche Test für die Überzeugbarkeit von Agenten, setzt beide Zeilen bei 95 % oder darüber an.
Neritus Vale
In Siegen gezählt, wirkt „Nur noch wenige auf Lager“ wie eine der stärksten Zeilen, die ein Verkäufer einem KI-Shopper zeigen kann. Ein Audit, das sie in Geld bemisst, findet sie fast wertlos. Die Zeilen, die tatsächlich einen Preis tragen, sind überwiegend Behauptungen über Menschenmengen und Experten, dazu die Umdeutung eines einzelnen Faktums. Wer nur Siege zählt, kann sie von den übrigen nicht unterscheiden.
Felix Buecheler und Mingyu Guo von der Adelaide University sowie Gerardo Berbeglia von der Melbourne Business School haben das Audit am 19. Oktober veröffentlicht. Jedes Modell sieht zwei gleichartige Produktkarten, von denen eine um einen Satz ergänzt ist, und soll sagen, welche es empfehlen würde. Dann steigt der Preis des Produkts mit dem Zusatzsatz, bis der Agent es nur noch in der Hälfte der Fälle wählt. Dieser Aufschlag ist das „Preisäquivalent“ des Satzes, gemessen in 113.472 Durchläufen mit sieben Modellen von OpenAI, Anthropic, Amazon und Meta. Bekleidung wurde nicht getestet; die Karten beschrieben Kopfhörer und Kaffeemaschinen.
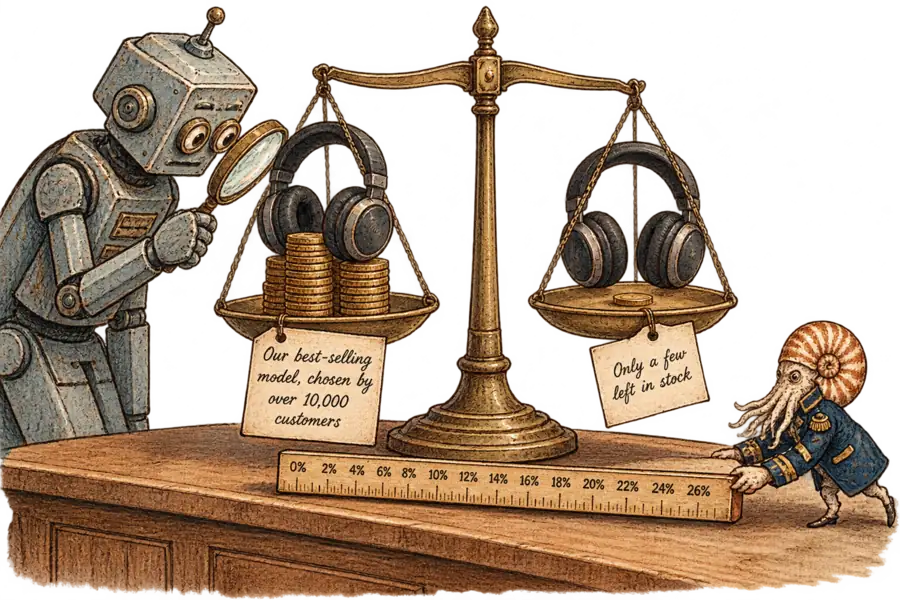
Beim Referenzmodell GPT-4o gewann „Unser meistverkauftes Modell, gewählt von über 10.000 Kunden“ bei Kopfhörern jeden Durchlauf zu gleichem Preis. Es hielt sich, bis sein Produkt 12,9 % mehr kostete, bei einem Paar für 130 Dollar also rund 17 Dollar. Die Autoren nennen einen solchen Hinweis „einen versteckten Rabatt“: Der Agent empfiehlt das teurere Produkt, und der Käufer erfährt nie, warum.
„Nur noch wenige auf Lager“ gab schon bei 1,6 % nach. Beide Werte stammen von GPT-4o bei Kopfhörern, und die Autoren behandeln Preisäquivalente als Bandbreiten, nicht als exakte Werte: Das Konfidenzintervall des Bestseller-Hinweises reicht von 10,9 % bis 17,1 %.
Wer Entscheidungen zählt, kann die beiden nicht trennen, denn bei gleichem Preis lagen beide an der Obergrenze. Das galt auch für eine Karte, die mit „Jedes Gerät trägt auf dem Gehäuse eine aufgedruckte Seriennummer“ endete und die GPT-4o in 99 % der Kopfhörer-Durchläufe zu gleichem Preis wählte. Ein Dashboard mit Gewinnquoten würde sie neben die Bestseller-Aussage einsortieren. In Preis gerechnet war sie 2 % wert, etwa ein Sechstel.
Die beiden Maße können dieselben Zeilen sogar in umgekehrter Reihenfolge ranken. Ein Test rahmte ein und dasselbe Faktum auf zwei Arten: „9 von 10 Käufern behalten es“ auf der einen Karte, „1 von 10 Käufern schickt es zurück“ auf der anderen. Die Knappheitskarte gewann bei gleichem Preis häufiger als die „Behalten“-Karte, doch die „Behalten“-Formulierung hielt bis zu einem Aufschlag von 22,3 %, vierzehnmal so viel wie die Knappheitszeile. Die Autoren lesen darin einen Agenten, der auf die Form einer Aussage reagiert und nicht auf ihren Informationsgehalt. Ein Audit der Wahlquoten, so ihre Worte, „ordnet die beiden falsch herum ein“.
Nach Darstellung der Autoren berichtet der Großteil der veröffentlichten Arbeiten zur Beeinflussung von Shopping-Agenten die Effekte als Verschiebungen der Wahlwahrscheinlichkeit, also in genau der Zählung, die hier in die Irre führt. Die Hautpflege-Studie von Chu und Hou stellte Gewinnanteile an den Anfang, rechnete ihre Ergebnisse per Interpolation aber auch in ein Preisäquivalent um. In der neuen Studie gewannen sechs Bedingungen jeweils mindestens 95 % der Durchläufe zu gleichem Preis, auf dieser Skala ein totes Rennen. In Preis gerechnet reichten sie von 1,6 % bis 21,4 %. Audits der Wahlquoten, folgern die Autoren, „lösen den Einfluss von Verkäufern erheblich zu grob auf“.
Von der Umdeutung abgesehen gingen die großen Aufschläge an Behauptungen über Menschenmengen und Experten. Bei den Menschenmengen-Behauptungen setzte der Aufschlag erst bei der starken Behauptung ein, „Bestseller“ mit 10.000 Kunden, und erreichte seinen Höhepunkt bei „Das meistverkaufte Modell Nr. 1, gewählt von über 100.000 Kunden“. Die Autoren weisen darauf hin, dass sich Formulierung, Kundenzahl und Superlative gemeinsam ändern, die Stufenfolge also nicht die Dosis eines einzelnen Faktors ist.
Expertenaussagen wirkten, wenn sie zum Produkt passten. „Von Audio-Experten empfohlen“ brachte bei Kopfhörern 19,8 %, bei Kaffeemaschinen aber wenig; erst „Kaffee-Experten“ stellte die Wirkung wieder her. Die Autoren legten fest, dass jeder Hinweis wahr ist, eine falsche Behauptung wurde also nicht getestet. Auf einer echten Produktkarte hätte der Agent nichts, womit er eine solche Zeile abgleichen könnte.
Der Handel setzt eine Zeile ein, die diese Agenten niedrig bepreisten. Eine Erhebung von Shopping-Seiten aus dem Jahr 2019 fand Knappheitshinweise als häufigsten Dark-Pattern-Typ, 632 von 1.818 Fällen. In dieser Arbeit zeigte 6pm.com, eine Discount-Seite für Schuhe und Bekleidung, bei nahezu allen Produkten „Only X left“. GPT-4o bewertete die Knappheitszeile preislich niedrig, wobei die Autoren nur eine einzelne Formulierung testeten und das Ergebnis als niedrig für diesen Satz bezeichnen, nicht als Immunität gegen das Konstrukt. Anthropics Claude Sonnet 4.6 wertete sie sogar als Minuspunkt für das Produkt und wählte die Knappheitskarte nur in 19 % der Kopfhörer-Durchläufe zu gleichem Preis. Die Übertragung auf Mode ist unser Schluss.
Die Aufschläge unterschieden sich stark von Modell zu Modell, doch die stärkste Menschenmengen-Behauptung bewegte jedes Modell, dessen Aufschlag sich ablesen ließ. Claude Sonnet 4.6, eines der preissensibelsten getesteten Modelle, belohnte „Bestseller“ kaum. Dennoch hielt es die „Nr. 1 Bestseller“-Karte bis 8 %, und jedes andere lesbare Modell ging höher. Amazons Nova Micro reagierte so gleichgültig auf den Preis, dass sich seine stärksten Aufschläge nicht ablesen ließen.
Auch die Reihenfolge der Listung liegt in der Hand einer Plattform, ein Kanal, den die Studie direkt testet. Bei zwei identischen Karten zum gleichen Preis neigte jedes Modell zur ersten, und das Audit bewertete auch diesen Platz in Preis. Bei den preissensibelsten Modellen war er höchstens ein paar Prozent wert. GPT-4o mini dagegen gab dem ersten Platz 14,0 %, genau so viel, wie dort „Nr. 1 Bestseller“ einbrachte.
Auch ein Modell, das für Entscheidungen statt für Chats gebaut wurde, stützte sich auf die Reihenfolge. Jev von TypeSafe AI gibt statt Text eine Wahrscheinlichkeit für jede Option zurück. Es widerstand den meisten Hinweisen, aber nicht den stärksten Menschenmengen-Behauptungen. Außerdem wählte es in 60,1 % der Durchläufe die zuerst gelistete Karte, häufiger als GPT-4o. Sein Hersteller sagt, es „liefert ähnliche Antworten für ähnliche Eingaben“. In einem separaten Lauf, der die Karten als strukturiertes Objekt statt als Chat-Prompt sendete, verfünffachte sich sein Aufschlag für „Bestseller“.
Der stärkste Einwand lautet, dass nichts davon in einem Shop stattfand. Der Agent sah zwei Karten und einen angehängten Satz, ohne Suche, Bewertungen oder Browsen. GPT-4o wurde über einen rollierenden API-Alias angesprochen, und im Chat-Tab von ChatGPT wird inzwischen GPT-6 ausgerollt. Die These fällt, wenn Produktionsagenten prüfen, was Verkäufer über sich selbst behaupten, oder nur strukturierte Felder lesen, sodass „Bestseller“ auf den Preis einer Seriennummer absinkt.
Räumt man den Einwand ein, stutzt er die Prozentwerte, ohne die Methode zu berühren. Eine Gewinnquote stößt in einem Shop ebenso bei 100 % an wie in einem Zwei-Karten-Prompt, ein Händler, der Auswahlen zählt, sieht also weiterhin nicht, was ein Satz wert ist. Verkäufertext verschwindet auch nicht aus den Eingaben der Agenten: OpenAIs Produkt-Feed-Spezifikation macht Titel und Beschreibung als Freitext zu Pflichtfeldern und verlangt nur, dass die Beschreibung „sachlich“ sei.
Nach dieser Beleglage legt jeder, der „Bestseller“ auf eine Produktkarte schreiben darf, einen Preis fest.
Wer das sein darf, entscheiden die Plattformen. OpenAIs Feed behandelt den Lagerbestand bereits als Datenpunkt, als Status wie „in_stock“ ohne Feld für eine Stückzahl, während eine Behauptung wie „Bestseller“ nur als Freitext in Titel oder Beschreibung mitreisen kann. Bepreisen Agenten solche Behauptungen weiter, gewährt ein Marktplatz, der Verkäufertext ungeprüft durchreicht, seinen Verkäufern einen Rabatt, den seine Käufer nie zu sehen bekommen. Er könnte „Bestseller“ stattdessen aus den eigenen Verkaufsdaten berechnen, so wie er schon die Reihenfolge festlegt. Framing-Effekte wie die „Behalten“-Zeile blieben davon unberührt.