Kein Modell in Amazons Sofa-Benchmark konnte eine KI-Bearbeitung zuverlässig prüfen
Der V-CAPE-Benchmark von Amazon-Forschern fragte Vision-Language-Modelle, ob KI-bearbeitete Produktfotos das Produkt unverändert zeigen. Mit einem schlichten Prompt erreichte das beste Modell über beide Teilmengen 63,5 %; wer alles durchwinkt, kommt auf etwa die Hälfte. Photoroom verkauft ein automatisiertes Fidelity-Gate für Mode, ließ den eigenen Benchmark aber von Menschen bewerten, und Etsys Regeln überlassen die letzte Prüfung den Käufern.
Neritus Vale
Forscher von Amazon haben getestet, ob eine KI ein KI-bearbeitetes Produktfoto prüfen kann. Das Ergebnis überlässt die Aufgabe den Menschen. Ihr Benchmark V-CAPE, veröffentlicht am 28. Oktober, fragt Modelle, ob ein Produkt die Bearbeitung unbeschadet überstanden hat. Über seine beiden Teilmengen erreichte das beste getestete Modell mit einem schlichten Prompt 63,5 % – näher am Münzwurf als an einem Prüfer. Etsy und Vestiaire Collective lassen KI inzwischen Angebotsfotos überarbeiten; Etsy überlässt misslungene Bearbeitungen der Haftung der Verkäufer, Vestiaire verlässt sich auf das Fidelity-Versprechen seines Dienstleisters.
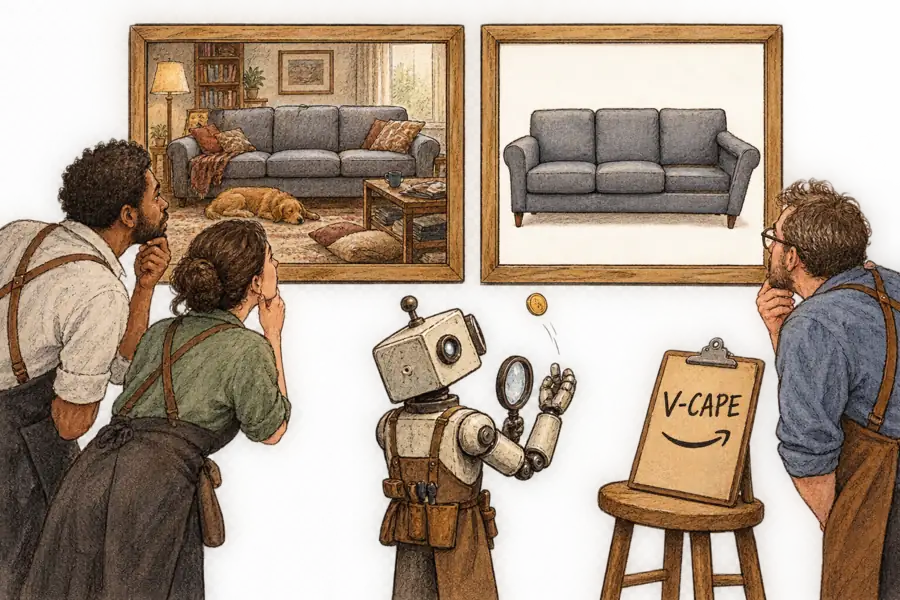
Im Benchmark wird nichts getragen. Die reale Teilmenge umfasst 20.000 Paare aus Sofafotos in öffentlichen E-Commerce-Angeboten: Jedes wurde von einem Gemini-Modell auf Weiß freigestellt und, wo nötig, von einem zweiten nach links gedreht (Abschnitt 3.1, Anhang A.1). Eine synthetische Teilmenge gleicher Größe rendert Stühle, Tische, Lampen und Kissen. Die Autoren betonen, ihre Pipeline spiegele „kein Produktivsystem” wider.
Die Bearbeitung ähnelt der, die der Resale-Modehandel inzwischen einkauft, geht aber weiter. Bei jedem neuen Vestiaire-Angebot „entfernt Photorooms API den Hintergrund des Hauptfotos, fügt einen Schatten hinzu, zentriert den Artikel und korrigiert das Licht”, so Photoroom. Der Prompt von V-CAPE verlangt einen „PURE WHITE background” mit „light shadows”, entfernt aber zusätzlich die ursprüngliche Beleuchtung sowie Menschen, Haustiere und Dekoration.
Die Musterlösung stammt von Menschen. Drei geschulte Annotatoren beurteilten jedes Paar, die Mehrheit entschied, und nach fünf Abstimmungsrunden erreichte ihre Übereinstimmung ein Fleiss-Kappa von 0,77 (Abschnitt 3.3).
Die reale Teilmenge ist so ausbalanciert, dass das Durchwinken jeder Bearbeitung die halbe Punktzahl bringt. Mehrere Modelle kamen dem nahe, jedes Paar gleich zu beantworten – das Paper spricht von „nahezu universeller Ablehnung oder Annahme” (Abschnitt 4.1).
Weder Größe noch Prompting rettete die Modelle. Das Feld reichte von offenen Qwen3-, Gemma- und Mistral-Modellen bis zu Anthropics Claude und Amazons eigenem Nova; ein GPT- oder Gemini-Modell wurde nicht als Prüfer getestet. Ein automatisch optimierter Prompt brachte nach Angaben der Autoren drei bis fünf Punkte – allerdings teilt dieser Prompt dem Modell mit, dass seine Ground-Truth-Labels korrekt sind, was den Gewinn womöglich schönt. Sie folgern, der Engpass liege „nicht nur im Instruktionsdesign, sondern in den zugrunde liegenden Wahrnehmungsfähigkeiten”.
Bei den realen Sofas bewirkte Fine-Tuning noch weniger. Die Autoren trainierten ein kleines Qwen-Modell auf 55 Beispielen, davon 35 reale (Tabelle 1). Die Genauigkeit blieb bei etwa 52 %. Der F1-Wert schnellte hoch – das typische Zeichen eines Modells, das vom Ablehnen von allem zum Annehmen von allem gewechselt ist.
Prämisse und Schlussfolgerung des Papers widersprechen sich. Das Abstract nennt manuelle Prüfung im großen Maßstab „nicht praktikabel”. Der Anhang zu gesellschaftlichen Auswirkungen sagt, die Ergebnisse legten nahe, dass „menschliche Aufsicht auf absehbare Zeit unverzichtbar bleibt”. Jeder Marktplatz, der KI Fotos bearbeiten lässt, steht zwischen diesen beiden Sätzen.
Photorooms Fidelity-Benchmark wurde wie der von Amazon von Menschen bewertet. Er schickte Kleidung, Schuhe, Taschen, Schmuck und Accessoires durch vier Bildbearbeitungsmodelle zur Erzeugung virtueller Models – eine andere Aufgabe als die Bereinigung bei V-CAPE – und fragte bei jedem Ergebnis: „Ist das noch dasselbe Produkt?” Mindestens drei geschulte Annotatoren prüften jedes Bild, und eine einzige Markierung bedeutete durchgefallen. Diese Hürde ist strenger als die Mehrheitsentscheidung bei V-CAPE. Das beste Modell bestand in 29,0 % der Fälle.
Keiner der beiden Benchmarks ließ eine Maschine seine Musterlösung schreiben.
Die Prüfung, die Photoroom verkauft, ist eine Maschine. In einem Proof of Concept lief AI Ironing mit dem Fashion Fidelity Rater als Gate. Das System habe „über 2 Millionen Garment-Bilder für einen Modemarktplatz verarbeitet und nur sieben zur menschlichen Prüfung weitergeleitet, womit die Fidelity-Kriterien der Marke erfüllt wurden”, schreibt der Anbieter.
Sieben von zwei Millionen ist die Zahl, die ein nahezu perfekter Rater liefern würde. Ein Rater, der fast alles durchlässt, würde dieselbe Handvoll liefern, und V-CAPE fand allgemeine Modelle mit genau dieser Angewohnheit. Um beide zu unterscheiden, braucht es ein menschliches Audit dessen, was durchgegangen ist. Photorooms übrige Zahlen – 99,9 % der Prüfungen ohne Review in einem Live-Einsatz im Resale und keine negative Wirkung auf die Retourenquote in einem sechswöchigen Test – prüfen nicht, ob der Rater mit einem Menschen übereinstimmt.
Etsys erklärtes Ziel ist das Vertrauen der Käufer, doch das eine unbearbeitete Foto, das die meisten Angebote inzwischen brauchen, gibt Käufern zugleich ein Vorher-Bild an die Hand, an dem sie die KI-bearbeiteten Bilder messen können – und diese dürfen den Artikel nicht „anders erscheinen lassen”. Beim Hochladen erkennt Etsy KI-generierte Bilder und gibt Tipps; zudem heißt es, man plane, „diese Anforderungen im Laufe der Zeit proaktiver durchzusetzen, sobald Angebote erstellt werden”. Ob diese Prüfungen eine Bearbeitung mit ihrem Ausgangsfoto vergleichen, sagt Etsy nicht. Zeigt der Fall eines Käufers einen Artikel, der sich „wesentlich von Ihrem Angebot unterscheidet”, „kann der Verkäufer verpflichtet sein, dem Käufer den Betrag zu erstatten”.
Gilt das Muster des Papers auch außerhalb von Möbeln, wird es bei Kleidung schwieriger. Sechs von zehn abgelehnten Sofa-Bearbeitungen scheiterten an der Geometrie (Tabelle A.1), einem Fehler, den die Autoren als grob einstufen. Die Erkennung feinerer Fehler bei Textur, Farbe oder Material bleibe „durchweg nahe am Zufall”, berichten sie. Photorooms QA-Leitfaden liefert die Behauptung des Anbieters selbst: „Modebilder bergen mehr Fidelity-Risiko pro Pixel als die meisten Produktkategorien.”
Der stärkste Einwand lautet, dass kein Marktplatz Fotos mit einem allgemeinen Modell und einem Prompt prüfen würde. Photorooms Rater sind kategoriespezifische Modelle, „heute verfügbar für Food und Fashion”, und hartnäckige Fehlschläge gelangen „mit einem Konfidenzwert” zu einem Menschen. V-CAPEs einziges feinabgestimmtes Modell sah 55 Beispiele. Damit die These fällt, müsste ein speziell gebauter Rater so oft mit geschulten Prüfern übereinstimmen wie diese untereinander – und wissen, wann er unsicher ist.
Photorooms Beiträge berichten von keinem solchen Test, und sein Leitfaden nennt die menschliche Prüfung weiterhin „den Ausnahmepfad, nicht den Standard”. In voller Stärke verschiebt der Einwand die Menschen ans Ende der Kette, wo sie dennoch entscheiden.
Die Prüfung verschwindet nicht, wenn eine Maschine sie nicht leisten kann; sie wandert. Ein Marktplatz kann Menschen dafür bezahlen, Bilder zu vergleichen, bevor ein Angebot online geht. Oder er lässt Käufer das Paket mit dem Foto vergleichen, wie es Etsys Regeln heute tun. Bleiben die Maschinen dort, wo V-CAPE sie vorfand, ist der günstigste Prüfer der Kunde, und die Rechnung des Verkäufers kommt als Erstattung.