Kleidungssuche erreicht im Ranking 0,87. Gefragt, wie nah jeder Treffer dran ist, liegt sie bei 51 %.
Ein Benchmark von Forschern bei Glance zeigt: Handelsübliche Suchmodelle erreichen beim Ranking kurzer Listen von Katalogprodukten bis zu 0,87, bewerten aber nur etwa in der Hälfte der Fälle richtig, wie genau ein Produkt zur Suchanfrage passt. Nach unserer Rechnung würde ein Modell, das ein Produkt nicht von seiner nahen Variante unterscheiden kann, beim Ranking-Maß alle schlagen. Händler sollten deshalb von Anbietern Werte auf Variantenebene und je Attribut für den eigenen Katalog verlangen.
Neritus Vale
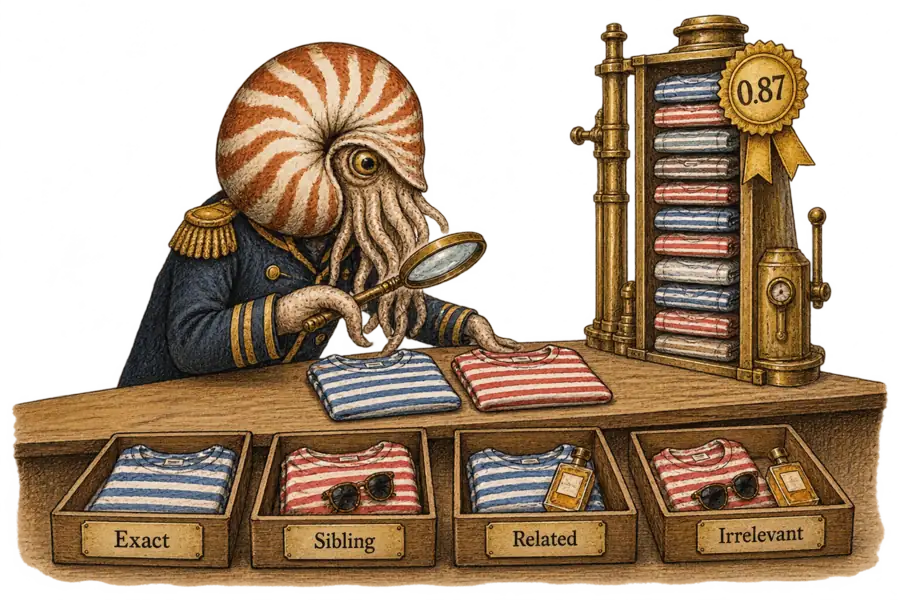
Ranking-Werte schmeicheln der Kleidungssuche: Ein Modell kann beim Standardmaß 0,87 erreichen und trotzdem in etwa der Hälfte der Fälle falsch einschätzen, wie genau Produkte zur Anfrage passen. FASHION-RQ, ein am 13. Oktober auf arXiv veröffentlichter Benchmark, meldet beide Ergebnisse für dieselben zehn handelsüblichen Textsuchmodelle. Der Ranking-Wert belohnt es, die richtige Produktfamilie weit oben in einer kurzen Liste zu platzieren. Die Kleidungssuche muss aber entscheiden, ob ein Artikel der exakte Treffer, eine nahe Variante oder nur verwandt ist, und genau das prüft die Benotung.
Sechs Glance-Forscher bauten den Benchmark aus der Struktur eines Katalogs, ganz ohne menschliche Relevanzbewertung. Die App von Glance, so TechCrunch, steckt ein KI-Abbild der Shopper in Outfits und verdient über Affiliate-Provisionen. Der Katalog, ein öffentlicher Kaggle-Datensatz, den die Autoren Myntra zuschreiben, umfasst 44.446 Produkte, von Hemden bis Parfüm. Ein Modell ordnet jedes Produkt einem dreiteiligen Code zu, der von grob zu fein verläuft, wie ihn generative Empfehlungssysteme ausbuchstabieren. Gemini schrieb die Suchanfragen, die „ein echter Shopper eintippen würde“, für jede Gruppe. Die Noten folgen aus dem Code: Ein Artikel, der alle drei Teile teilt, ist exakt, bei den ersten beiden ein Sibling, nur beim ersten verwandt, bei keinem irrelevant.
Siblings sind die Fast-Treffer der Bekleidung. Das Training schob den zweiten Teil in Richtung Produkttyp und den dritten in Richtung Attribute wie Farbe, Geschlecht, Saison und Preisklasse. Im Baum des Diagramms steht ein rotes T-Shirt neben dem blauen, nach dem der Shopper gefragt hat. Wir lesen das so: Ein Sibling ist meist das richtige Kleidungsstück in der falschen Version.
Beim Ranking-Maß kamen auf jede Anfrage rund fünfzehn Produkte, etwa die Hälfte davon nur als verwandt oder irrelevant bewertet, und nDCG@10 bewertet die obersten zehn. Das Paper nennt keine Gain-Funktion; nach unserer Rechnung erreicht eine zufällige Anordnung eines solchen Pools je nach Konvention zwischen 0,55 und 0,62. Ein Modell, das die Noten perfekt ordnete, exakte Treffer und Siblings aber als eins behandelte, käme auf 0,89 bis 0,95.
Dieses Modell, das das blaue T-Shirt nicht vom roten unterscheiden kann, würde bei diesem Maß jedes System im Paper schlagen.
Die Bewertungsaufgabe nimmt dieses Polster weg, denn ein Fast-Treffer bringt nichts. Jede Anfrage umfasste rund acht Produkte, gleichmäßig auf die vier Noten verteilt, Raten liegt also in einem von vier Fällen richtig. Das beste Modell, Qwen3-Embedding-4B, bewertete 51 % korrekt. Das Paper sagt nicht, wie aus Ähnlichkeitswerten Labels wurden.
Der Sibling-Test isoliert den schwierigen Teil. Jede Anfrage stellt ein korrektes Produkt drei oder vier seiner Siblings gegenüber, und gewertet wird, ob es unter den ersten drei von fünf landet. Eine zufällige Anordnung von fünf schafft das in 60 % der Fälle. Der Sieger mit 83 %, SPLADE++, ist ein Sparse-Modell, aufgebaut auf BERT für allgemeine Passagensuche. Qwens 4B-Embedding-Modell schlug sein 8B-Schwestermodell knapp, obwohl das 8B-Modell beim gewichteten Relevanzwert des Papers auf Platz eins liegt; Größe half also nicht verlässlich. Das Paper sagt, es berichte hier @1-Werte, doch Tabelle 2 zeigt nur @3.
Die Attributwerte zeigen, wo die Fehler liegen. Produkttyp und Geschlecht, die der Katalog in strukturierten Feldern führt, erreichten bei den stärkeren Modellen über 0,93. Das Material musste aus Freitext extrahiert werden und lag bei etwa 0,52. Das sind Match-Scores, keine Trefferquoten: Ein naher Farbton bringt Teilpunkte. Der Stil bewegte sich kaum über alle zehn Modelle hinweg, selbst bei einem, das nie für die Suche trainiert wurde, die Spalte spiegelt also wahrscheinlich eher die Bewertung wider.
Auch der Lösungsschlüssel verlangt dieselbe Lesart, denn relevant ist, was das Code-Modell zusammengruppiert hat. Ein Cluster blieb bestehen, wenn mindestens vier von fünf seiner Artikel denselben Produkttyp teilten. Jeder Artikel eines bestehenden Clusters zählt für alle seine Anfragen als exakt, und der Prompt verlangte pro Haupt-Produkttyp eine eigene Anfrage. Eine auf einen Typ gerichtete Anfrage kann daher die anderen Typen als exakt zählen. Die Tabelle des Papers nennt bei einer Codebuchgröße von 64 eine gewichtete Farbreinheit von 87,9 %. Die Autoren räumen ein, die abgeleitete Struktur „nähere menschliche Urteile an, ersetze sie aber nicht“.
Die Humanstudie prüfte die Anfragen, nicht die Labels. Zweiunddreißig Rater bewerteten je 20 Anfragen aus drei Quellen: dem Benchmark, einem generischen LLM und echten Shoppern. Die echten, mit CHAT bezeichnet, stammten aus einer nicht genannten Quelle und waren teils von LLM-Judges, die über die Intention abstimmten, vorgefiltert worden.
Die Benchmark-Anfragen waren bei der Natürlichkeit mit echten vergleichbar und übertrafen sie bei der Klarheit der Intention, 3,91 gegenüber 2,83 auf einer Fünf-Punkte-Skala. Die Autoren werten das als Beleg für die „Validität für die Bewertung unter realen Bedingungen“. Diese Lücke ist zugleich der Abstand zwischen Test und echter Suche, wo die am schlechtesten bewertete Anfrage der Studie mit 1,66 „Dunkelgrüne Teile.“ lautete. Weil auf Intention vorgefiltert wurde, schmeichelt die 2,83 der echten Suche womöglich.
Der stärkste Einwand lautet, dass die 51 % nicht die Modelle, sondern den Lösungsschlüssel anklagen. Niemand hat die Cluster geprüft, daher würde selbst ein fehlerfreies Modell einigen Labels widersprechen. Eine strenge Vier-Klassen-Bewertung bestraft jede Abweichung voll, während ein Ranking-Maß einen Fast-Treffer verzeiht. Damit die These fällt, müsste der Ranking-Wert beschreiben, was ein Shopper in einem Live-Shop sieht.
Das tut er nicht, und das Rauschargument wirkt in beide Richtungen. Ein Live-Katalog liefert einem Modell keine fünfzehn Kandidaten, die Hälfte davon aus anderen Zweigen; er liefert ihm jedes T-Shirt auf Lager. Der Sibling-Test, ebenfalls ein Ranking, kommt dieser Lage am nächsten. Sind die Labels zu grob, um die Variantenurteile eines Modells zu bewerten, sind sie auch zu grob, um seine 0,87 zu zertifizieren.
Händler können sich das Design des Benchmarks zu eigen machen, bevor ihn jemand nachrechnen kann; Code und Daten folgen erst „nach Annahme“. Sie können von Anbietern Sibling- und Attributgenauigkeit auf dem eigenen Katalog verlangen, gemessen an Labels, die ein Merchandiser geprüft hat, dazu die Quote, mit der der richtige Artikel auf Platz eins steht. Ein Anbieter, der nDCG auf einer kurzen Liste nennt, berichtet, wie gut das Modell das falsche Regal meidet. Händler können diese Zahl akzeptieren oder fragen, welches Hemd aus dem richtigen Regal ihr Shopper bekommt.