Packungen grau übermalt – und ein KI-Shopper gibt dem „A“ trotzdem 45 % seiner Wahrscheinlichkeit
Ein Paper, das mit Intellicia, einem koreanischen Anbieter synthetischer Konsumenten, entstanden ist, zeigt: KI-Shopper, die aus Haushaltsdaten gebaut werden, treffen Einkaufskörbe ungefähr so gut wie die früheren Einkäufe der Haushalte selbst. Vor einem einzelnen Regal bevorzugen dieselben Modelle den Buchstaben A und bestimmte Positionen im Bild. Die Korrektur wird vor allem an den eigenen Präferenzen der Modelle gemessen, und jedes Regal wird als Supermarktregal präsentiert.
Neritus Vale
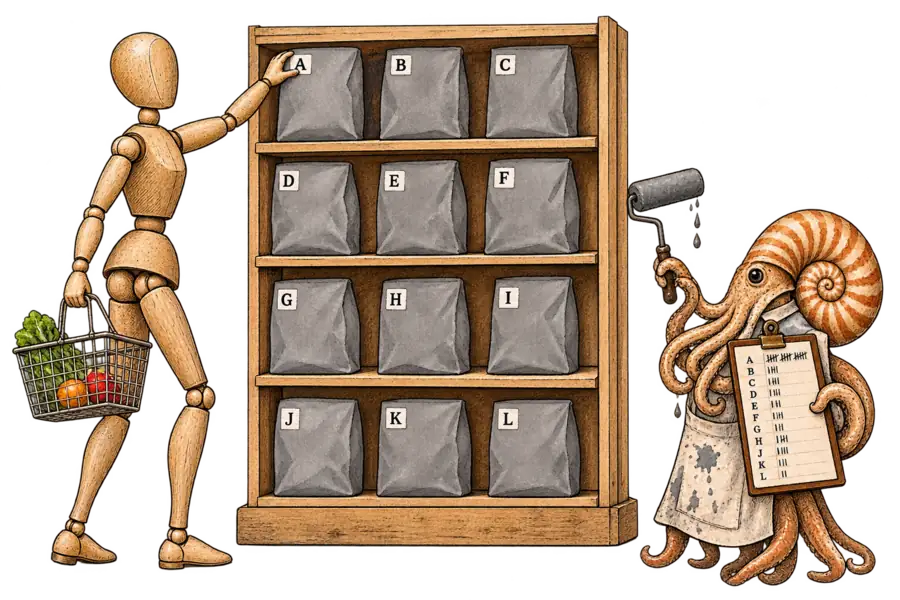
Auch nachdem die beschrifteten Produkte auf echten Regalfotos grau übermalt waren, legte Qwen3.8-Flash 45,3 % seiner Antwortwahrscheinlichkeit auf das mit A markierte. Das Ergebnis stammt aus einem Validierungspapier, das ein Anbieter synthetischer Konsumenten mitverfasst hat. Dessen KI-Shopper treffen Einkaufskörbe im Aggregat recht gut, doch eine einzelne Regalwahl, die Einheit eines Packungstests, bewertet neben dem Produkt auch den Antwortbogen.
Zwei der drei Autoren, Woongki Kim und Seungkook Baek, arbeiten bei Intellicia, einem koreanischen Start-up; der korrespondierende Autor, Minhyeok Lee, ist an der Chung-Ang University. Ein staatliches Programm, Deep-Tech TIPS, förderte die Arbeit. Die Website von Intellicia verkauft Umfragen, die von synthetischen Konsumenten beantwortet werden, ab 1,2 Mio. ₩ pro Projekt. Das Paper sagt an keiner Stelle, was Intellicia verkauft.
Zu den Partnern von Intellicia zählt BGF Retail, der Betreiber der koreanischen CU-Convenience-Stores. Im Juli unterzeichneten beide ein Memorandum, um ParaStore, die Digital-Twin-Software von Intellicia, einzusetzen und „Produktplatzierung, Kundenbewegung und Merchandising zu simulieren“; Baek, der Geschäftsführer, nahm an der Unterzeichnung teil. Die Shopper des Papers gingen durch ein Geschäft in TwinStore, das Lee auf ParaStore aufgebaut hat.
Jeder Shopper wurde zufällig Claude Haiku 5.5, Qwen3.8-Flash oder GPT-6 Luna zugewiesen. Das Modell plante den Einkauf anhand eines Geschäftsverzeichnisses und wählte Produkte aus Regalbildern. Einige Shopper wurden aus Haushaltsdaten gebaut; die russischen und taiwanischen hatten nur eine Kundenbeschreibung. Ihre Käufe wurden an sechs öffentlichen Datensätzen aus den USA, Russland und Taiwan gemessen.
Das Kernergebnis ist Gleichstand mit dem Gedächtnis. Bei der Trefferquote des Papers, also wie oft die Kategorien eines Warenkorbs in späteren Einkäufen eines Haushalts auftauchen, erreichten synthetische Warenkörbe 0,291 – auf Augenhöhe mit den früheren Einkäufen der Haushalte selbst. Gemessen daran liegt die Latte niedriger, als es klingt. Eine Liste, die aus denselben Kaufraten gezogen wird, ganz ohne Modell, kam auf 0,307. Die Liste gibt die Daten per Konstruktion wieder, während die Modelle sie nur als Anhaltspunkte erhalten.
Das „doppelt so stark“ aus dem Abstract, ein Vergleich mit einer trainierten Regression, ist das Verhältnis zweier schwacher Korrelationen. Das Maß korreliert, wie weit die Kategorieanteile jeder demografischen Gruppe in synthetischen und echten Käufen vom Durchschnitt abweichen. Gegeben nur die Durchschnitte der Altersgruppen, erreichten die synthetischen Shopper etwa 0,28, womit der größte Teil des Gruppenmusters ungeklärt bleibt. Dieselbe Tabelle setzt die Kaufratenliste bei Gruppenunterschieden auf 0,16, hier schneiden die Modelle also besser ab als die schlichte Liste.
Im Ausland reproduzierten die Shopper ohne Anpassung einige echte Muster und verfehlten andere. Synthetische Gruppen bildeten den höheren Alkoholkauf russischer Männer und mittleren Alters mit einer Korrelation von 0,56 nach und trafen fast den Mehrbetrag, den Kunden aus weit entfernten Regionen Taiwans pro Einkauf ausgeben. Der Haupttext nennt pro Markt eine Kennzahl. Eine Tabelle im Anhang zeigt dieselben russischen Shopper, die den Kauf von Eigenmarken verkehrt herum abbilden, bei −0,81.
Jedes Regal, das das Paper testet, wird dem Modell als Supermarktregal präsentiert, und keine seiner 24 Produktkategorien ist Bekleidung.
Der Benchmark des Papers, ShelfSight, rotiert 12 Produkte durch jede Position eines Regalmoduls und beschriftet sie von A bis L in Lese-, umgekehrter oder zufälliger Reihenfolge. Ein Faktormodell zerlegt jede Wahl in einen Produkteffekt und zwei „Antworteffekte“, für den Buchstaben und für die Position.
Die Autoren benennen das Risiko selbst: „Ein synthetischer Packungstest, der diese Antworten für bare Münze nimmt, schreibt einer neuen Packung den Vorteil ihres Regalplatzes und ihres Buchstabens gut.“ Auf gerenderten Regalen vervielfachte der Buchstabe A die Chance von GPT-6 Luna, einen Artikel zu wählen, um 8,8 – relativ zu einem durchschnittlichen Buchstaben an derselben Position. Die Umbenennung des Regals in M bis X zeigte, dass der Effekt dem A selbst gehört. Auf echten Fotos impliziert der Koeffizient von GPT-6 Luna bei derselben Umrechnung etwa das 25-Fache, wiederum relativ zu einem durchschnittlichen Buchstaben.
Auf gerenderten Regalen bevorzugen die drei gehosteten Modelle zudem die Bildoberseite. Sie ziehen das oberste Regal dem untersten mit 0,66 bis 1,18 Log-Odds vor. Dreht man das Bild auf den Kopf, bevorzugen zwei von ihnen, Qwen3.8-Flash und Claude Haiku 5.5, stattdessen das physisch unterste Regal.
Die zwei kleinen offenen Modelle im Benchmark neigen in die andere Richtung, zum untersten Regal, bei −0,32 und −0,54. Der Sog nach oben ist eine Angewohnheit der gehosteten Modelle, nicht aller getesteten.
Menschen, die aus Regalfotos wählen, zeigen 0,11, was das Paper als nicht signifikant ausweist; der Wert stammt aus einer einzigen Studie. In einer Textliste bevorzugen Claude Haiku 5.5 und GPT-6 Luna das oberste Regal nur dann, wenn es zuerst genannt wird – eine Erste-Position-Gewohnheit, über die wir berichtet haben, und zwar bei reinen Text-Shortlists anderer Modelle.
Die Korrektur muss an derselben Art von Bild kalibriert werden. Effekte, die auf den gerenderten Regalen von ShelfSight geschätzt wurden, senkten den Anteil des ersten Buchstabens bei Qwen3.8-Flash auf den grauen Fotos nur auf 31,5 %. Die eigenen Renderings des Benchmarks ließen sich nur teilweise auf Fotografien übertragen. Maskierte Kopien anderer echter Fotos schnitten besser ab und brachten den Wert auf 13,9 %.
Auf den maskierten Fotos blieb A über den 9,0 %, die eine gleichverteilte Wahl ergäbe, während dieselbe Korrektur auf den unmaskierten Fotos diesen Wert fast erreichte. Das Paper berichtet das Fotoergebnis nur für Qwen3.8-Flash, nicht für GPT-6 Luna, das Modell, das am stärksten zum A neigt. Claude Haiku 5.5 lieferte bei nur 7 % bis 17 % der echten Fotoregale gültige Antworten.
Auf gerenderten Regalen wird die Korrektur am Modell selbst gemessen. Ihre Referenz sind die Produkteffekte, die das Modell bei den anderen 35 Renderings gezeigt hat, und kein Shopper wählte aus diesen Regalen. Positionseffekte kehren über einen Prior zurück, der an fünf veröffentlichte menschliche Wahrnehmungseffekte angepasst ist: „Der Prior verschiebt die Wahl über Regalpositionen hinweg, während die Produktpräferenzen weiterhin vom Modell stammen.“ Ein Packungstest liest daher entweder die eigene Vorliebe des Modells für eine Stelle im Bild oder, nach der Korrektur, den Positionseffekt, den der Prior liefert.
Intellicia vermarktet synthetische Antworten als objektiver als menschliche. Die Startseite verspricht „schnellere, objektivere“ Forschung, behauptet, herkömmliche Umfragen übertrieben (과장 편향), und stellt eine Korrelation von 91,2 % in den Vordergrund. Nach eigener Darstellung des Unternehmens stammt die Zahl aus Umfragen zu Tiefkühlkost und Gewürzen (냉동식품·조미료) und sagt nichts über Regalwahlen aus.
Die beste Verteidigung lautet, dass synthetische Panels zum Vorsortieren gedacht sind, nicht zum Entscheiden. Das Paper zu TwinStore sagt, die Plattform sei dafür gebaut, „Alternativen zu sichten und Hypothesen zu schärfen“, bevor mit echten Kunden getestet wird. Die Referenzseite von Intellicia nennt synthetische Forschung eine Ergänzung und keinen vollständigen Ersatz (완전한 대체가 아닌 보완), sagt, sie ersetze keine Forschung, die eine regulatorische oder klinische Grundlage braucht, und empfiehlt bei Bedarf hybride Validierung. Die These scheitert, wenn die Fehler einer Vorauswahl erst auffallen, sobald echte Shopper den Finalisten begegnen.
Nur manche Fehler können überhaupt auffallen, denn Optionen, die eine Vorauswahl zu Unrecht aussortiert, werden nie getestet. Ein Einzelhandelsvertreter in einem Bericht der Korea Herald, übernommen von The Star, erwartet, dass KI „schwächere Konzepte aussortiert“. Eine Packung, die wegen ihres Platzes oder ihres Buchstabens ausscheidet, begegnet nie einem echten Shopper; sie zu finden, erfordert maskierte Fotos, rotierte Beschriftungen und wiederholte Antworten.
Wenn die Simulationen von CU oder anderen einzelne Regalwahlen für bare Münze nehmen, kann eine Packung ihren Platz allein über Slot und Buchstabe gewinnen, ohne dass ein Shopper hinter der Wahl steht. Für Bekleidung liefert das Paper in keine Richtung Belege. Es liefert aber einen günstigen Test für das Panel jedes Anbieters: Packungen grau übermalen und die A’s zählen.