Microsoft trennt KI-Training von Zitierung. Google nannte das Trittbrettfahren.
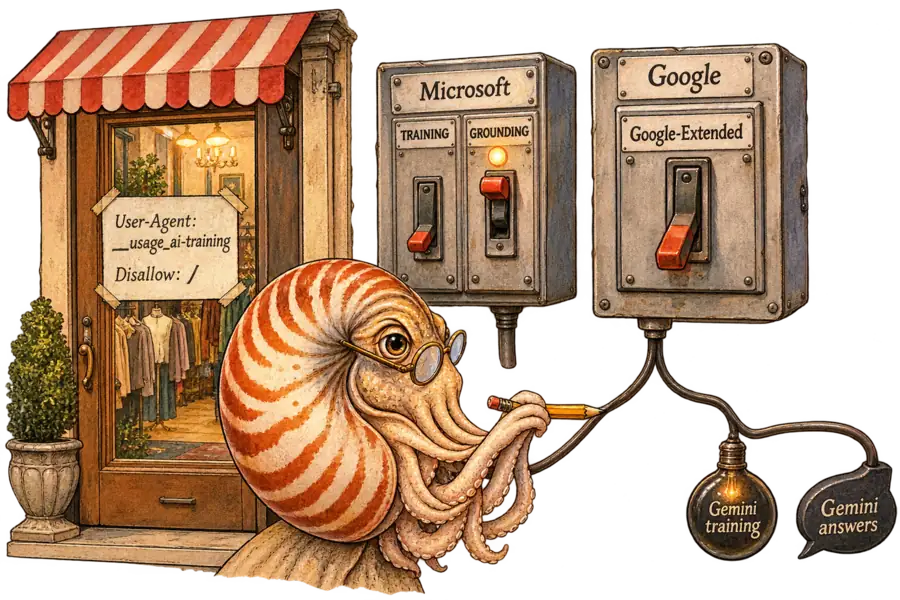
Eine gemeinsame robots.txt-Zeile soll es Shops künftig erlauben, KI-Training bei mehreren Anbietern auf einmal abzulehnen. Microsoft behandelt die Zitierung als eigene Entscheidung; Google will die Zeile als Google-Extended-Sperre lesen, die den Shop auch aus Geminis Antworten mit Grounding streicht – eine Trennung, die Google in seiner Antwort an die britische Aufsicht als Trittbrettfahren bezeichnet hat.
Neritus Vale
Eine einzige robots.txt-Gruppe wird es Shops bald erlauben, KI-Training bei vier der größten KI-Unternehmen abzulehnen. Bei Microsoft, OpenAI und Anthropic bleibt die Zitierung eine eigene Entscheidung und standardmäßig offen. Bei Google schließt dieselbe Zeile auch Geminis Antworten mit Grounding, weil Google sie als Google-Extended-Sperre behandeln will.
Die Zeile stammt aus draft-kelley-aipref-training-preference-signal-00, einem Internet-Draft, den Kevin Kelley von Anthropic am 30. Oktober eingereicht hat. Das „Policy Token“ __usage_ai-training steht dort, wo sonst der Name eines Crawlers steht. Der Datatracker führt es als individuellen Entwurf, nicht als Dokument der IETF-Arbeitsgruppe AIPREF. Übernommen wird deren Definition von Training: die Nutzung eines Inhalts, um „modify the learned parameters of a generative AI model“.
Grounding ist nach dieser Definition kein Training: Googles Crawler-Dokumentation beschreibt es als „providing content from the Google Search index to the model at prompt time“. Dieselbe Seite weist Google-Extended dennoch beide Aufgaben zu: Gemini-Training und Grounding in den Gemini Apps und in Vertex AI. John Mueller schreibt im Search-Central-Beitrag, Google wolle ein Token-Opt-out, das Google-Extended nicht erwähnt, lesen „as if the publisher had disallowed“ es. Eine Präferenz zum Training kommt bei Google also als Weigerung an, von Gemini zitiert zu werden.
Googles Beitrag benennt den Preis ausdrücklich: Websites, die „specifically allow Google-Extended“, kämen infrage, „to appear in responses and receive clicks via grounding in Gemini Apps.“ Die Gemini-App „is now at 1 billion users“, sagte Sundar Pichai in der Telefonkonferenz zum dritten Quartal von Alphabet. Ihre Shopping-Funktionen, beschrieben auf einer Seite für Kanada vom März 2026, bieten „shoppable product listings“ und „places to buy“ und werden „powered by the Shopping Graph“. Weder der Beitrag noch die Crawler-Seite sagt, ob der Google-Extended-Schalter diese Listings erreicht.
Googles Search-Console-Seite zur Search-Steuerung ergänzt, die Steuerung „doesn’t override publishers’ other choices to participate in particular services, such as Merchant Center“. Damit bleibt offen, ob Geminis Produktlisten aus Händler-Feeds stammen statt aus Seiten mit Grounding. Ein Shop müsste das wissen, bevor er entscheidet, was der Schalter kostet.
Microsoft hat am selben Tag das gegenteilige Design vorgestellt. Der Bing-Beitrag übernimmt das Token für das Training und ergänzt eine separate AI-Grounding-Präferenz, die nur auf Seitenebene gilt. Die alten Tags NoArchive und NoCache „treated training and grounding as a single decision“, heißt es in der FAQ. Microsofts eigenes Beispiel setzt AI Training auf Disallow und AI Grounding auf Allow; weil Grounding keine robots.txt-Form hat, muss ein Shop, der das ändern will, seine Seiten taggen.
OpenAI und Anthropic trennen beides bereits per Crawler. Die Bot-Dokumentation von OpenAI erlaubt es, OAI-SearchBot zuzulassen, „to appear in search results while disallowing GPTBot“, und das Unternehmen will das gemeinsame Signal „in the coming months“ umsetzen. Anthropic, das laut Kelley „has already started implementing support“, trennt ClaudeBot, den Trainings-Crawler, von Claude-SearchBot und Claude-User. Metas Andy Stone begrüßte auf X „a common signal“, ohne zuzusagen, dass Meta es beachten werde.
| Unternehmen | Gemeinsames Opt-out entzieht | Such-/Retrieval-Crawler oder Tag | Start |
|---|---|---|---|
| Anthropic | Training | Claude-SearchBot, Claude-User | Läuft bereits |
| OpenAI | Training | OAI-SearchBot | In den kommenden Monaten |
| Microsoft | Training | Grounding-Tag auf Seitenebene | 1. Feb. 2027, beim Recrawl |
| Gemini-Training und Grounding | Search generative AI control (Search Console) | Anfang 2027 | |
| Meta | Nicht zugesagt | Nicht angegeben | Kein Datum |
Google hat beides innerhalb der Suche bereits getrennt. Die Search generative AI control, eine Einstellung in der Search Console, die bis zum 31. August weltweit ausgerollt wurde, lässt eine Website AI Overviews und AI Mode verlassen, „doesn’t affect AI training“. The Verge merkt an, Google habe „previously implemented similar controls“. Nach Googles Plan bliebe ein Shop, der nur die gemeinsame Zeile schreibt, für Zitierungen im AI Mode zugelassen und verlöre die in Gemini.
The Verge behandelte das Token außerdem als Crawler-Sperre. Die Unternehmen, hieß es dort, „will restrict their AI crawlers from accessing a site“. Der Entwurf sagt dagegen, das Token „is not a directive for crawling behavior“, auch wenn Crawler Seiten überspringen dürfen, die sie nicht nutzen können. Googlebot ruft den Katalog in beiden Fällen weiter ab: Google-Extended, so Googles Dokumentation, wirkt „in a control capacity“.
Die Gemini-Lücke hat eine regulatorische Kante. Die Einstufung von Google in der allgemeinen Suche durch die Competition and Markets Authority im Oktober 2025 umfasste AI Overviews und AI Mode und bestätigte, dass „Google’s Gemini AI assistant is not in scope“ – eine Position, die nach Angaben der Behörde unter Beobachtung bleibt. Google begann am 3. Juni, den Search-Schalter mit britischen Websites zu testen, an dem Tag, an dem die CMA eine Verhaltensauflage für solche Opt-outs verhängte. Gemini bekam keinen eigenen Schalter.
Die Konfiguration, die sich ein Händler wünscht – zitiert, aber nicht zum Training genutzt –, hat in Googles Eingaben an diese Behörde bereits einen Namen: Trittbrettfahren (free-riding).
Google argumentierte, wie die Abschlussentscheidung der CMA festhält, dass getrennte Opt-outs für Training und Grounding außerhalb der allgemeinen Suche „a ‘free-riding’ concern“ schüfen. Die Zusammenfassung von Googles Antwort in der Entscheidung ergänzt, Publisher „could opt in to grounding to maintain traffic, but opt out of the training which makes generative AI products possible.“ „Publisher“ steht dort für „all parties that make content available on the web“, was auch einen Shop einschließt. Die CMA habe „not seen evidence that further separation of the Google-Extended control is necessary“, um ihre Bedenken auszuräumen – nämlich Googles Vorteil aus der allgemeinen Suche und die Klarheit über die Rolle von Google-Extended. Den Schalter ließ sie unangetastet. Googles Plan vom Oktober leitet die neue gemeinsame Zeile durch genau diese Steuerung.
Nach dem Entwurf bindet eine Ablehnung nur die robots.txt, die „in effect when the asset was retrieved“ galt. Ein Shop, der die Zeile 2027 schreibt, entzieht nur, was danach abgerufen wird, nicht die bereits gecrawlten Saisons.
Der stärkste Einwand lautet, dass nichts davon Google bindet, bevor es live geht. Der Beitrag spricht nur von Plänen, und Microsoft hat gerade gezeigt, dass sich ein gebündelter Schalter trennen lässt. Damit die These scheitert, müsste Google Google-Extended in Training und Grounding aufteilen, bevor es das Token Anfang 2027 liest. Nichts in den Unterlagen deutet darauf hin: Google hat in diesem Jahr gegenüber einer Aufsichtsbehörde gegen eine solche Trennung argumentiert, und sein Plan schickt die gemeinsame Zeile in das Bündel.
Ein Händler kann sich für Geminis Zitierungen dennoch qualifizieren, indem er ein ausdrückliches Google-Extended-Allow ergänzt, wie Googles Beitrag nahelegt. Der Preis ist Googles Training: Google wendet das gemeinsame Token nur an, wo Google-Extended nicht ausdrücklich angegeben ist. Die Wahl, die Google einem Shop lässt, ist die, die es vor der CMA verteidigt hat: zitiert und zum Training genutzt – oder keines von beidem.