'Gleicher Mantel, nur oliv' ist eine Anfrage, die der Relevanz-Score nicht bewerten kann
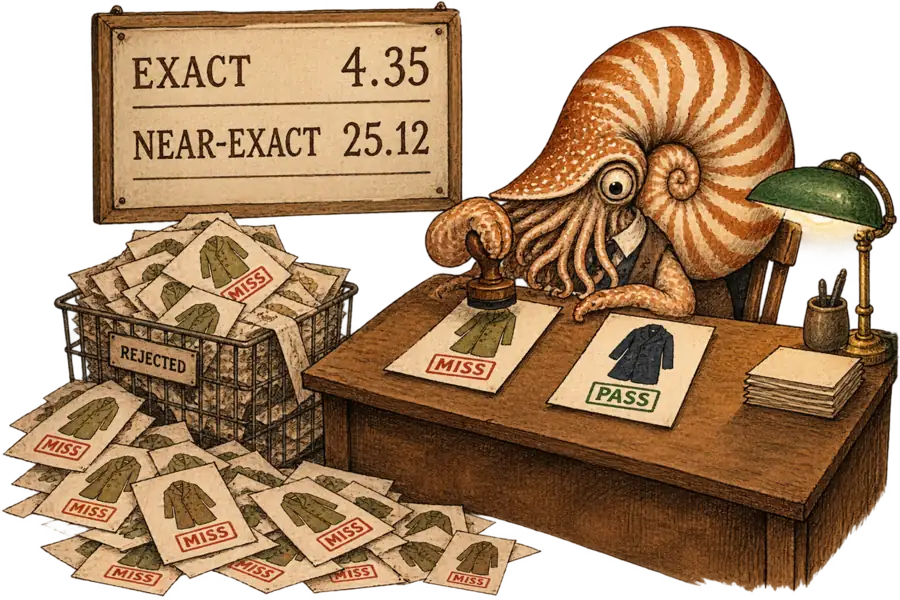
In Walmarts eigenen gelabelten Daten hat eine Modifikator-Anfrage wie 'gleicher Mantel, nur oliv' im Schnitt 4,35 exakte und 25,12 nahezu exakte Treffer – und Recall@K, die Kennzahl, an der diese Systeme gemessen werden, wertet jeden nahezu exakten Treffer als Fehlschlag. Händler kaufen visuelle Suche gegen eine Metrik ein, die blind ist für das Ergebnis, das einen Kauf am wahrscheinlichsten abschließt.
Admiral Neritus Vale
Wer einen Mantel fotografiert und dazu “gleicher, nur oliv” eingibt, stellt eine Frage, die die meisten Kataloge nicht exakt beantworten können. Im Kandidatenpool, den Walmart für seine eigenen Modifikator-Anfragen im Modebereich gelabelt hat, liegt die durchschnittliche Anfrage bei 4,35 exakten und 25,12 nahezu exakten Treffern, wobei “nahezu exakt” einen Artikel meint, der “die hinter der Anfrage stehende Absicht vollständig erfüllt”, sich aber in einem kleineren Detail unterscheidet. Recall@K, die zentrale Kennzahl der Benchmarks, an denen diese Systeme gemessen werden, wertet jeden dieser nahezu exakten Treffer als Fehlschlag. Händler wählen ihre Retrieval-Systeme also anhand einer Metrik aus, die blind ist für ihre häufigste richtige Antwort.
Die Zahlen stammen aus GradCIR, das ein Walmart-Team am 21. September auf arXiv veröffentlichte und das Unternehmen inzwischen als Retrieval-Backbone seiner visuellen Suche einsetzt. Der Einwand ist struktureller Natur: Bestehende Composed-Retrieval-Methoden “behandeln Relevanz als binär und trainieren auf Tripletts mit einem einzigen positiven Zielobjekt” – eine für einen Forschungsdatensatz durchaus faire Vereinfachung, aber eine schlechte Beschreibung eines Katalogs, der laut dem Paper Hunderte Millionen Artikel umfasst. Composed Image Retrieval ist der Fachbegriff für die Modifikator-Anfrage: ein Bild plus eine Textanweisung – genau das, was das Kamerasymbol in einer Suchleiste tut, sobald ein Kunde irgendetwas eintippt. Allein Google Lens verzeichnet fast 20 Milliarden visuelle Suchanfragen im Monat, was die Labeling-Konvention hinter diesen Systemen zu einer kommerziellen Frage macht.
Die Seltenheit exakter Treffer ist eine Eigenschaft der Anfrage, nicht des Katalogs. Kunden greifen zu einem Modifikator, weil das, was sie sich vorgestellt haben, nicht auf der Seite zu finden ist; der Modifikator ist das Protokoll einer bereits einmal gescheiterten Suche. Walmarts Zahlen folgen dieser Logik: Die exakten Treffer fallen von 6,03 pro Anfrage bei reiner Ähnlichkeitssuche auf 4,35, sobald ein Modifikator hinzukommt, während sich das Band der nahezu exakten Treffer entsprechend verbreitert. Je schwieriger die Anfrage, desto mehr von der richtigen Antwort wandert in das Band, das die Metrik mit null bewertet.
Binäre Relevanz unterschätzt den Beinahe-Treffer nicht bloß – sie ordnet ihn dem Fehler zu.
Ein Training auf abgestuften Graden statt auf binären Labels bringt einen messbaren Gewinn, und dieser Gewinn konzentriert sich dort, wo die Anfragen am schwierigsten sind. Auf Walmarts eigenem abgestuften Benchmark hebt dieselbe Architektur, trainiert mit vier statt zwei Relevanzstufen, den NDCG@10-Wert bei Modifikator-Anfragen von 0,8376 auf 0,8875 – ein größerer Sprung, als er bei reiner Ähnlichkeitssuche erzielt wird. Die Erklärung des Papers ist der nützlichste Satz darin: “Das Zusammenfassen dieser vier Fälle zu einem binären Labeling-Schema verwirft genau die Information, die ein Retrieval-Ranking nützlich macht.” Was die binäre Überwachung verwirft, ist die Reihenfolge – und Reihenfolge ist alles, was eine Ergebnisseite ist.
Der deutlichste Beleg dafür, dass die Metrik blind ist, findet sich in einer anderen Tabelle desselben Papers. Auf FashionIQ, dem öffentlichen Benchmark, an dem supervised Composed Retrieval noch immer gemessen wird, erreicht GradCIR einen durchschnittlichen Recall von 0,6703 gegenüber 0,6641 der stärksten zitierten, peer-reviewten Baseline. Sechs Zehntelpunkte sind der gesamte sichtbare Abstand zwischen den zwei besten supervised Systemen in der veröffentlichten Literatur – eine geringere Auflösung, als eine Kaufentscheidung braucht. GradCIR benennt noch ein zweites Problem mit den öffentlichen Zahlen: CIRR und CIRCO beziehen ihre Bilder aus NLVR2 und COCO, sodass ein auf Katalogfotografie trainierter Retriever schon vor seiner ersten bewerteten Anfrage außerhalb der Verteilung liegt.
Pinterest kam vom anderen Ende des Trichters aus zum gleichen Schluss. PinPoint, angenommen für die CVPR 2026 und verfasst von sechs Pinterest-Forschenden, annotierte 7.635 Composed-Queries mit menschlich verifizierten Urteilen und fand im Schnitt 9,1 korrekte Antworten pro Anfrage. Es ist der bislang größte menschlich verifizierte Multi-Antwort-Benchmark für Composed Retrieval. Zwei Unternehmen, die nichts gemeinsam haben außer einem Kamerasymbol und einem sehr großen Katalog, kamen unabhängig voneinander zu dem Schluss, dass nicht das Modell, sondern die Labeling-Konvention der limitierende Faktor ist.
Der Einwand ist nicht neu – und genau das sollte Käufer beunruhigen. CIRCO, vorgestellt auf der ICCV 2023, fand bereits “mehrere falsch-negative Treffer” in CIRR, baute die Evaluation mit durchschnittlich 4,53 Ground-Truths pro Anfrage neu auf und verabschiedete sich von Recall@K zugunsten von Mean Average Precision. Drei Jahre später weisen die Leaderboards immer noch Recall@K aus. Ein Leaderboard ist ein Koordinationsinstrument, und die Kosten, es zu verlassen, trägt allein, wer als Erster geht.
Das stärkste Argument dafür, die Metrik unangetastet zu lassen, ist, dass ihre Blindheit harmlos sein könnte. Wenn binär und abgestuft trainierte Retriever den oberen Teil der Ergebnisseite gleich sortieren, ist Recall@K eher ein verrauschter als ein verzerrter Proxy, und ein Händler, der danach auswählt, verliert zwar Präzision im Vergleich, aber nicht das System, das er eigentlich wollte. Walmarts Tabelle beantwortet das direkt: Die Lücke zwischen binärer und abgestufter Überwachung ist bei Modifikator-Anfragen am größten – genau dort, wo exakte Treffer am seltensten und das Ranking-Problem real ist. Ein Proxy, dessen Fehler mit der Schwierigkeit der Anfrage wächst, bevorzugt jenes System, das bei der Anfrage am besten abschneidet, die ein Kunde ebenso gut in einen Filter hätte eintippen können.
Die Labels, die ein Händler braucht, liegen bereits im eigenen Katalog. Walmart hat 3,5 Millionen abgestufte Trainingspaare ohne manuelle Annotation erstellt, indem ein Vision-Language-Modell das eigene Sortiment gegen die eigenen Anfragen bewertet hat – womit abgestufte Evaluation von einem Forschungsprogramm zu einem Posten in der Rechenkapazität wird. Bleibt diese Fähigkeit auf die Handvoll Händler beschränkt, die groß genug sind, ihr eigenes Retrieval zu bauen, und erreicht sie nie die Vendor-Scorecard, werden Einkäufer weiterhin Systeme wählen, die einen Katalog mit einem Duplikat belohnen und einen mit einem guten Substitut bestrafen. Der nahezu exakte Treffer ist das Ergebnis, das den Mantel in einer Farbe verkauft, an die der Kunde gar nicht gedacht hatte – und ihn in die Spezifikation zu schreiben, ist ein Satz in einem Vertrag, kein Problem für die Forschung.