Zeigt man Recherche-Agenten ein Foto, zählt die Kaufhistorie weniger
Ein neuer Benchmark zeigt: Ein Foto in der Shopping-Anfrage verbessert das Gesamtranking von Recherche-Agenten, schwächt aber ihre Treue zu den eigenen Bewertungen der Kundin oder des Kunden. Die drei getesteten kommerziellen Modelle behoben das nicht. Walmarts Argument für die Fotosuche in Sparky stützt sich auf eine Conversion-Zahl aus Äußerungen eines Managers im September, die den Unterschied nicht abbilden kann.
Neritus Vale
Walmart und Amazon wollen, dass Kundinnen und Kunden ihren KI-Assistenten ein Foto zeigen. Ein neuer Benchmark findet: Bei Recherche-Agenten verdrängt das Foto die Kaufhistorie. Walmarts Weihnachtsbeitrag vom 30. Oktober lädt Sparky-Nutzer ein, „den Look mit einem Inspo-Foto nachzustellen“. In PMRecBench, veröffentlicht am 4. November, verbesserten Anfragen aus Foto und Text das Gesamtranking der Agenten, schwächten aber ihr „Preference Following“: das Ranking nach dem, was die eigene Historie einer Person als Vorliebe ausweist.
Die Studie testete keinen Händler-Assistenten, auch Sparky nicht. Ihre Agenten sind Forschungsdesigns wie ReAct und RecMind, betrieben mit offenen und kommerziellen Modellen. Die Autoren sind Xiaoyu Zhang, Bin Wu, Sahan Bulathwela und Emine Yilmaz vom University College London sowie Yougang Lyu von der Universität Amsterdam. Als reale Oberfläche für Bild-Text-Anfragen nennen sie Amazons Alexa for Shopping; deren Startseite führt „ein Foto aufnehmen, um die visuelle Suche zu nutzen“ unter den Werkzeugen auf, die Kundinnen und Kunden bereits verwenden, und die „Shopping-Historie“ unter den Personalisierungs-Eingaben.
Die Bekleidungshälfte kombiniert echte Bewertungen von Kundinnen und Kunden mit Anfragen, die ein Modell geschrieben hat. Ihre 198 Nutzer stammen aus einem Forschungsdatensatz mit Amazon-Kleidungsrezensionen; die Filmhälfte nutzt MovieLens-Bewertungen. Gemini 3.1 Pro verfasste die 258 Anfragen aus Attributen, die in den Likes oder Dislikes eines Nutzers wiederkehren, und hängte Fotos von Artikeln an, die dieser Nutzer bewertet hatte. Claude Opus 4.8 und GPT-5.5 beurteilten die Formulierungen, und die Autoren prüften strittige Fälle nach. Weil die Fotos Artikel zeigen, die der Nutzer bereits bewertet hatte, testete die Studie keine Inspirationsfotos von außen; das Walmart-Szenario erweitert also ihr Ergebnis, statt es zu wiederholen.
Jede Anfrage versteckt ihr Ziel, einen Artikel, den der Nutzer später hoch bewertete, unter zwei Gruppen von Konkurrenten. Die Studie legt für „hoch bewertet“ keine Zahl fest; ein Like ist eine Bewertung von 4 oder mehr, ein Dislike eine von 2 oder weniger. Die eine Gruppe besteht aus Favoriten, die die Anfrage verfehlen; die andere aus Artikeln, die zur Anfrage passen, die der Nutzer aber nicht mochte oder mit denen er nie interagiert hat. Nur die Historie trennt das Ziel von der zweiten Gruppe; sie zu schlagen ist daher der Stellvertreter der Studie für Preference Following. Bei den meisten Anfragen besteht diese Gruppe teilweise aus Artikeln, mit denen der Nutzer nie interagiert hat, manche Konkurrenten könnten also schlicht Dinge sein, die die Person noch nie gesehen hat.
Mit der ersten Gruppe kamen die Agenten zurecht, über die zweite stolperten sie. Bei Bekleidung reihten vier Agenten auf dem offenen Modell Gemma-4-31B das Ziel in 93 bis 95 % der Paare vor die anfragefremden Favoriten. Die Anfrage zu verstehen war die leichte Hälfte. Gegen Artikel, die zur Anfrage, aber nicht zur Person passten, kamen sie auf 71 bis 76 %.
Die Anfrage selbst kostet Preference Following. Bei Bekleidung sank der Wert um 4,6 Punkte – ein Mittelwert über vier Gemma-4-31B-Agenten mit einem 95-%-Konfidenzintervall von −8,8 bis −0,5 Punkten –, während das Gesamtranking stieg. Die Richtung galt für jeden Agenten in beiden Domänen auf beiden Backbones; die Studie testet den Rückgang als Mittelwert, nicht Agent für Agent. Qwen3.6-35B, im Anhang berichtet, fiel bei Bekleidung um 5,6 Punkte.
Die Agenten starteten zudem von einer bescheidenen Basis. Bei Bekleidung erreicht das reine Historien-Verfahren des Collaborative Filtering 0,70 und eine einfache Score-Fusion 0,72; die Autoren sehen die Agenten nicht durchgängig vor der Fusion.
Die Autoren führen den Verlust darauf zurück, wie Agenten das Bild lesen. Wenn eine reine Textanfrage das Attribut benannte, statt es zu zeigen, fiel das Preference Following nicht mehr signifikant. Ließ man den eigenen Backbone des Agenten die Fotos in Text beschreiben, fiel der Wert bei Filmen noch steiler, mit demselben Muster bei Bekleidung. Agenten, schreiben sie, könnten „Ähnlichkeit mit Referenzbildern über Belege aus den Nutzerhistorien stellen“.
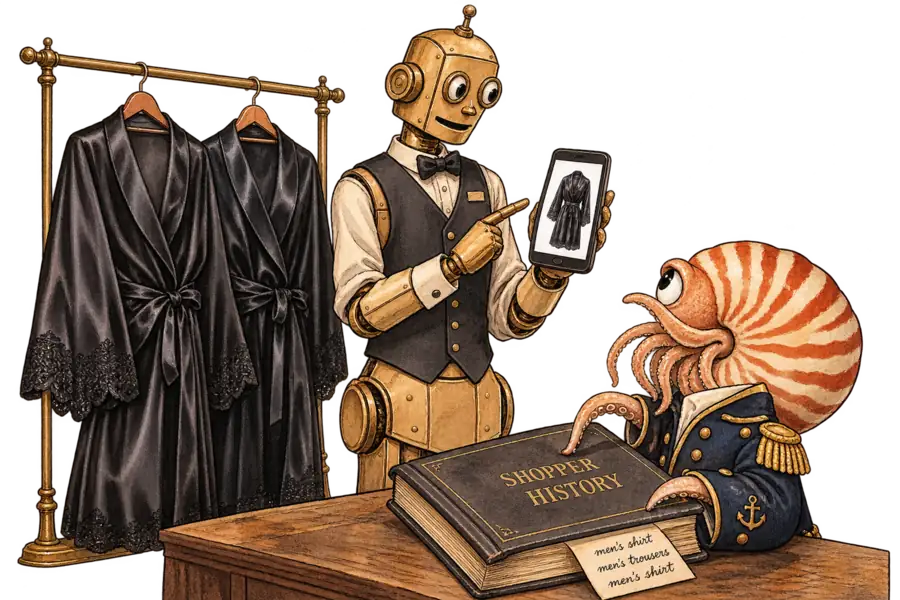
Einen Grund dafür, dass die Historie bei Bekleidung weniger half, nennen die Autoren so: Agenten prüften „Kleidungsstücke in der Historie nur selten“. Ihr Anhang zur Werkzeugnutzung stützt aber keine einfache Vernachlässigungsgeschichte. Die Zahl der Tool-Aufrufe stieg in 14 von 16 Konfigurationen, und der Rückgang beim Preference Following sei, so die Autoren, „nicht auf unzureichende Werkzeugnutzung zurückzuführen“. In einem nachverfolgten Fall bemerkte ein Agent auf GLM-5.3-Flash, dass die Historie des Kunden überwiegend aus Herrenmode bestand, setzte aber dennoch zwei Damenartikel auf Platz eins und zwei – für einen schwarzen Satin-Look, den die Anfrage gar nicht verlangt hatte – und das Herrenziel auf Platz drei.
Die drei getesteten kommerziellen Modelle behoben das nicht. ReAct, ein Allzweck-Agent, lief auf acht Backbones: den kleinen offenen Qwen3-VL-8B, Ministral 3 8B und Gemma-4-E4B; den mittelgroßen offenen Gemma-4-31B und Qwen3.6-35B; und den kommerziellen GPT-6 Luna, GLM-5.3-Flash und Claude Haiku 5.5. Bei Bekleidung verstanden die kommerziellen Modelle die Anfragen etwa so gut wie Gemma-4-31B, blieben aber allesamt unter dessen 0,76 beim Folgen der Kundenvorlieben und erzielten 0,68 bis 0,72. Qwen3.6-35B liegt mit 0,72 am oberen Ende dieser Spanne; die Lücke besteht also gegenüber Gemma, nicht gegenüber offenen Modellen im Allgemeinen. Das Abstract schließt, dass „stärkere kommerzielle Backbones allein dieses Ungleichgewicht nicht beheben“; sein „stärkere“ umfasst diese drei Modelle.
Die Fehleranalysen decken sich damit. Claude Opus 5.5 klassifizierte 125 gezogene Fehlschläge, 25 je Modell, abgeglichen mit GPT-5.6 Sol und menschlichen Labels. In 35,2 % davon hatte der Agent die Anfrage korrekt gelesen und dann einen Artikel gewählt, der dem Referenzfoto näher aussah. Kein Fall ging darauf zurück, allein nach der Historie zu ranken.
Walmarts Conversion-Zahl misst etwas anderes. Der Beitrag vom 30. Oktober enthält keine Zahl; sie stammt aus einer Bemerkung auf einer Investorenkonferenz im September, die Retail Dive am 5. November wiederholte: Die visuelle Suche habe laut Walmart-U.S.-Chef David Guggina zu einem Conversion-Anstieg von 57 % gegenüber textbasierten Suchen „geführt“. Das Transkript seines Auftritts bei Goldman Sachs am 15. September ist enger gefasst: „Wir sehen, dass die Conversion-Rate gegenüber textbasiertem Shopping um 57 % springt.“ Das vergleicht zwei Arten der Suche, ähnlich wie die Sparky-Warenkorbzahl, die wir im Oktober untersucht haben, zwei Arten von Kunden vergleicht.
Conversion verrechnet, wie der Gesamtranking-Wert der Studie, beide Effekte miteinander und kann daher steigen, während die Personalisierung nachlässt. Gugginas eigenes Beispiel war das Foto des Rasens eines Kollegen, aus dem Sparky „allein mit diesem Kontext“ Saatgut und Dünger vorschlug (Transkript). Rasen braucht wenig Historie. Einen Look von einem Inspo-Foto zu übernehmen, ist etwas anderes: Nur die Historie sagt, wer ihn tragen wird.
Der stärkste Einwand lautet, ein Foto müsse die Vergangenheit übertrumpfen. Wer ein Inspo-Foto hochlädt, will sich vielleicht anders kleiden, und ein Agent, der an alten Bewertungen klebt, würde ihn enttäuschen. Damit die These fällt, müssten Fotoanfragen den Historien so oft widersprechen, dass das Befolgen der Historie der Fehler wird.
PMRecBench wurde so gebaut, dass kein solcher Widerspruch entsteht, und die Agenten drifteten trotzdem. Die Anfragen stammen aus den eigenen Bewertungsmustern der Nutzer, „sodass die Anfrage keine Anforderung einführt, die den Vorlieben dieses Nutzers widerspricht“ (Einleitung). Ohne neuen Geschmack, dem man folgen könnte, kann die Drift kein Agent sein, der sich auf einen solchen einstellt. Gegen Konkurrenten, die der Nutzer nicht gemocht hatte, drückte das Foto das Preference Following bei bekleidung auf beiden mittelgroßen Backbones auf 0,517, nahe am Münzwurf. Die Autoren nennen die Abdeckung dieser Teilmenge begrenzt: Sie umfasst 14,70 % der Anfragen.
Ein Foto kann einem Agenten sagen, was er abgleichen soll; nur die Historie kann ihm sagen, für wen der Treffer gedacht ist.
Im August-Earnings-Call berichtete Vorstandschef John Furner von einem Essensplan, für den Sparky „die Zutaten erkannte, die sie kürzlich gekauft hatten“. Das zeigt, dass Sparky Kaufhistorie nutzt; es zeigt nicht, dass die Foto-Ergebnisse es tun. Solange Walmart die Fotosuche an der Conversion gegenüber Text misst, sehen ein Foto, das verkauft, und eines, das der Kundschaft dient, in seinen Zahlen gleich aus. Sie auseinanderzuhalten, erfordert Daten, die Walmart besitzt: ob Foto-Ergebnisse eher Marken und Größen bevorzugen, die langjährige Kunden behalten, als solche, die sie zurückschicken. Diese Prüfung durchzuführen ist eine Entscheidung, und die Conversion zu zitieren ebenfalls.