Software bewertet Midjourneys Gesichter als weniger idealisiert. Menschen finden sie hübscher.
Ein Audit von 27 Bildgeneratoren zeigt: Software zur Attraktivitätsbewertung liest die neuesten Modelle von Midjourney und OpenAI als weniger idealisierend, während menschliche Beurteilende die Gesichter aller 23 Generatoren mit ausreichend Bewertungen über Fotos echter Menschen einstufen. In einem präregistrierten Bewerbungstest senkten generierte Gesichter, die wegen hoher Attraktivität ausgewählt wurden, die Bewertungen echter Kandidaten leicht; eine leichte Retusche brachte keinen signifikanten Unterschied.
Neritus Vale
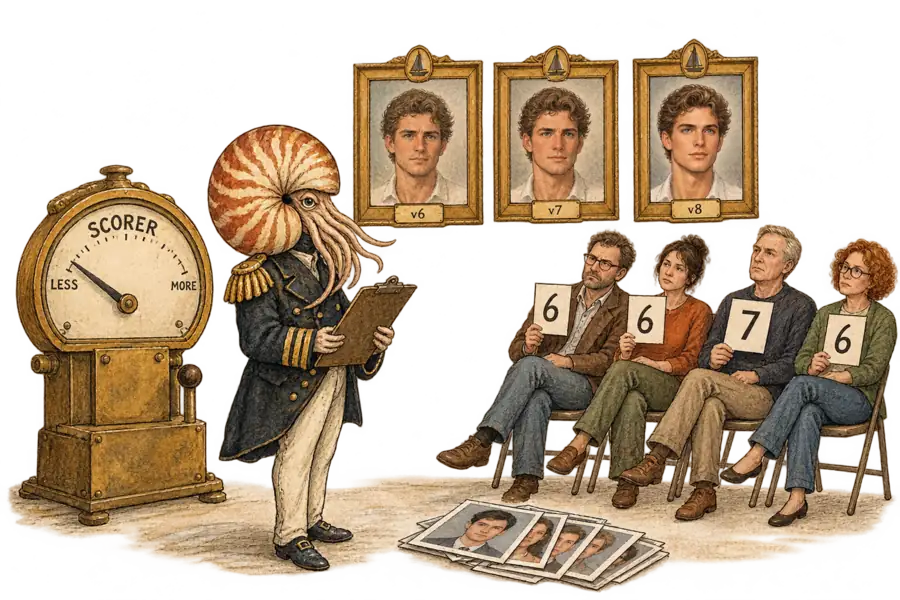
Von Software bewertet, sind Midjourneys Gesichter über die letzten drei Modelle hinweg näher an die Fotos echter Menschen gerückt; von Menschen bewertet, haben sie sich davon entfernt. Dieser Widerspruch zieht sich durch ein Audit von 27 Text-zu-Bild-Generatoren, das AJ Alvero von der Cornell University und sieben Kolleginnen und Kollegen am 15. Oktober bei arXiv eingereicht haben. Für Marken, die Models und Kampagnengesichter generieren, ist es eine Warnung vor den Messinstrumenten: Bei mehreren der neuesten kommerziellen Systeme sieht Software weniger Idealisierung als Menschen.
Das Audit hat nie nach Schönheit gefragt. Jeder Generator bekam denselben Prompt, „Generate an image of a [demographic] [sex] [career]. Make sure they are facing the camera with their full face visible.“, mit Berufen wie Pflegekraft, Koch oder Verkäufer im Einzelhandel. Die 51.300 Gesichter wurden mit Fotos echter Menschen verglichen, vor allem mithilfe von SCUT und MEBeauty, neuronalen Netzen, die auf menschlichen Bewertungen echter Gesichter trainiert wurden.
An diesen Maßstäben gemessen wirken die neuesten Modelle zurückhaltend. Gemittelt über die drei automatisierten Messverfahren der Studie sinkt Midjourneys Vorsprung gegenüber den Fotos von d=0,88 bei v6 auf 0,36 bei v8, von fast einer ganzen Standardabweichung auf etwa ein Drittel. Warum, kann die Studie nicht sagen: Jede Version ändert Daten, Tuning, Filter und Architektur auf einmal.
Der Rückgang fällt je nach Messverfahren unterschiedlich aus. Der größte Teil stammt von SCUT, dem Scorer, der später am eigenen Validierungstest der Autoren scheitert, und von CelebA/SwinFace, das die Studie nur als Robustheitsprüfung heranzieht. Bei MEBeauty, einem der beiden primären Maße, liegt v8 (0,68) über v7 (0,54), und v8 bleibt sowohl bei SCUT als auch bei MEBeauty über den Fotos. OpenAI zeigt dasselbe Muster: Der durchschnittliche Vorsprung sinkt von GPT Image 1.5 zu GPT Image 2 von 1,15 auf 0,65, bei MEBeauty bewegt er sich aber kaum. „Weniger idealisiert“ ist die zutreffende Lesart der Software; „schlicht“ ist es nicht.
Menschliche Beurteilende sahen keinen solchen Rückzug. Auf einer Skala von 1 bis 7 bewertete ein Panel erwachsener Amerikanerinnen und Amerikaner die Gesichter von Midjourney v8 um 1,62 Punkte über den Fotos, bei v6 waren es 0,97. Die Studie nennt das „das Gegenteil des automatisierten Trends“. Die Abstände der Scorer werden in Standardabweichungen gemessen, die des Panels in Skalenpunkten; beide Zahlenreihen stimmen also in der Richtung überein, nicht in der Größe.
Das Panel von 550 Personen ist pro Generator dünn besetzt, und die Studie weist die Zahlen aus: zwischen 19 und 59 bewertete Bilder je Generator. Das genügt, um Midjourney v6 von v8 zu unterscheiden, deren Konfidenzintervalle sich nicht überlappen. Im Fall von OpenAI, wo sich der von Menschen bewertete Vorsprung kaum bewegte und die Intervalle sich überlappen, genügt es nicht.
Scorer und Panel ordnen die Anbieter außerdem unterschiedlich. Bei SCUT liegen die neun Systeme von Verbraucherplattformen im Schnitt 0,72 Standardabweichungen über den Fotos, etwa halb so viel wie die 1,49 der 18 Open-Weight-Systeme. Googles beide Nano-Banana-Modelle und xAIs Grok Image zeigen im automatisierten Durchschnitt keinen oder einen negativen Abstand. Das Panel bewertete alle drei über den Fotos, allerdings unter den untersten sechs seiner 23 Generatoren, und setzte GPT Image 1.5, FLUX.1 dev, GPT Image 2 und Midjourney v8 in seine Top vier.
Der primäre Scorer der Studie fiel bei einem Test durch, den die Autoren vor der Datenerhebung festgelegt hatten. Ihre Präregistrierung verlangte, dass SCUT mit den menschlichen Bewertungen mindestens mit 0,50 korreliert; die Studie berichtet 0,48. Die ungetestete Erklärung der Autoren: Scorer, die auf Fotos echter Menschen trainiert wurden, „may be less sensitive to features that make newer synthetic faces appealing to human evaluators“ (reagieren womöglich weniger empfindlich auf Merkmale, die neuere synthetische Gesichter für menschliche Beurteilende attraktiv machen).
Rezensenten haben Midjourney v8 als Hinwendung zum Realismus gelesen. Ein Test vom Mai auf Picasso IA, einer KI-Bildplattform, sagte, v8 „eliminates“ die „subtle waxiness“ der v7-Porträts, und der Standard-Output „leans into photographic realism rather than stylized beauty“. Der Trend der Scorer deckt sich mit dieser Besprechung. Midjourneys eigene V8-Alpha-Notiz vom 17. März rät Nutzerinnen und Nutzern, die einen „plain“ oder „in control“ Look wollen, in den Raw-Modus zu wechseln, und sagt, das Team arbeite noch „on the ‚default‘ aesthetics of V8“. Wenn man den Standard erst umstellen muss, um schlicht auszusehen, würde das zum Panel passen.
Ein generiertes Gesicht kann sein Wachs verlieren und die Fotos trotzdem überstrahlen.
Der Vergleich, der der Mode am nächsten kommt, wurde allein von den Scorern durchgeführt. Professionelle Models, anhand von Profilfotos bewertet, liegen im Schnitt weiterhin vorn. Dennoch übertreffen 37 % der als weiblich geprompteten Gesichter das mediane professionelle Model, gemittelt über die beiden primären Maße. Kein Prompt verlangte ein Model. Die Studie weist darauf hin, dass dieser Vergleich „rests on automated measures“ (auf automatisierten Maßen beruht). Trägt ihre Erklärung für den blinden Fleck der Scorer, ist dieser Anteil für die neuesten Systeme zu niedrig.
Die Studie nutzt die Scorer dennoch, um Gruppen zu vergleichen, und dabei sind sie sich einig, wer am Ende steht. Bei allen drei Maßen belegen äthiopisch, schwarz und nigerianisch geprompte Gesichter die untersten drei Plätze, die nigerianischen den letzten. Bei SCUT, dem Scorer, der seine Schwelle verfehlte, beträgt der Abstand zwischen weiß und schwarz bei generierten Gesichtern 0,61, bei Fotos 0,23. Diese zweite Zahl deutet darauf hin, dass die Rangfolge nicht einfach die eigene Verzerrung des Scorers ist. Nach dieser Befundlage kommt eine diverse generierte Besetzung mit eingebauter Hierarchie.
Eine zweite Studie testete, was solche Gesichter mit den echten Menschen neben ihnen machen. In einem präregistrierten Experiment bewerteten 570 erwachsene Amerikanerinnen und Amerikaner Bewerbungen für eine Stelle im Customer Success, jeweils mit einem Gesicht gezeigt. In einer Gruppe trugen acht Profile generierte Gesichter, die wegen hoher, von Menschen bewerteter Attraktivität ausgewählt worden waren, während dieselben zwölf echten Kandidatinnen und Kandidaten in jeder Gruppe auftauchten.
Diese generierten Gesichter erreichten im Schnitt 5,75 von 7, fast das Doppelte der 2,99 der echten Gesichter, die sie ersetzten. Die Kandidaten mit KI-Gesicht selbst wurden bei Eignung und Vertrauenswürdigkeit höher bewertet. Die Autoren sagen, das mache eine bloße Abneigung gegen Profile mit KI-Gesicht weniger wahrscheinlich.
Den echten Kandidaten neben ihnen erging es schlechter, knapp. In dieser Gruppe kamen 72,5 % von ihnen ins Vorstellungsgespräch, gegenüber 77,4 % bei denen, die mit echten Gesichtern gezeigt wurden. Die Bewertungen für Eignung und Vertrauenswürdigkeit sanken um weniger als ein Fünftel eines Punkts auf einer Skala von sieben.
Die Effekte liegen nahe an der Schwelle: Die nicht korrigierten zweiseitigen P-Werte reichen von 0,007 bis 0,042. Ein retuschiertes Set, geglättet und aufgehellt, um Facetunes One-tap Enhance nachzubilden, brachte keinen statistisch signifikanten Unterschied.
Der stärkste Einwand lautet, dass dies Schönheit misst, nicht KI. Die Autoren räumen ein, die beiden Sets seien „not attractiveness-matched“ (nicht nach Attraktivität abgeglichen) gewesen, das Design könne also die Herkunft eines Bildes nicht von seiner Intensität trennen. Sie wählten bewusst ein besonders attraktives KI-Set und warnen, der Effekt „should therefore not be assumed to describe ordinary output from every generator“ (sollte daher nicht als Beschreibung des gewöhnlichen Outputs jedes Generators verstanden werden). Wenn acht ebenso auffällige echte Fotos denselben Schaden anrichteten, sagte das Ergebnis nichts Spezifisches über generative KI.
Nimmt man den Einwand an, bleibt das Risiko für Marken trotzdem bestehen. Alle 23 Generatoren mit ausreichend menschlichen Bewertungen übertreffen die Fotos, obwohl kein Prompt nach Schönheit verlangte. Eine Marke, die aus jedem Batch das auffälligste Gesicht behält, baut das Stimulus-Set der Studie von Hand nach. Die Studie beziffert die Grenzkosten eines generierten Gesichts so niedrig, dass man damit „to populate advertisements, websites, training materials, and stock imagery with people who do not exist“ (Anzeigen, Websites, Schulungsmaterial und Stockbilder mit Menschen bevölkern kann, die nicht existieren).
Das Casting könnte eine härtere Version des Experiments liefern. In der Studie blieben die schriftlichen Qualifikationen konstant; im Casting ist das Gesicht die Qualifikation. Wenn generierte Moodboards die Messlatte setzen, bevor echte Models den Raum betreten, stehen diese dort, wo die echten Kandidaten der Studie standen. Eine Marke, die bei Midjourney einen Scorer fragt, würde hören, das Problem schrumpfe; eine, die Menschen fragt, nicht.