Target veröffentlichte seinen Such-Stack und behielt die Gewichte für sich
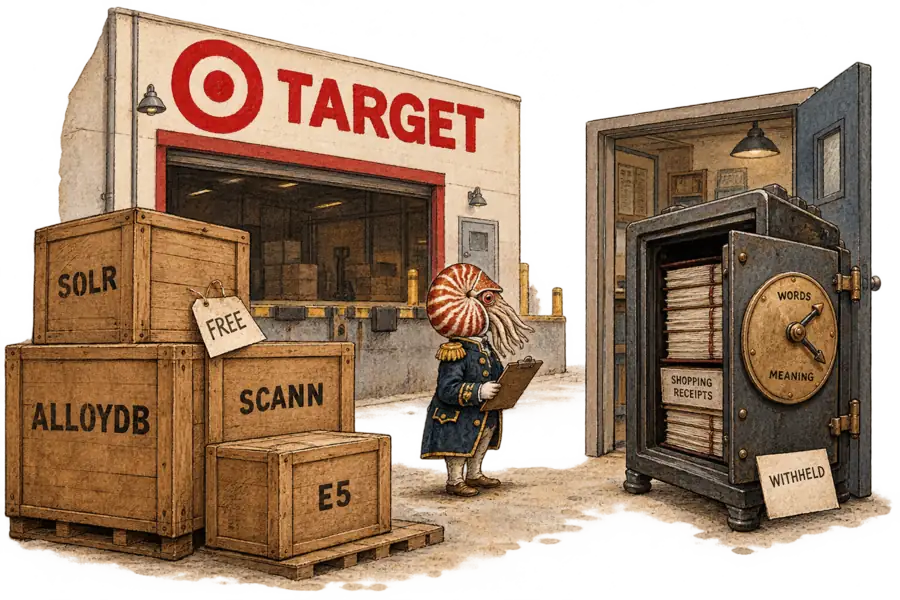
In Targets Live-Tests lag die Suchnachfrage pro Besucher mit einem fertigen Standard-Embedding-Modell 7,14 % unter der reinen Stichwortsuche, mit einem auf Targets eigenen Klick-, Warenkorb- und Bestelldaten trainierten Modell dagegen 1,10 % darüber. Das Paper nennt die Teile, die ein Händler zukaufen kann, und hält die aus Targets Kundschaft gelernten Label- und Merge-Einstellungen zurück.
Admiral Neritus Vale
Vier Wochen lang schaltete Target im Live-Traffic ein fertiges Standard-Embedding-Modell zu seiner Stichwortsuche hinzu, und die Nachfrage pro Besucher (Bestellwert geteilt durch Besucher) lag 7,14 % unter der reinen Stichwortsuche. Ein späteres Modell, trainiert auf Daten darüber, was Targets eigene Kundschaft anklickt, in den Warenkorb legt und kauft, und über Gewichte, die auf Targets Traffic abgestimmt waren, in die Stichwortergebnisse eingemischt, lag 1,10 % darüber. Der Vergleich bündelt mehrere Änderungen, und das Paper sagt nicht, welche Merge-Regel beim Test mit dem Standardmodell zum Einsatz kam. Das Paper mit beiden Tests, am 25. September bei arXiv eingereicht, nennt die Teile, die ein Händler zukaufen kann, und hält die aus dieser Kundschaft gelernten Einstellungen zurück: die Label-Gewichte und Schwellenwerte sowie die Merge-Gewichte.
In Retail Product Search: A Practical Approach at Target beschreiben Darshan Sonagara, Qujiaheng Zhang, Ankit Singh und Alex Li von Targets Data-Sciences-Gruppe ein System, das größtenteils aus Teilen besteht, die jeder herunterladen oder mieten kann. Apache Solr, eine Open-Source-Engine, übernimmt die Stichwortsuche. Die Vektoren für die Suche nach Bedeutung liegen in Googles Datenbank AlloyDB, indiziert mit ScaNN, einem AlloyDB-Indextyp. Der Encoder, der Suchanfragen und Produkttexte in diese Vektoren umwandelt, geht von e5-small-v2 aus, das unter MIT-Lizenz frei herunterladbar und klein genug ist, um auf handelsüblichen CPU-Servern zu laufen. Die Zahl des Papers für Suchen ohne Ergebnis, ein Rückgang um rund 50 %, stammt aus dem Test des eingesetzten feinabgestimmten Modells.
Die Vertraulichkeitshinweise des Papers listen auf, was Target zurückhielt. Target nennt nur relative Zuwächse, „gemäß Unternehmensrichtlinie“, und hält die Einstellungen zurück, die seine Logs in Trainingslabels verwandeln. Die Logs, aggregiert nach Suchanfrage und Produkt statt nach Person, wurden in dominanten Kategorien wie Wohnen und Bekleidung heruntergesampelt, um Platz für kleinere zu schaffen, und dann auf rund 20 Millionen gelabelte Paare gefiltert. Ein Paar galt nur dann als erwünscht, wenn sein Wochenscore, der Bestellungen höher gewichtet als Add-to-Carts und Add-to-Carts höher als Klicks, über mehrere Wochen oberhalb eines Schwellenwerts blieb. Produkte, die zu einer Suchanfrage mindestens eine festgelegte Anzahl Mal angezeigt wurden, ohne dass es einen einzigen Klick, Add-to-Cart oder eine Bestellung gab, wurden zu Negativbeispielen: in den Worten des Papers „häufig gezeigt und durchgängig ignoriert“.
Nichts auf der Teileliste des Papers hat gesehen, was Targets Kundschaft gewählt und was sie ignoriert hat.
Die Regel, die die beiden Ergebnislisten zusammenführt, veränderte, was das erste feinabgestimmte Modell mit den Bestellungen machte. Mit Reciprocal Rank Fusion (RRF), das Produkte hochstuft, die beide Listen ranken, waren die Ergebnisse gemischt: Die Nachfrage pro Besucher stieg um 0,49 % und die Add-to-Carts nahmen zu, doch die Klicks sanken und die Bestellkonversion fiel um 1,20 %. Die Autoren erklären das damit, dass sich die beiden Listen kaum überschneiden und die Übereinstimmung, die RRF belohnt, daher selten vorlag. Weighted Interleaving füllt jeden Platz im Verhältnis zu einem festgelegten Gewicht aus der einen oder der anderen Liste. Target stimmte diese Gewichte in aufeinanderfolgenden A/B-Tests ab, ausgehend von einer gleichmäßigen Aufteilung, und hält die endgültigen Werte zurück.
Elastic und Google dokumentieren beide RRF als Möglichkeit, Stichwort- und Vektorergebnisse zusammenzuführen. Elastics Dokumentation sagt, RRF „erfordert kein Tuning“ und beseitige bei der Linearkombination von Scores „die Notwendigkeit, die passende Gewichtung zu ermitteln“. Googles AlloyDB-Dokumentation beschreibt für die Datenbank, in der Targets Vektoren liegen, die Hybridsuche als getrennte Vektor- und Textsuchen, „anschließend werden die Ergebnisse per Reciprocal Rank Fusion (RRF) kombiniert und neu gerankt“. Ihre Beispielabfrage verwendet die Konstante 60, die Target in seinem eigenen RRF-Test nutzte. Elastics Aussage betrifft das Mischen von Scores, ein anderes Problem als die Kanalanteile, die Target abstimmte. Targets Tests stellten RRF gegen Interleaving, und Interleaving schnitt bei der Bestellkonversion besser ab; das Paper vergleicht abgestimmte Gewichte nicht mit einer gleichmäßigen Aufteilung.
Das erste auf Targets Daten trainierte Modell bewegte die Nachfrage bereits ungefähr so weit wie das endgültige. Mit den Stichwortergebnissen verzahnt, steigerte es die Nachfrage pro Besucher um 1,11 % und die Bestellkonversion um 0,74 %. Das eingesetzte Modell ergänzte dann unter anderem erweiterte Trainingsdaten, Hard Negatives, Feldmarkierungen und Produkt-Highlights. Klicks und Konversion stiegen weiter, während die Nachfrage pro Besucher unverändert blieb.
Die Vektorsuche brauchte außerdem einen Filter, der Targets Sortiment kennt. Ein Modul zur Präzisionskontrolle entfernt Vektorergebnisse, die dem in einer Suchanfrage genannten Geschlecht, der Größe oder der Marke widersprechen, oder dem Artikeltyp und der Kategorie, die ein Query-Klassifikator daraus vorhersagt. Ohne Filter lag die Precision at 10 bei 0,836, also war grob jedes sechste Produkt in den Top Ten des Vektorkanals kein erwünschtes Ergebnis. Mit beiden Filtersätzen stieg die Präzision auf 0,885, also auf etwa eines von neun. Die Beispiele des Papers stammen aus den Bereichen Badetücher, Lebensmittel und Tierbedarf, und ein reines Bekleidungsergebnis nennt es nicht; bei Kleidung, wo Geschlecht und Größe darüber entscheiden, ob ein Ergebnis überhaupt tragbar ist, dürften die Filter stärker ins Gewicht fallen. Der Schwellenwert jedes Filters wurde vor dem Start abgestimmt, eine weitere Einstellung, die das Paper auslässt.
Der stärkste Einwand lautet, dass die von Target getesteten e5-Modelle älter sind und ein neueres, größeres Modell Targets Daten womöglich gar nicht braucht. Dafür müsste ein generisches Modell Targets Produkte so ranken, wie Targets Kundschaft es täte, ohne deren Entscheidungen je gesehen zu haben. Targets eigene Tests geben wenig Anlass zu erwarten, dass Größe diese Lücke schließt. Bei von menschlichen Annotatoren bewerteten Suchanfragen auf thematische Relevanz schlug das größere e5-large-v2 das kleine Modell beim NDCG, einem gängigen Ranking-Maß, um 0,0068. Die Autoren führen den Verlust im Live-Betrieb auf ein Modell zurück, das „für allgemeine semantische Ähnlichkeit trainiert wurde statt für die Produkte, die Nutzer tatsächlich kaufen“. Wenn generische Modelle weiter besser werden, könnte der Zero-Shot-Verlust schrumpfen, doch die Entscheidungen bleiben in Targets Logs.
Für einen Händler, der KI-Suche einkauft, ist entscheidend, wer die Einstellungen lernt und wer sie behält. Ein Anbieter kann die Daten nicht mitliefern, aber er kann die Einstellungen auf dem Traffic des Händlers lernen. Targets Test mit dem Standardmodell zeigt, was das System leistet, bevor jemand diese Einstellungen gelernt hat. Wenn Modelle und Vektordatenbanken weiter billiger werden, liegt in den Einstellungen der Unterschied zwischen der Suche des einen Händlers und der des anderen. Die Klausel, die man im Vertrag lesen sollte, ist die, die festlegt, ob Labels, Schwellenwerte und Merge-Gewichte bei dem Händler bleiben, dessen Kundschaft sie hervorgebracht hat.