Tencents von Agenten entwickelter Recommender stieg vier Sprossen der Beweisleiter hinauf, und nur auf der letzten gab es echte Nutzer
In Tencents TGR-EvoDAG-Paper entwickelten LLM-Agenten einen generativen Recommender auf einem kleinen Amazon-Datensatz. Das Ergebnis, für eine Medienplattform neu trainiert, steigerte die Klickrate in einem 14-tägigen Live-Test um 0,40 %. Die größeren Zahlen stammen aus nachgespielten Rezensionen und aus simulierten Nutzern, die auf demselben Modell laufen wie die Kritiken, die die Agenten während der Entwicklung lasen. Genau diese Evidenz bliebe einem Händler ohne Tencents Traffic.
Neritus Vale
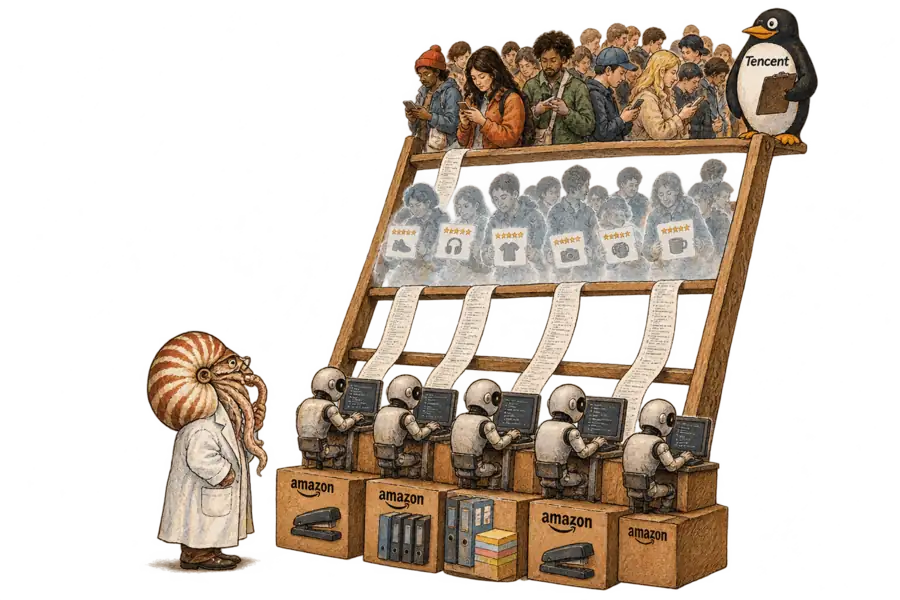
Forscher von Tencent ließen LLM-Agenten den Trainingscode eines Recommenders umschreiben, und die Änderung überstand einen Live-Test. Ihr Paper TGR-EvoDAG, am 23. Oktober bei arXiv eingereicht, berichtet den Gewinn auf vier Sprossen der Evidenz, die in diesem Test enden, und mit jeder Sprosse schrumpft die Zahl. Ein Händler, der einen solchen Test nicht fahren kann, müsste von Agenten geschriebene Änderungen auf den ersten beiden Sprossen beurteilen, den billigsten.
Die Agenten arbeiteten an einem generativen Recommender, der in drei Stufen trainiert wird. Ein Tokenizer wandelt jeden Artikel in einen kurzen Code um, ein Modell lernt, den Code des nächsten Artikels eines Nutzers zu schreiben, und eine Alignment-Stufe justiert seine Entscheidungen. Weil Änderungen am Tokenizer ein komplettes Neutraining erzwingen, verteilt das System die GPU-Zeit nach Stufen und hält konkurrierende Zweige am Leben. Sieben Agenten teilen sich die Arbeit, einer davon ist ein Code-Reviewer.
Die erste Sprosse ist das Nachspielen eines kleinen Amazon-Datensatzes. Das Abstract spricht von „öffentlichen Amazon-Datensätzen“, doch laut Anhang liefen alle Evolutionsexperimente auf der Kategorie Office Products mit 4.905 Rezensenten. Eine Bekleidungskategorie wurde nicht getestet.
Auf diesen Daten schlug das entwickelte Modell APAO, die stärkste getestete von Menschen entworfene Methode, um 37,4 % bei NDCG@10, einem Maß dafür, wie weit oben der richtige Artikel in den Top Ten steht. Allerdings starteten die Agenten mit dem veröffentlichten Code von APAO, stapelten Änderungen darauf und führten den APAO-Zweig am Ende wieder ein. Der Vergleich misst, wie weit Agenten veröffentlichte menschliche Arbeit vorantreiben können.
Das Paper beziffert diese Suche in GPU-Stunden, 24 für jedes verglichene Framework. Die Sprachmodell-Tokens der Agenten werden außerhalb dieses Budgets protokolliert und nicht berichtet, und für die menschliche Forschung hinter APAO gibt es keine Angabe.
Die zweite Sprosse tauscht protokollierte Rezensenten gegen simulierte aus. Agent4Rec baut LLM-Agenten aus den Profilen echter Nutzer und lässt sie Empfehlungen durchblättern, bewerten und entscheiden, wann sie aufhören. Ein Panel dieser Agenten bewertete das jeweils finale Modell jedes Frameworks, und ihre Zufriedenheit lag 19,7 % über der von APAO. Die Autoren sagen, das bestätige „tatsächlich bessere Empfehlungen“.
Diese Prüfung teilt sich eine Engine mit der Suche, die sie bewertet. Das Paper sagt, Agent4Rec-Werte seien nie zur Modellauswahl verwendet worden, und nennt sie eine „tatsächlich zurückgehaltene Verhaltensmessung“. Dennoch bewertete ein Panel simulierter Nutzer die finalen Modelle, während ein anderes die Kritiken schrieb, die die Agenten während der Evolution lasen; beide liefen auf DeepSeek-v4-flash. Die Panels sind getrennt, sprechen aber für ein und dasselbe Modell, dessen Präferenzen die Suche lenkten, bevor sie ihr Ergebnis bewerteten.
Simulatoren dieser Art bringen ihre eigenen Warnhinweise mit. Die Autoren von Agent4Rec berichteten neben der Übereinstimmung auch von „Abweichung“ zwischen ihren Agenten und den Präferenzen der Nutzer. Als Simulatoren in UserArena einen Live-A/B-Test nachspielten, reichten ihre Ergebnisse von nahezu nichts bis zur Übertreibung, wie wir am 23. Oktober berichteten.
Die dritte Sprosse führt zu Tencent, wenn auch nicht in einen Shop. Die Autoren trainierten die entwickelte Architektur und APAO von Grund auf neu, und zwar auf Logs von dem, was das Paper „Tencents groß angelegte kommerzielle Medienplattform“ nennt. Sie hat mehr als 10 Millionen tägliche aktive Nutzer, und eine positive Interaktion ist dort ein Klick; ein Kaufmaß berichtet das Paper nicht. Mit diesen Daten haben die Agenten nie gearbeitet.
Auf diesen Logs nennt das Abstract einen Zuwachs von 12,16 % bei Hit@1, also dabei, wie oft der angeklickte Artikel auf Platz eins gerankt war. Das ist die größte Lücke im Diagramm der Cut-offs. Bei Hit@10, einem Cut-off, den auch die Amazon-Tests nutzten, beträgt der Zuwachs 1,52 %. Ein Retrieval-Kanal reicht Kandidaten an einen Ranker weiter, daher zählt sein erster Platz vermutlich weniger als die Frage, ob der Artikel überhaupt auf seine Liste kommt.
Die vierte Sprosse ist die einzige, die misst, wie Menschen auf das neue System reagieren. Über 14 Tage als zusätzlicher Retrieval-Kanal betrieben, steigerte das entwickelte Modell die Gesamtklickrate um 0,40 %, mit p=0,019 nach Varianzreduktion und einer Korrektur für Mehrfachvergleiche. Das Paper hält absolute Klickraten-Werte zurück, die 0,40 % lassen sich also nicht in Klicks oder Umsatz umrechnen. Tencents früheres TGR-Paper berichtete neben Klicks auch Lese- und Wiedergabezeit; dieses hier berichtet kein Maß für die verbrachte Zeit.
Der Test nutzte 5 % des Live-Traffics, mehr als eine Million Nutzer. Ein Händler mit einem Bruchteil dieses Traffics bräuchte einen weit größeren Effekt, bevor ein Test ihn vom Rauschen unterscheiden könnte. Einen Wechselkurs zwischen den Sprossen liefert das Paper ebenfalls nicht, denn jede misst etwas anderes.
Der Übergang vom entwickelten Code in die Produktion ist die Stelle, über die das Paper am wenigsten sagt. Tencents Setup unterscheidet sich vom Amazon-Setup: Die Nutzerhistorien umfassen bis zu 500 Interaktionen, und der Artikeltext enthält maschinell erzeugte Bildbeschreibungen. Das Paper sagt nicht, was sich bei der Portierung geändert hat und ob ein Ingenieur den entwickelten Code las, bevor er live ging.
Der einzige Code-Reviewer, den es beschreibt, ist ein weiterer Agent.
Der stärkste Einwand lautet, dass nichts davon eine Besonderheit von Agenten ist. Tencents BARGE-Modell aus demselben TGR-Paper verbesserte Hit@5 offline zweistellig. Nach dem vollständigen Rollout steigerte es die Klickrate um 0,60 %, die Offline-Werte schmeichelten also auch einem von Menschen gebauten Modell. Die These scheitert, wenn die billigen Sprossen Kandidaten wenigstens in der Reihenfolge ordnen, die ein Live-Test ergäbe, sodass ein Händler Gewinner auswählen könnte, ohne ihre Größe zu kennen.
Diese Reihenfolge lässt sich mit einem Live-Test nicht belegen, und das Paper führte genau einen durch. Das Agentensystem, das Google-Forscher bei YouTube betreiben, geht davon aus, dass die Reihenfolge versagen kann: Sein Offline-Agent meidet „Sackgassen-Pfade, die in Offline-Proxys vielversprechend aussehen, aber in der Vergangenheit die Online-Metriken nicht verbessert haben“. Der letzte Schritt der Ingenieure ist die Prüfung der „vom Online Agent gesammelten Experimentmetriken“. Beides hängt von Live-Tests ab, die einem Händler am Anfang fehlen.
TGR-EvoDAG läuft innerhalb von Uppimo, einer internen Tencent-Plattform, die laut Paper für öffentliche Tests geöffnet werden soll. Geschieht das, könnten Händler die Hälfte dieses Prozesses nutzen, die Agenten billig gemacht haben: die Offline-Suche nach besserem Code. Die andere Hälfte, ein Live-Test, groß genug, um eine Veränderung von 0,40 % zu erkennen, liefert die Software nicht mit. Ein Händler, der die billige Hälfte übernimmt, ohne den Live-Test aufzubauen, hat sich entschieden, auf Basis der beiden billigsten Evidenzarten des Papers auszuliefern.