Auf „Denk gründlicher“ gestellt, wurden die meisten Shopping-Agenten sicherer und machten trotzdem dieselben Fehler
In einem Preprint der University of Chicago, das zehn Frontier-Modelle an festen Listen mit je zehn Produkten testete, erhöhte ein Anheben des Reasoning-Aufwands von niedrig auf hoch die angegebene Sicherheit in 17 von 30 Vergleichen zwischen Modell und Benchmark signifikant, die Genauigkeit in einem, jeweils nach Korrektur für multiples Testen. Die Modelle scheiterten zudem gemeinsam: Bei WebShop mit niedrigem Aufwand überforderten 47 von 493 Aufgaben alle zehn Modelle, wo unabhängige Fehler praktisch keine erwarten ließen.
Neritus Vale
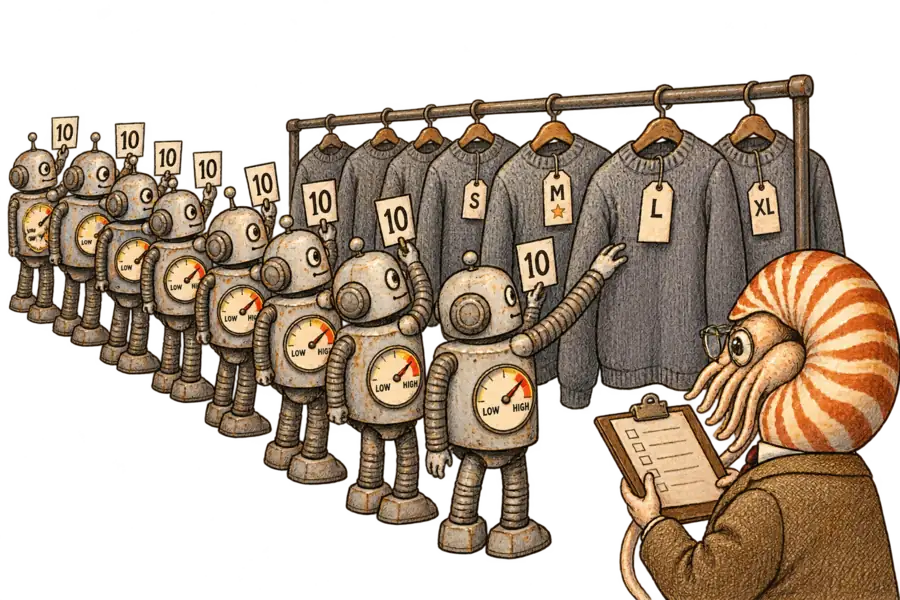
Einen Shopping-Agenten länger nachdenken zu lassen, machte ihn sicherer in seiner Wahl, verbesserte die Wahl aber nur selten messbar. In einem Preprint der University of Chicago zu zehn Frontier-Modellen, veröffentlicht am 17. November, scheiterten die Agenten zudem häufig gemeinsam, oft am selben falschen Produkt. Zwei gängige Standardlösungen, mehr Reasoning-Aufwand und die Meinung eines zweiten Modells, lassen diese Fehler bestehen.
Adi Krishnamoorthy und X.Y. Han gaben jedem Modell eine Anfrage und eine feste, gemischte Liste mit zehn Produkten, von denen genau eines richtig war. Die Listen stammten aus WebShop, aus Amazons SQID oder aus Wayfairs rein textbasiertem WANDS. Getestet wurden OpenAIs GPT-6 Astra, GPT-6.1 Sol und GPT-6 Luna, Anthropics Claude Fable 5.1 und Claude Opus 5.5, Googles Gemini 4 Argon und Gemini 3.1 Pro, DeepSeek V4.1 Flash, Alibabas Qwen 3.8 Max sowie Moonshots Kimi K3. Jedes Modell lief, soweit angeboten, mit niedrigem, mittlerem und hohem Aufwand und bewertete jede Wahl auf einer Skala von 10.
Die Grenzen des Versuchsaufbaus prägen jede der folgenden Zahlen. Feste Listen blenden Suche, Blättern und Navigation aus, wo der Aufwand nach Einschätzung der Autoren womöglich mehr zählt. WebShop wird von einem Programm ausgewertet, doch eine manuelle Stichprobe hielt 15 von 100 geprüften Distraktoren für vertretbar (95-%-Konfidenzintervall: 9 % bis 23 %). SQID und WANDS beruhen auf Crowd-Labels, deren Rauschen gemeinsame Fehler größer erscheinen lassen könnte, denn eine falsch etikettierte Aufgabe zählt für jedes Modell als Fehler. Jede Bedingung wurde einmal ausgeführt, und die Sicherheit war eine einzelne ganze Zahl, die zusammen mit der Antwort zurückkam. Aufgaben, Logs und Code sollen nach Angaben der Autoren später veröffentlicht werden.
Die Genauigkeit bewegte sich von niedrigem zu hohem Aufwand kaum, bei Niveaus, die über die zehn Modelle hinweg bei WebShop von 74,0 % bis 88,1 %, bei SQID von 43,7 % bis 50,6 % und bei WANDS von 65,8 % bis 73,7 % reichten. Von den dreißig Vergleichen in Tabelle 1, unten zusammengefasst, überstand nur ein einziger Zugewinn von niedrig zu hoch die Holm-Korrektur für multiples Testen, die die Autoren über 26 Kontraste je Datensatz laufen ließen: Qwen 3.8 Max bei WebShop. Sein Zugewinn entstand vollständig beim Schritt zu mittlerem Aufwand, ebenso der von GPT-6 Luna bei WANDS, der dort ebenfalls die Korrektur überstand. Die Autoren deuten solche Sprünge so, dass niedriger Aufwand für manche Aufgaben „tatsächlich unzureichend“ sei.
| Niedrig → hoch | WebShop | SQID | WANDS |
|---|---|---|---|
| Änderung der Erfolgsquote, Punkte | -1,4 bis +5,5 | -2,0 bis +2,0 | -2,1 bis +5,2 |
| Änderung der Sicherheit, Punkte | -0,6 bis +3,2 | -0,8 bis +2,5 | -0,8 bis +4,5 |
| Modelle, die Holm bestehen: Erfolg, dann Sicherheit | 1, 8 | 0, 4 | 0, 5 |
Die angegebene Sicherheit bewegte sich in eine Richtung. Bei WebShop stieg sie für neun von zehn Modellen, meist von ohnehin zu hohen Werten aus.
Gemini 3.1 Pro zeigt die Lücke. Hoher Aufwand steigerte seine Genauigkeit bei WebShop um 3,2 Punkte, ein Zugewinn, der die Korrektur nicht überstand. Seine AUROC bei WebShop, die misst, wie gut die Sicherheit richtige von falschen Antworten trennt, sank von 0,66 bei niedrigem Aufwand auf 0,54 bei hohem; 0,5 entspricht dem Zufall.
Auch bedeutete „hoch“ nicht überall dieselbe Arbeit. OpenRouter, das von den Autoren genutzte Gateway, rechnet Reasoning-Tokens als Output ab. Bei hohem Aufwand verbrauchte Qwen 3.8 Max pro WebShop-Aufgabe fast fünfzigmal so viele Reasoning-Tokens wie GPT-6.1 Sol. Dasselbe Etikett kauft also sehr unterschiedliche Mengen abgerechneten Denkens.
Die Kalibrierung folgte eher dem Modell als der Einstellung. Anthropics Claude-Modelle waren beim Expected Calibration Error auf jedem Benchmark insgesamt am besten kalibriert, wobei Gemini 4 Argon beide beim Brier-Score von WebShop schlug. Der Vorsprung ist relativ: Bei SQID überschätzten die beiden Claude-Modelle ihren Erfolg immer noch um 12,4 und 10,8 Punkte, und bei WebShop überschätzten ihn die übrigen acht um bis zu 15,8.
An manchen Stellen bewegte die Einstellung die Kalibrierung. Der Kalibrierungsfehler von Qwen 3.8 Max bei WebShop sank mit steigendem Aufwand von 12,0 auf 6,7 Punkte, und die AUROC von Gemini 3.1 Pro fiel wie oben beschrieben. Ein kalibrierter Agent, so das Paper, „kann die Entscheidung an den Nutzer zurückgeben, wenn er unsicher ist“. Eine Schwelle, die die meisten Fehler der überzuversichtlichen Modelle abfinge, würde nach Angaben der Autoren in einem Supplement die meisten ihrer richtigen Antworten verwerfen.
Die Autoren nennen zwei Gründe, warum Aufwand Sicherheit statt Genauigkeit kaufte. Die Wahl könnte „durch das Lesen statt durch das Schlussfolgern begrenzt“ sein, oder eine lange Spur gibt einem Modell „das Gefühl, geprüft zu haben, das es dann als Sicherheit ausgibt“. In den Paderborner Tests, über die wir am 9. November berichtet haben, behielten Agenten meist ein vorausgewähltes Produkt bei, mit oder ohne Reasoning.
Eine zweite Meinung hilft aus einem anderen Grund kaum: Die Modelle irren gemeinsam. Bei WebShop mit niedrigem Aufwand überforderten 47 von 493 Aufgaben jedes Modell, wo unabhängige Fehler praktisch keine erwarten ließen.
Die per Crowd etikettierten Benchmarks zeigten dasselbe Muster. Bei niedrigem Aufwand überforderten 185 von 500 SQID-Aufgaben jedes Modell, wo zufällig fast keine zu erwarten wären. Label-Rauschen, warnen die Autoren, könnte einen Teil dieser Häufung erklären. Bei WANDS waren es 55 Aufgaben, und höherer Aufwand veränderte die Fehlerkorrelation kaum.
Auch die falschen Antworten bündelten sich. Bei Aufgaben mit mehreren falschen Wahlen und niedrigem Aufwand entfielen über 80 % auf das jeweils beliebteste falsche Produkt der Aufgabe, gegenüber 32 % bis 36 % bei Zufall. Bei WebShop ist die gemeinsame Wahl typischerweise „ein plausibler Beinahe-Treffer“, der „eine Nebenbedingung wie Größe, Duft oder Preis“ verfehlt. Bei SQID ist die gemeinsame Wahl meist ein Ersatzprodukt, dessen Titel dem des richtigen fast entspricht. Das Paper beschreibt die gemeinsame Wahl bei WANDS nicht und lässt die Ursache offen: „gemeinsame Trainingsdaten, gemeinsame Listing-Signale oder beides“.
Kein Benchmark zielt auf Kleidung, auch wenn WebShop Amazon-Mode-Listings enthält; das Paper weist nichts nach Kategorie aus. Sein Beinahe-Treffer ist nach unserer Lesart der Normalzustand eines Bekleidungskatalogs: die meisten Modelle in vielen Größen und Farben unter nahezu identischen Titeln, ganz wie das SQID-Supplement Ersatzprodukte beschreibt, die oft „dasselbe Produkt in anderer Größe, Farbe, Packungsmenge“ sind. Ein Beinahe-Treffer-Listing, das Agenten anzieht, schreiben die Autoren, „bindet die Nachfrage aller Agenten auf einmal“.
Aus Sicht des Verkäufers könnte es wie ein Bestseller aussehen, wenn sich Agenten auf die falsche Größe einigen.
Der stärkste Einwand lautet, das Paper habe den leichten Teil getestet und ihn unvollkommen etikettiert. Ozan Candogans Modetest, den das Paper zitiert, ließ drei Konsumenten-Agenten (dots, Instinct und Muse) zehn Pullover mit drei Attributen und dann 50 Kleider mit zwölf Attributen bewerten und stellte fest, dass sie in diesem reichhaltigeren Umfeld „deutlich schlechter abschnitten“. Er testete Produkte statt Basismodelle und variierte den Aufwand nicht, und er merkte an, dass die Suchstrategie „die endgültige Wahl ebenso prägen kann wie das Modell“. Die These scheitert, wenn zusätzliches Nachdenken sich bei der Suche auszahlt, was die Autoren für möglich halten, oder wenn die meisten gemeinsamen Fehler Label-Artefakte sind.
Zahlte sich der Aufwand bei der Suche aus, würde die These auf die endgültige Wahl schrumpfen, an der jede Pipeline endet. Dort hob der Regler in Vergleichen jedes Modells mit sich selbst auf identischen Zehnerlisten und Labels die Sicherheit, ohne die Genauigkeit verlässlich zu heben. Der Label-Einwand trifft teilweise zu: Das Paper prüft nie, wie viele gemeinsame Fehler auf die vertretbaren Distraktoren fallen. Eine Neubewertung der 47 Aufgaben, die jedes Modell überforderten, würde zeigen, wie viele auf das Konto des Benchmarks gehen, sobald die Daten veröffentlicht sind.
Die Frage ist also, wofür man zahlt. Die Wahl eines kalibrierten Modells, so das Fazit der Autoren, „zählt mehr, als seinen Aufwand hochzudrehen“; unser eigener Rat lautet, die Kalibrierung selbst zu testen, statt dem Wort eines Anbieters zu vertrauen. Läsen Shopping-Agenten Verkaufszahlen so, wie die Agenten im Music-Lab-Nachbau, über den wir im Oktober berichtet haben, eine Zählung lasen, könnte ein gemeinsamer Beinahe-Treffer in den Rankings aufsteigen, getragen von Stimmen, die alle aus demselben Irrtum stammen.