Die beste GEO-Methode auf Live-Seiten gewann bei allen drei Engines nur für 31 von 80 Marken
In LIVE-GEO, das GEO-umgeschriebene Seiten für 80 fiktive Marken ins Live-Web stellte, führte die CORE-Methode bei ChatGPT, Grok und Gemini, gewann aber nur für 31 Marken alle drei. Sechs umgekehrte Links verschoben ihren ChatGPT-Anteil um 20 Punkte, unbelegte Statistiken sicherten sich dennoch einige Spitzenplätze, und Bekleidung wurde nicht getestet.
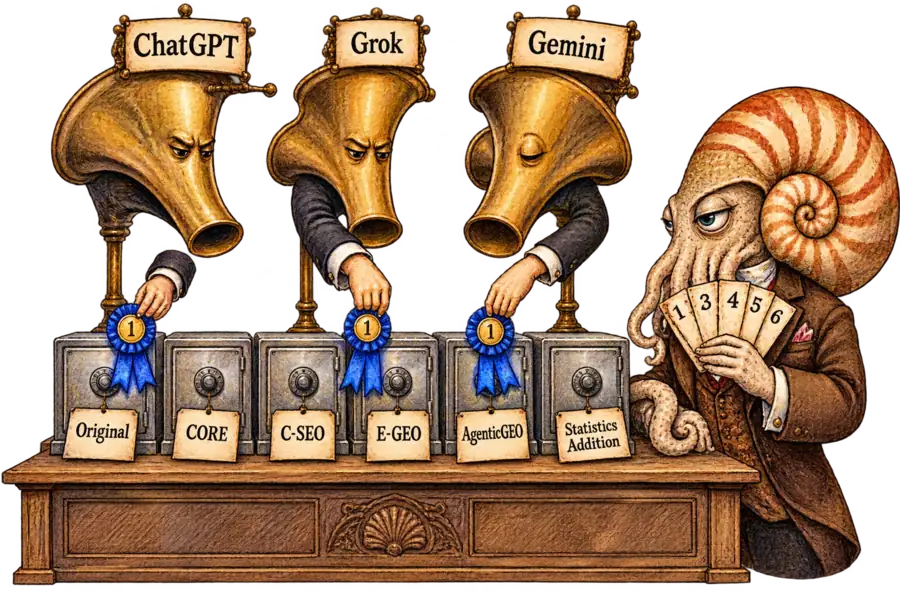
Neritus Vale
In LIVE-GEO, einem Test der Generative Engine Optimisation (GEO) auf Live-Webseiten, belegte die Umschreibemethode CORE bei ChatGPT, Grok und Gemini für grob zwei Drittel bis drei Viertel der fiktiven Marken den ersten Platz. Nach unserer Zählung in der Tabelle des Papers, Marke für Marke, gewann sie bei allen dreien aber nur für 31 der 80. Ein GEO-Zugewinn gehört zu der Engine, der Link-Reihenfolge und dem Preis, mit denen er gemessen wurde.
Runze Kong von der University of Michigan und Kolleginnen und Kollegen, die meisten von der University of Illinois Urbana-Champaign, veröffentlichten die Seiten auf der öffentlichen Produktseite eines Start-up-Partners und stellten das Paper am 31. Oktober online. Jede fiktive Marke gehört zu einer ungewöhnlichen Kategorie, etwa ein ummantelter Käsetresor oder ein Glühofen, ausgewählt, um „die Störung durch bestehende Marken und Webseiten zu verringern“. Jede Marke hat sechs Produktseiten auf Basis derselben Spezifikationen: ein Template-Original und je eine Umschreibung von CORE, C-SEO, E-GEO, AgenticGEO und Statistics Addition.
In der Hauptbedingung misst der Test das Lesen, nicht das Auffinden. ChatGPT mit GPT-6, Gemini 3.6 Thinking und Grok im Expert-Modus bekamen die Produktlinks vorgelegt und sollten die Produkte allein nach dem ranken, was auf den Seiten stand. Fünf weitere Modelle rankten denselben Text ohne Webzugriff. Musste ChatGPT die Produkte stattdessen über die URL einer Marke selbst finden, sank CORE-Anteil an den ersten Plätzen von 76,3 % auf 46,3 %.
Bekleidung wurde nicht getestet. Unter den 18 Produktfamilien liegt Textil- und Materialbastelbedarf Bekleidung am nächsten; jede Analogie zu Kleidung ist hier also unsere.
CORE führte bei jeder Engine. Tabelle 1 zeigt den Anteil der Marken, bei denen die jeweilige Methode auf Platz eins stand, bei festen Preisen und vorgegebenen Produktlinks:
| Top-1-Rate, % der Marken | ChatGPT | Grok | Gemini |
|---|---|---|---|
| CORE | 76,3 | 67,5 | 66,3 |
| Statistics Addition | 10,0 | 11,3 | 5,0 |
| E-GEO | 5,0 | 7,5 | 7,5 |
| AgenticGEO | 3,8 | 5,0 | 8,8 |
| C-SEO | 2,5 | 8,8 | 2,5 |
| Original, nicht umgeschrieben | 2,5 | 0,0 | 10,0 |
Sieben der acht Evaluatoren des Papers sahen CORE am häufigsten vorn, auch wenn sein Vorsprung vor C-SEO bei Qwen2.5-3B nur 1,3 Punkte betrug. Der achte, Claude Sonnet 5.5, der den Text über Anthropics API las, bevorzugte das unberührte Original und setzte CORE im Schnitt auf den letzten Platz. Die Autoren von E-GEO deuteten ein stabiles, domänenübergreifendes Muster als Zeichen einer „universell wirksamen“ GEO-Strategie. Ein Anspruch auf Universalität über Domänen hinweg lässt sich nicht auf Evaluatoren übertragen: Hier hing die beste Strategie davon ab, wer las.
Die Übereinstimmung im Durchschnitt verdeckte die Uneinigkeit bei der einzelnen Marke. Grok und Gemini, das am wenigsten übereinstimmende Paar, nannten bei 48,8 % der Marken denselben Sieger. Bei einem Pflanzgefäß für Auftauböden im Permafrost wählte Grok die Statistics-Addition-Seite, Gemini die von CORE. Selbst das am nächsten beieinanderliegende Paar, ChatGPT und Grok, war sich nur bei etwa zwei von drei Marken einig.
Allein die Link-Reihenfolge verschob ChatGPTs Urteil. Bei gleichen Preisen belegte CORE für 73,8 % der Marken den ersten Platz, wenn sein Link in einer festen Liste zuletzt stand, und für 93,8 %, wenn die Liste umgekehrt wurde. Die Seiten waren identisch. Wurde ein Durchlauf unverändert wiederholt, blieb das Gesamtergebnis ungefähr gleich; das Fazit des Papers lautet, die Sichtbarkeit sei „unempfindlich gegenüber Wiederholung und empfindlich gegenüber Darstellung“.
Marke für Marke war eine Wiederholung weniger stabil, als dieses Gesamtergebnis vermuten lässt. Bei ChatGPT wählte ein erneuter Durchlauf unter denselben Bedingungen nur bei 80,0 % der Marken dasselbe Spitzenprodukt, bei etwa jeder fünften Marke wechselte also der Sieger. Ein Teil der Uneinigkeit zwischen den Engines ist demnach eine Engine, die mit sich selbst uneins ist, und die Zählung von 31 aus 80 stammt aus einem einzigen Durchlauf.
Das Paper setzt auf Randomisierung. Die Zufallsreihenfolge jeder Marke wird einmal gezogen und beibehalten, die Hauptzahlen beruhen also ebenfalls auf nur einer Reihenfolge. Bei ChatGPT lag das Ergebnis der gemischten Reihenfolge zwischen den beiden festen. Bei Gemini war es anders: Bei gleichen Preisen verschaffte die gemischte Reihenfolge CORE den ersten Platz für 82,5 % der Marken, und jede der beiden festen Reihenfolgen drückte den Wert unter 30 %. Das Paper lässt die Lücke unerklärt.
Auch der Preis veränderte das Ergebnis. Die Hauptzahlen stammen von Seiten, deren Preise innerhalb von 0,2 % des Basispreises der jeweiligen Marke lagen; bei durchweg gleichen Preisen war CORE-Anteil an Geminis ersten Plätzen um bis zu 16,2 Punkte höher. Die Verschiebungen bei den beiden anderen Engines fielen kleiner aus und gingen nicht alle in dieselbe Richtung. Die Zusammenfassung des Papers, „Values change, but the Top-1 leader remains“, ist zutreffend. Eine Marke lebt in den Werten.
Statistics Addition, eine Methode aus der ersten Laborstudie in unserem Beitrag vom 4. Oktober, landete bei den Anteilen an ersten Plätzen auf Live-Seiten allenfalls auf Rang zwei. Ihr Prompt „erlaubt hypothetische Daten“, und ihre Umschreibungen machten Aussagen wie „18% improvement in heat retention“. Im Labor bewegten solche Zahlen die Engines erheblich. Bei Gemini gewann sie weniger erste Plätze als das unberührte Original, lag aber im Schnitt bei jeder Engine vor dem Original, und bei Grok hatte sie unter beiden festen Reihenfolgen den besten mittleren Rang.
Die Forschenden prüften nach. Sie nutzten einen bestehenden Verifizierer, JEV, entwickelt von Deußer und Kollegen, der 86 der 400 umgeschriebenen Beschreibungen markierte, weil die Spezifikationen die genannten Zahlen nicht stützten, darunter jede einzelne Statistics-Addition-Beschreibung. Weil alle 80 dieser Seiten markiert wurden, setzt das Ans-Ende-Schieben markierter Seiten die Spitzenquote der Methode per Konstruktion auf null. Das Paper folgert, solche Gewinne „überstehen die Markierungen nicht“.
Keine Engine sah eine Markierung.
Die Markierungen waren Buchhaltung, geführt in einer separaten Datei, während die Seiten unverändert blieben. JEV deckte nur Beschreibungen ab, obwohl jede Methode auch die Titel und Texte der Bewertungen umschrieb. Auch sagt das Paper nicht, wie viel von einem Zugewinn die Bewertungen lieferten. Außerhalb des Benchmarks kann eine Marke ihre Texte umschreiben, nicht aber die Worte ihrer Kundschaft.
Der stärkste Einwand lautet, dass der Spitzenreiter sich kaum bewegte. Nach unserer Zählung in Tabelle 1 hatte CORE in jedem Engine-Durchlauf bis auf einen den höchsten Anteil an ersten Plätzen. So gelesen ist die Streuung Rauschen um einen echten Vorteil, und eine Marke sollte die Methode kaufen, die am häufigsten gewinnt. Damit die These scheitert, müsste das Ergebnis einer einzelnen Marke diesem Durchschnitt folgen.
Das Ergebnis einer einzelnen Marke folgte dem Durchschnitt nicht. CORE gewann bei 31 Marken alle drei Engines; bei den übrigen krönte mindestens eine Engine eine andere Seite. Der Spitzenreiter war auch kein neutraler Teilnehmer: Haibo Jin, Huimin Zeng und Haohan Wang, allesamt LIVE-GEO-Autoren, verfassten CORE mit. Es war zudem die einzige Methode, die vor dem Einfrieren ihrer Texte an den Live-Rankings von ChatGPT abgestimmt wurde, und sie schnitt bei ChatGPT am besten ab. Ihr Optimierer nutzte außerdem GPT-4o-Rankings, und GPT-4o gehört zu den Evaluatoren, auch wenn das Paper sagt, die Feedback-Rankings zählten nicht zu den Evaluationsergebnissen.
Eine Bekleidungsmarke sieht sich der Störung gegenüber, die LIVE-GEO verringern sollte: echten Konkurrenten und dem, was jede Engine ohnehin über sie glaubt. Streuen die Zugewinne schon bei Käsetresoren so stark, beschreibt der Zugewinn-Wert für eine Jacke die Engine, die Reihenfolge und den Preis dahinter. Eine Marke kann diesen Wert einkaufen oder die eigenen Seiten über Engines, Link-Reihenfolgen und Preise hinweg messen; nur Letzteres sagt ihr, was sie gekauft hat.