Wessen Umsatz stieg um 3,67 %, als Taobao lernte, wo Käufer aufhören zu scrollen?
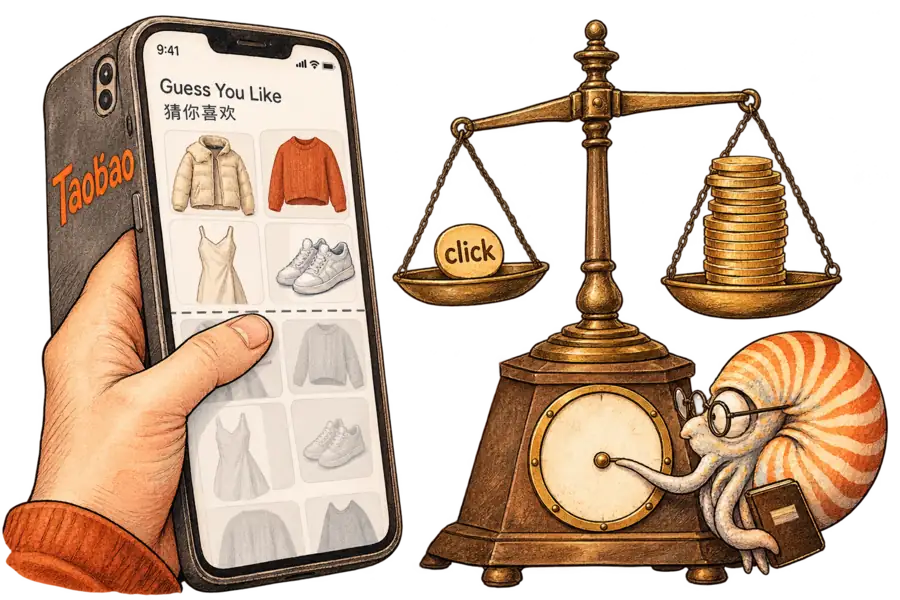
Taobaos Feed „Guess You Like“ wählt jede Liste jetzt mit einem Evaluator aus, der vorhersagt, wie weit ein Käufer scrollt. Im Live-Test stiegen die Klicks um 0,70 % und der „Commercial Revenue“ um 3,67 %. Das Paper definiert diesen Umsatz jedoch nirgends, nennt nicht, welche Gewichtung die Produktion nutzt, und weist weder Bestellungen noch GMV noch Werbekundenzahlen aus. Ob Käufer oder Plattform gewonnen haben, lässt sich daher nicht belegen.
Neritus Vale
Taobaos Feed „Guess You Like“ wählt jede Liste, die er anzeigt, jetzt mit einem Modell aus, das vorhersagt, wie weit der Käufer scrollt, bevor er aufhört. In einem Live-Test steigerte die Änderung die Klicks um 0,70 % und den „Commercial Revenue“ um 3,67 %. Das Paper sagt nirgends, was dieser Umsatz ist. Es kann deshalb nicht zeigen, ob der Gewinn bei den Käufern oder bei der Plattform ankam.
Die Änderung sitzt im Evaluator, dem letzten Schritt vor dem Bildschirm. Ein Generator schlägt Kandidaten für die Reihenfolge vor, und der Evaluator wählt eine davon zur Anzeige aus. Autoren der Taobao & Tmall Group von Alibaba und der Xi’an Jiaotong University haben das Paper in dieser Woche veröffentlicht. Die meisten bestehenden Evaluatoren, so ihr Argument, reduzieren eine Liste auf „unabhängige Einzelvorhersagen pro Artikel“, etwa die Klickrate. Damit blenden sie zwei „physische Realitäten“ aus: Für einen Klick muss der Artikel erreicht und gesehen werden, und Artikel „konkurrieren um begrenzte Nutzeraufmerksamkeit“.
Der neue Impression-Click Evaluator, kurz ICE, bildet die Kette von der Anzeige über die Impression bis zum Klick ab. Er sagt eine Verteilung der Browsing-Tiefe voraus, also der letzten Position, die ein Käufer erreicht, und leitet daraus die Wahrscheinlichkeit ab, dass jeder Platz gesehen wird. Ein Trainingsziel sorgt dafür, dass sich die vorhergesagten Klicks „ein endliches Wahrscheinlichkeitsbudget“ über die Liste teilen: Der Sog eines Artikels senkt den seiner Nachbarn.
Wie groß das erste Problem ist, zeigen die Logs des Papers. In der Woche an Industriedaten, mit der es trainiert und testet, sahen die Nutzer nach unserer Rechnung rund 58 % der ihnen angezeigten Artikel. Ein Evaluator, der jeden Platz als gesehen behandelt, schreibt dem Rest einen Wert gut, den er nie liefert. Die Autoren nennen diesen Fehler „systematische Überschätzung des Nutzens am Listenende“.
Das zweite Problem hat einen Bekleidungsfall, obwohl das Paper Bekleidung nirgends erwähnt; der Fall stammt von uns. Hat ein Käufer einen Artikel angeklickt und ist zufrieden, sinkt laut Paper „der Grenznutzen nachfolgender ähnlicher Artikel erheblich, selbst wenn deren Einzelqualität hoch ist“. Man denke an den Beinahe-Zwilling einer bereits angeklickten Jacke, der weiter unten in derselben Liste wartet.
Das erste Problem ist in der Websuche ein alter Hut. 2008 stellten Forscher von Microsoft fest, dass ein „Cascade“-Modell die Klickverzerrung am Anfang von Ergebnisseiten am besten erklärte. Darin „sehen Nutzer die Ergebnisse von oben nach unten an und hören auf, sobald sie ein lohnendes Dokument erblicken“. ICE überträgt den Von-oben-nach-unten-Teil auf die Stufe, die ganze Listen auswählt.
Die Offline-Tests des Papers messen Impressionen und Klicks, nie Geld. Sein listenbezogenes Maß SeqAUC behandelt die beobachteten Gesamtklicks jeder Liste als Ground Truth, und ICE verbesserte es auf allen sechs getesteten Backbones.
Der Live-Test lief im Feed „Guess You Like“ der Taobao-App, den das Paper als „ein zentrales Empfehlungsszenario“ bezeichnet. Die Impressionen, also die Artikel, die Käufer zu sehen bekamen, stiegen um 0,58 %. Ob das von tieferem Scrollen oder von mehr Besuchen kam, sagt das Paper nicht. Die Klicks stiegen um 0,70 %, nahe am Wert der Impressionen.
Der Umsatz hielt nicht Schritt. Er stieg etwa fünfmal so stark wie die Klicks. Skaliert der Umsatz mit den Klicks, kam der größte Teil des Zuwachses aus dem Wert je Klick und nicht aus mehr Klicks. Nach unserer Rechnung auf Basis der Zahlen des Papers hätte dann jeder Klick rund 3 % mehr eingebracht als in der Kontrollgruppe.
Welchen Wert der Evaluator jedem Artikel zuweist, ist eine Einstellung. Seine Bewertungsformel multipliziert die Wahrscheinlichkeit, dass ein Platz gesehen und geklickt wird, mit einem Gewicht. Gleiche Gewichte zählen Klicks, während der „vorhergesagte Kaufwert oder Gebotspreis“ auf den „erwarteten GMV oder Werbeumsatz“ zielt. Welches Gewicht die Produktion nutzt, sagt das Paper nirgends. Seine Ergebnisse weisen einen dritten Begriff aus, „Commercial Revenue“, der zu keiner der beiden Bezeichnungen passt.
Beide Einstellungen passen zu Alibabas Geschäftsmodell. Laut aktuellem Geschäftsbericht können Händler auf Taobao und Tmall „In-Feed-Marketing“ buchen. Die Erlöse aus dem Kundenmanagement werden überwiegend pro Klick, pro tausend Impressionen, nach Zeit und pro Verkauf berechnet. Die beiden Ereignisse, die ICE vorhersagt, sind also zwei der Einheiten, die Alibaba abrechnet. Ob die Listen, die ICE bewertet, bezahlte Artikel enthalten, sagt das Paper nicht.
Ein Modell, das weiß, wo das Scrollen endet, kann auch erkennen, welche Plätze sich verkaufen lassen.
Nichts im Paper trennt die Lesarten voneinander. Es weist keine Bestellungen, keinen GMV, keine Kaufabschlussrate und keine Zahl für Händler oder Werbekunden aus. Der Test lief auf 5 % des Traffics und nennt kein Konfidenzintervall.
Das einzige langfristige Käufermaß des Papers ist ein Guardrail. Ein „14-Day Lifetime Value“-Indikator, geführt, „um die Nutzerbindung zu überwachen“, stieg um 0,23 %, was die Autoren als Gewinne lesen, die „ohne Einbußen bei der langfristigen Nutzererfahrung“ Bestand haben. Das Paper definiert den Indikator nicht. Was auch immer er zählt: Er kann nicht zeigen, was die Listen den Käufern verkauft haben oder wer bezahlt wurde.
Der günstigste Fall des Papers lautet, dass auch die Käufer gewonnen haben: Sie sahen mehr, klickten mehr und schnitten beim Bindungs-Guardrail leicht besser ab. Gewichtet die Produktion Artikel nach vorhergesagtem Kaufwert, verschiebt ein schärferer Evaluator wahrscheinliche Käufe auf die Plätze, die Menschen sehen. Damit dieser Fall trägt, müsste die Umsatzzahl Verkäufe messen, und die zusätzlichen Verkäufe müssten Dinge sein, die Käufer wollten, und keine teureren Ersatzprodukte.
Die Autoren wissen, wie man eine schärfere Zahl ausweist. Han Zhu und Jian Xu, zwei der ICE-Autoren, schrieben gemeinsam BAR, eine Studie von 2025 zu Alibabas Display-Werbung. Dort „dient“ die Klickrate „zur Bewertung der Nutzererfahrung“ und der Return on Investment „wird eingesetzt, um die Erfahrung des Werbekunden zu messen“. ICE weist Klicks, Impressionen und „Commercial Revenue“ aus, aber keine Werbekundenzahl vom Typ ROI. Jenseits der Klicks und des Bindungs-Guardrails nennt es kein Käuferergebnis. Nach den ausgewiesenen Belegen ist der Anteil der Käufer am Gewinn eine Annahme.
Das Paper preist ICE als „Plug-and-play“ an. Setzen andere Shopping-Feeds es ein, bewerten sie die Plätze, die Käufer erreichen, höher und den Rest niedriger. Das Gewicht hinter diesen Entscheidungen gewinnt dann an Bedeutung, und es ist die Zahl, die ICE auslässt. Das Slate-Ranking-Paper von ByteDance hielt seine eigene Produktionseinstellung ebenfalls zurück, wies aber GMV pro Nutzer und den Wert für Werbekunden aus.
Für ein Bekleidungslabel in diesem Feed würde jeder Platz mit der Wahrscheinlichkeit abgewertet, gesehen zu werden. Gewichtet die Produktion nach Gebotspreis oder Kaufwert, entscheidet ein Gewicht, das das Label nicht sehen kann, mit darüber, wer die Plätze bekommt, die zählen. Dieses Gewicht zu nennen, würde Taobao einen Satz kosten. Ohne ihn hat der Gewinn auf dem Papier keinen Eigentümer.