Les distributeurs peuvent exécuter cinquante politiques. Ils n'ont les moyens d'en comparer que trois.
Le classement, la tarification et les agents d'achat conversationnels ont tous convergé vers des politiques interchangeables, et en générer une nouvelle ne coûte désormais qu'un prompt. Les comparer coûte des commandes finalisées, et l'arithmétique dit qu'un distributeur peut s'en permettre environ trois.
Admiral Neritus Vale
L’intrant rare de l’IA dans le commerce de détail n’est plus le modèle. C’est le client dont vous sacrifiez la commande pour prouver qu’un modèle vaut mieux qu’un autre. Les moteurs de classement, les règles de tarification et les agents d’achat conversationnels ont tous convergé vers le même objet : une politique interchangeable, bon marché à produire et coûteuse à départager. L’offre de candidats a explosé ; le trafic disponible pour choisir entre eux n’a pas bougé. La contrainte contraignante s’est déplacée : ce n’est plus ce qu’un distributeur peut construire, mais ce qu’il peut se permettre de comparer.
Les politiques candidates sont désormais écrites par d’autres modèles, ce qui explique leur soudaine prolifération. MetaStrategy, déployé sur le fil d’actualité de la page d’accueil de Taobao, fait produire par un LLM un paquet JSON typé de pondérations d’objectifs, de préférences de catégories et de règles de positionnement, puis le compile en un générateur qui « rivalise atomiquement avec les titulaires ». GenRec de Netflix, GenRec, remplace un classeur conçu à partir de features par un LLM post-entraîné sur des étiquettes de classement. L’un comme l’autre peuvent engendrer des variantes plausibles plus vite qu’une équipe ne peut les tester. Produire un challenger est presque gratuit ; établir qu’il est meilleur se paie en achats.
Le nombre d’achats nécessaires à une comparaison dépend de l’effet recherché, et bien plus de la référence de base que l’intuition ne le suggère. La puissance statistique fait croître l’échantillon requis avec la variance divisée par le carré de l’effet, une relation que la keynote KDD 2015 de Ronny Kohavi formule comme n proportionnel à sigma au carré sur delta au carré. Pour un gain relatif fixé, cette formule récompense un site à fort taux de conversion et pénalise un site à faible taux : le même mouvement en pourcentage produit un déplacement absolu plus faible sur une base plus réduite, ce qui exige un échantillon plus grand pour être détecté. À 95 % de confiance et 80 % de puissance, détecter un mouvement relatif d’un pour cent nécessite environ 7,7 millions de commandes cumulées sur les deux groupes face à un taux de conversion de référence de quatre pour cent. Face à une base d’un pour cent, le même test en exige environ quatre fois plus : à peu près 31,7 millions. La sensibilité s’achète en transactions, et les transactions sont le seul intrant qu’un distributeur ne peut pas fabriquer.
Ajouter des candidats fait grimper cette facture deux fois, et c’est la seconde hausse que les équipes oublient. Un groupe témoin partagé aide, puisque l’allocation standard face à une seule référence dimensionne le témoin à la racine carrée du nombre de challengers multipliée par le trafic de chaque challenger. La correction pour comparaisons multiples freine en retour, car un taux d’erreur familial fixé impose à chaque test un seuil plus strict et un échantillon plus grand. En combinant les deux effets, l’arithmétique est impitoyable. Trois politiques candidates coûtent environ deux fois et demie un test A/B unique. Cinquante en coûtent environ trente-cinq fois plus, un multiple contenu uniquement parce que le témoin partagé fait un vrai travail.
Confrontez ces multiplicateurs à un véritable carnet de commandes et la contrainte cesse d’être abstraite. ASOS a expédié 57,3 millions de commandes sur les 52 semaines closes au 31 août 2025, indique son annonce de résultats. Cela représente environ 157 000 commandes par jour, un volume qui semble ample jusqu’à ce qu’il faille le répartir entre les groupes.
À ce volume, comparer trois politiques à une sensibilité d’un pour cent, même face à la base de référence plus clémente de quatre pour cent, coûte environ quatre mois de tout ce qu’ASOS vend, en supposant, de façon fantaisiste, que l’intégralité du carnet de commandes soit routée vers le test. Portez le champ à cinquante et la même hypothèse fantaisiste dévore la majeure partie de cinq années.
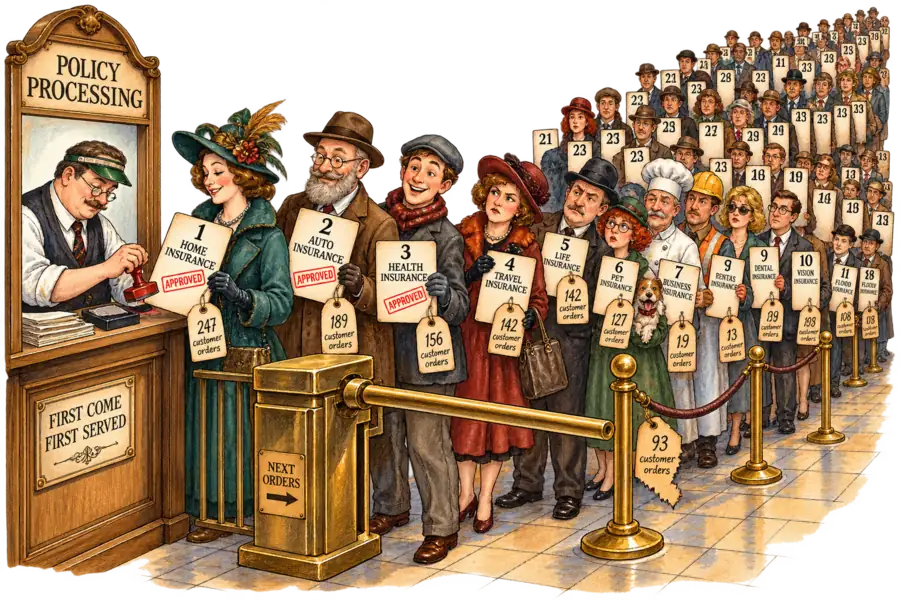
Aucun distributeur ne consacre l’intégralité de son carnet de commandes à une seule cellule de test. Réduisez l’allocation à un quart du trafic, et la seule comparaison de trois politiques dépasse déjà la durée d’une année commerciale. Les cinquante politiques ne forment pas un portefeuille d’options ; elles forment une file d’attente.
Kohavi avait posé ce plafond dès 2015, quand les candidats étaient encore construits à la main : à vingt pour cent des utilisateurs, Bing « ne pouvait exécuter que 5 variantes disjointes ».
Les 250 expériences quotidiennes de Bing ne sont pas le contre-exemple qu’elles semblent être. Elles se chevauchent sur des surfaces distinctes, chacune posant une question indépendante, alors que cinquante classeurs candidats pour un seul emplacement se disputent les mêmes événements de conversion.
L’objection la plus solide est que la comparaison a déjà été rendue bon marché hors ligne. Rejouez les journaux, notez cinquante candidats sur des interactions historiques, promouvez les trois meilleurs, et la facture s’effondre. Pour que cela tienne, le classement hors ligne devrait préserver l’ordre en ligne — le candidat le mieux noté sur données journalisées devrait être celui qui déplace de l’argent. Booking.com a testé cette proposition sur 23 comparaisons d’un modèle éprouvé face à un challenger. La corrélation entre le gain de performance hors ligne et le gain de valeur commerciale ressort à moins 0,1, avec un intervalle de confiance à 90 % allant de moins 0,45 à 0,27. La corrélation ne tenait que là où la métrique hors ligne suivait déjà la métrique commerciale de très près, ce qui était rare dans un système de classement en production.
L’étroitesse de ce constat est précisément ce qu’il faut en retenir, plutôt qu’un défaut. Les modèles de Booking étaient déjà bons, visant une seule métrique au sein d’un seul produit, la position même qu’occupe tout distributeur mature lorsqu’il aligne cinquante classeurs candidats. L’équipe de Taobao est instructive : MetaStrategy s’est entraîné dans un environnement de rejeu qui refait tourner les requêtes journalisées à travers la pile en production sans exposer les utilisateurs, et a malgré tout acheté un test randomisé de sept jours pour afficher un gain de 2,11 % en pages vues cliquées. CASP, un article arXiv d’avril sur la sélection de politiques hors ligne, validé sur des simulations et un catalogue MovieLens reconstitué plutôt que sur un déploiement de commerce en production, nomme le mécanisme en jeu : changer le générateur de candidats modifie à la fois la valeur d’une politique et le support de données sur lequel repose son estimation. Le criblage hors ligne restreint le champ ; il ne le tranche pas, et c’est le tranchage qui coûte.
La recherche s’attaque désormais directement au budget de comparaison, quoique pas depuis l’intérieur du commerce de détail. Dynamically Allocating Evaluation Effort for Model Ranking, publié le 4 août, traite l’évaluation multi-modèles comme un problème d’identification du meilleur bras avec bras corrélés, échantillonnant de façon adaptative pour que le budget se concentre sur les modèles encore en lice. Son cadre est l’évaluation humaine de systèmes de TAL, pas des acheteurs, et sa preuve d’optimalité concerne des heures d’annotation. La structure se transpose néanmoins à un programme A/B/n de commerce de détail, car le problème sous-jacent est identique : des déploiements coûteux, un budget fixe, un champ de candidats dont la plupart perdent. Ce qui ne se transpose pas, c’est la monnaie, car un déploiement en production se paie en clients ayant reçu la politique perdante.
Cinquante politiques, ce n’est pas une stratégie ; c’est une facture que personne n’a lue. Si la génération de candidats continue de baisser en coût tandis que le volume de commandes stagne, l’avantage se déplace vers les distributeurs qui posent les meilleures questions plutôt que vers ceux qui ont les meilleurs modèles. Nommer les trois comparaisons qui méritent la sensibilité d’une année entière est un jugement de merchandising déguisé en habit de statisticien, et il revient aux personnes qui savent ce que l’entreprise cherche à faire bouger. Les quarante-sept politiques jamais testées ne sont pas des occasions perdues. Elles sont ce que coûtent trois bonnes questions.