AcCoRD A Distingué Quatre Types D'Acheteurs. Les Agents Ont Échoué Sur Celui Que Vend L'Habillement.
Un nouveau benchmark arXiv évalue les agents d'achat de pointe à 0,226 sur les préférences qui se forment en cours de conversation, contre 0,932 sur celles que l'acheteur possédait déjà en arrivant. La découverte en habillement repose sur le premier type, et les benchmarks sur lesquels le commerce s'appuie pour ses achats ne le contiennent pas.
Admiral Neritus Vale
Le modèle le plus performant d’un nouveau benchmark d’agents d’achat satisfait les préférences qui se forment en cours de conversation à 0,226 sur une échelle de zéro à un, contre 0,932 pour les préférences que l’acheteur détenait déjà en entrant. AcCoRD, publié sur arXiv le 28 août, répartit les préférences des utilisateurs en quatre catégories et constate que les modèles de pointe maîtrisent trois d’entre elles tout en échouant totalement sur la quatrième. Cette catégorie défaillante est précisément le mode dans lequel opère la découverte de produits en habillement, ce qui signifie que les benchmarks sur lesquels le commerce s’appuie pour acheter ses agents évaluent une tâche différente de celle qu’il cherche à acquérir.
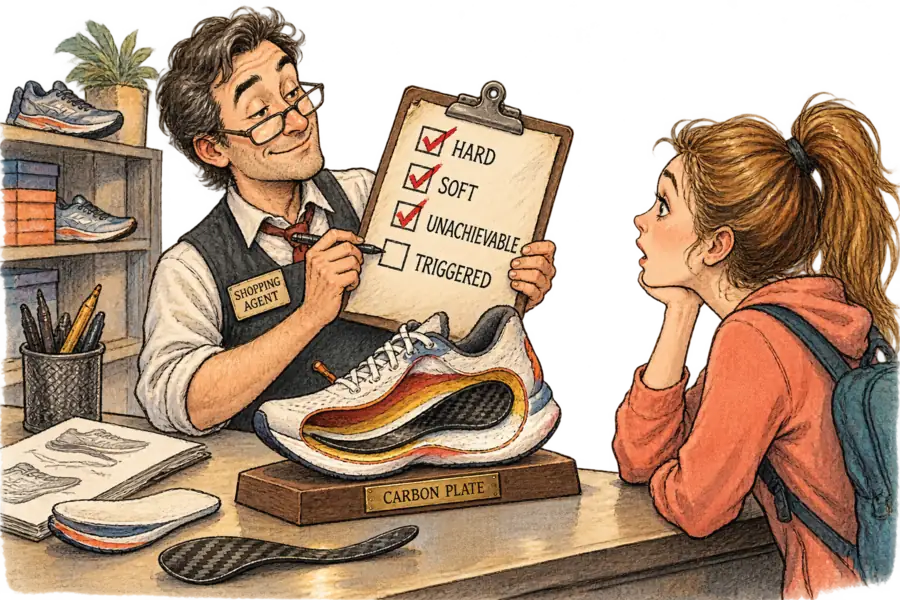
La taxonomie d’AcCoRD classe les préférences selon la manière dont elles parviennent à l’agent. La sous-spécification dure est une exigence fixe que l’acheteur détient sans l’avoir formulée, et qu’une question de clarification permet de récupérer. Ajoutez de la flexibilité et vous obtenez la sous-spécification souple, où l’agent doit deviner quelle contrainte l’acheteur est prêt à sacrifier. Une préférence inatteignable est détenue mais indisponible en stock, ce qui oblige l’agent à révéler cet écart et à négocier une solution de repli. Les préférences déclenchées, elles, ne sont pas détenues du tout : l’exemple donné par les auteurs eux-mêmes est celui d’un acheteur qui parcourt des chaussures de running et qui « ignore l’existence des plaques en fibre de carbone en tant que caractéristique jusqu’à ce que l’agent mentionne un modèle qui en possède une, moment auquel l’utilisateur réalise qu’il la veut ». La partie « achat » du benchmark s’appuie sur WebShop, un environnement dérivé d’Amazon comptant plus d’un million de produits, dont la mode fait partie des catégories répertoriées.
Cet effondrement n’est pas la faiblesse d’un seul fournisseur. Dans l’ensemble du domaine de l’achat, la satisfaction des préférences déclenchées varie de 0,091 pour Llama-3.1-70B à 0,226 pour Claude Sonnet 4.5, que l’étude identifie comme le modèle globalement le plus performant sur les deux benchmarks. L’écart est important en termes relatifs et insignifiant en termes absolus — le meilleur score de cette colonne reste un échec. Aucune autre colonne ne s’en approche : même les préférences inatteignables, qui exigent que l’agent révèle un conflit de rupture de stock et négocie une solution de repli, obtiennent entre 0,674 et 0,817, un résultat imparfait mais bien plus proche d’être résolu que ne le sont les préférences déclenchées. Cette taxonomie a isolé une capacité que le secteur ne possède pas, plutôt qu’une capacité qu’un laboratoire particulier n’aurait simplement pas encore déployée.
Une préférence que l’agent ne révèle jamais est une préférence que le distributeur ne vend jamais, et dont il ne voit même pas qu’elle a échoué à se vendre.
Cet échec résiste à la solution la plus évidente. Les auteurs ont testé une invite guidée par l’incertitude, qui force l’agent à déclarer, avant chaque action, s’il doit soulever une incertitude non résolue auprès de l’utilisateur. Sur les préférences déclenchées, elle a fait passer GPT-5.1 de 0,178 à 0,297, tout en laissant Claude Sonnet 4.5 inchangé, à 0,224. Cette invite a également fait progresser les scores sur préférences déclenchées des modèles plus faibles, mais à un coût ailleurs : contraints de raisonner sur l’incertitude avant chaque mouvement, Llama-3.1-70B et DeepSeek-V3 ont posé trop de questions, épuisé leur budget de dialogue, et cessé de mener l’achat à terme — le taux de complétion de Llama est tombé de 72 % à 56 %. La conclusion des auteurs est que le prompting ne peut pas induire l’interaction soutenue et multi-tours qu’exigent les quatre dynamiques, et que le remède passe par l’entraînement.

Les agents ne sont pas lents à poser des questions ; ils parlent à peine. Les modèles de pointe prononcent en moyenne moins de deux énoncés adressés à l’utilisateur sur l’ensemble d’un épisode d’achat, un comportement parfaitement rationnel au regard de ce que récompensent les benchmarks retail du secteur. Le domaine Retail de τ²-Bench, celui dont le nom promet pourtant une couverture du commerce de détail, se limite en réalité à la gestion de compte e-commerce : retours de commande, échanges, remboursements. Le tableau comparatif d’AcCoRD classe son prédécesseur τ-bench dans la catégorie service client, et note l’absence de deux des quatre dynamiques ainsi qu’une représentation seulement partielle d’une troisième. Nous avons déjà évoqué à quel point ces simulateurs sont mal calibrés par rapport aux acheteurs réels ; il s’agit ici d’un défaut distinct, logé dans la tâche elle-même plutôt que dans l’utilisateur.
L’objection la plus solide serait de dire que les chiffres absolus n’ont jamais été le véritable enjeu. Un benchmark peut être mal calibré et remplir malgré tout sa fonction, à condition qu’il classe les modèles dans l’ordre que le déploiement confirmera ; une équipe d’achat a besoin que le classement tienne, pas que les décimales soient exactes. Cette défense exige une stabilité du classement à travers les colonnes, or les colonnes se contredisent. Avec l’invite guidée par l’incertitude, Llama-3.1-70B atteint 0,222 sur les préférences déclenchées, contre 0,224 pour Claude Sonnet 4.5, plaçant le modèle le plus faible de l’étude au même niveau que le plus fort sur l’unique dynamique dont dépend l’habillement. Un score agrégé qui classe les agents selon la propreté avec laquelle ils concluent un achat que l’acheteur avait déjà décidé continuera de produire cette même réponse.
Un groupe indépendant est parvenu à la même conclusion deux mois plus tôt, en partant de la direction opposée. Un article de juin soutient que les agents présupposent un utilisateur expert et se rabattent par défaut sur des questions de clarification, alors que l’acheteur manque souvent des connaissances du domaine nécessaires pour y répondre. Son benchmark, CoShop, accorde aux modèles de pointe cinq tours pour formuler une recommandation destinée précisément à cet utilisateur, et aucun agent ne dépasse 56 % de précision. Les auteurs situent l’échec dans la conversation plutôt que dans la recherche d’information, dans « la faible mesure dans laquelle l’interaction élargit ce que les utilisateurs savent de ce qu’ils veulent ». Deux benchmarks conçus dans des buts différents désignent la même capacité manquante : l’agent doit apprendre quelque chose à l’acheteur avant même que la préférence existe pour pouvoir être satisfaite.
Le coût se loge précisément là où le commerce ne mesure rien. Un agent choisi sur la base d’un score agrégé conclura l’achat que l’acheteur avait déjà en tête et laissera le reste du panier intact, et le tableau de bord affichera un taux de complétion sain, sans rien à quoi le comparer. eMarketer prévoit des ventes e-commerce américaines via des plateformes IA dépassant 20 milliards de dollars cette année ; quelle que soit la part que l’habillement en captera, elle se jouera sur l’intention déclarée, car l’intention déclarée est la seule chose que la couche agentique a été évaluée à servir. Si l’évaluation continue de récompenser la complétion plutôt que la révélation, le canal reproduira la barre de recherche plutôt que le rayon de vente, et le merchandising se sera retrouvé mis à la retraite par un système incapable de merchandiser. AcCoRD ne compte que 200 scénarios et un utilisateur simulé, et ses auteurs affirment sans détour que les acheteurs réels sont plus imprévisibles que le proxy qu’ils ont construit. C’est un argument pour tester cette quatrième colonne sur de vrais acheteurs, pas pour continuer à acheter sur la base des trois premières.