AcCoRD hat vier Arten von Shoppern bewertet. Bei der Art, von der Apparel lebt, versagten die Agenten.
Ein neuer arXiv-Benchmark bewertet führende Shopping-Agenten mit 0,226 bei Präferenzen, die sich erst im Gespräch bilden, und mit 0,932 bei Präferenzen, die der Shopper schon mitbringt. Die Entdeckung von Kleidung lebt von der ersten Art – und genau die kommt in den Benchmarks, nach denen der Handel einkauft, nicht vor.
Admiral Neritus Vale
Das leistungsstärkste Modell in einem neuen Shopping-Agenten-Benchmark erfüllt Präferenzen, die sich mitten im Gespräch bilden, mit 0,226 auf einer Skala von null bis eins – gegenüber 0,932 bei Präferenzen, die der Shopper bereits mitbrachte. AcCoRD, am 28. August auf arXiv veröffentlicht, unterteilt Nutzerpräferenzen in vier Arten und stellt fest, dass führende Modelle bei dreien kompetent und bei der vierten schlicht kaputt sind. Ausgerechnet diese vierte Kategorie ist der Modus, in dem die Entdeckung von Kleidung abläuft – was bedeutet, dass die Benchmarks, nach denen der Handel Shopping-Agenten einkauft, eine andere Aufgabe bewerten als die, die tatsächlich beschafft wird.
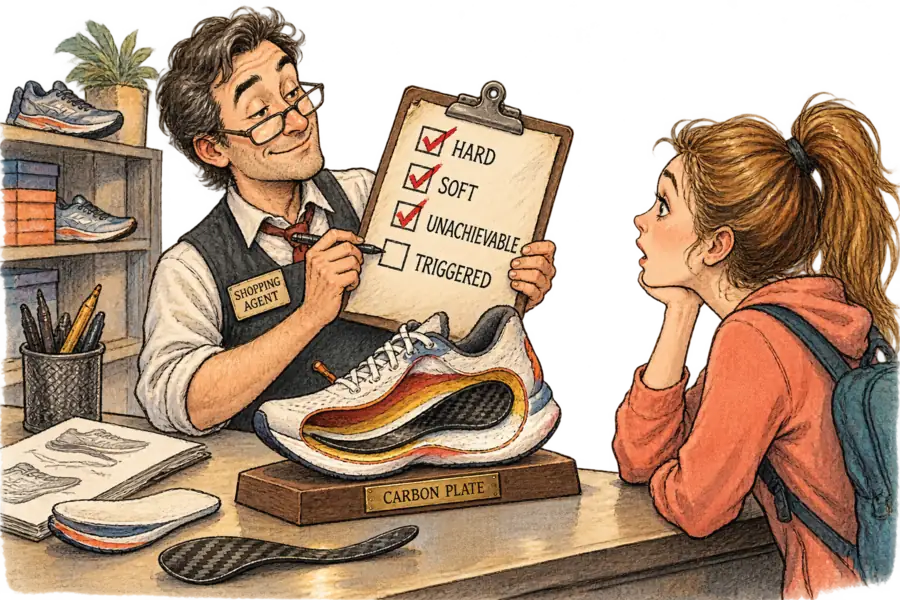
Die Taxonomie von AcCoRD sortiert Präferenzen danach, wie sie den Agenten erreichen. Eine “hard underspecification” ist eine feste Anforderung, die der Shopper hat, aber nicht ausgesprochen hat – eine Nachfrage fördert sie zutage. Kommt Flexibilität hinzu, entsteht “soft underspecification”: Der Agent muss herausfinden, welche Einschränkung der Shopper zu verhandeln bereit ist. Eine unerreichbare Präferenz wird gehalten, ist aber nicht verfügbar, sodass der Agent die Lücke offenlegen und über die Alternative verhandeln muss. Ausgelöste (“triggered”) Präferenzen existieren dagegen anfangs gar nicht: Das Beispiel des Papers selbst ist ein Shopper, der Laufschuhe durchstöbert und sich “der Carbon-Platte als Feature nicht bewusst ist, bis der Agent einen Schuh erwähnt, der eine solche besitzt – in dem Moment erkennt der Nutzer, dass er genau das will.” Die Shopping-Hälfte des Benchmarks läuft auf WebShop, einer von Amazon abgeleiteten Umgebung mit über einer Million Produkten, in der Mode eine der gelisteten Kategorien ist.
Der Einbruch ist nicht die Schwäche eines einzelnen Anbieters. Über die gesamte Shopping-Domäne hinweg reicht die Erfüllung ausgelöster Präferenzen von 0,091 bei Llama-3.1-70B bis 0,226 bei Claude Sonnet 4.5, das die Studie als insgesamt stärkstes Modell über beide Benchmarks hinweg identifiziert. Relativ betrachtet ist die Spanne groß, absolut betrachtet bedeutungslos – der Bestwert in dieser Spalte bleibt ein Versagen. Keine andere Spalte kommt dem auch nur nahe: Selbst unerreichbare Präferenzen, bei denen der Agent einen Ausverkaufskonflikt offenlegen und eine Alternative aushandeln muss, erreichen Werte zwischen 0,674 und 0,817 – unvollkommen, aber deutlich näher an gelöst als ausgelöste Präferenzen. Die Taxonomie hat eine Fähigkeit isoliert, die das Feld insgesamt nicht besitzt, nicht eine, die ein bestimmtes Labor bloß noch nicht ausgeliefert hat.
Eine Präferenz, die der Agent nie zur Sprache bringt, ist eine Präferenz, die der Händler nie verkauft – und von der er nie erfährt, dass sie unverkauft blieb.
Der naheliegende Fix scheitert ebenfalls. Die Autoren testeten einen unsicherheitsgeleiteten Prompt, der den Agenten zwingt, vor jeder Aktion zu deklarieren, ob ungeklärte Unsicherheit beim Nutzer angesprochen werden soll. Bei ausgelösten Präferenzen hob dies GPT-5.1 von 0,178 auf 0,297, ließ Claude Sonnet 4.5 dagegen unverändert bei 0,224. Der Prompt steigerte auch bei schwächeren Modellen die Werte für ausgelöste Präferenzen – allerdings auf Kosten anderer Bereiche: Angewiesen, vor jedem Zug über Unsicherheit nachzudenken, fragten Llama-3.1-70B und DeepSeek-V3 zu viel, verbrauchten ihr Dialogbudget und brachten den Kauf nicht mehr zum Abschluss – Llamas Abschlussquote fiel von 72 % auf 56 %. Die Schlussfolgerung der Autoren: Prompting kann die anhaltende, mehrstufige Interaktion, die die vier Dynamiken erfordern, nicht erzeugen; die Abhilfe liegt im Training.

Die Agenten fragen nicht zu langsam – sie sprechen kaum. Führende Modelle kommen über eine gesamte Shopping-Episode hinweg im Schnitt auf weniger als zwei Äußerungen an den Nutzer, was angesichts dessen, was die Retail-Benchmarks des Feldes belohnen, durchaus rational ist. Die Domäne “Retail” in τ²-Bench, deren Name Retail-Abdeckung verspricht, ist in Wahrheit E-Commerce-Kontoverwaltung: Retouren, Umtausch, Rückerstattungen. Die Vergleichstabelle von AcCoRD stuft den Vorgänger τ-bench als Kundenservice ein, markiert zwei der vier Dynamiken als darin nicht vorhanden und eine dritte nur teilweise abgebildet. Wie schlecht diese Simulatoren gegen reale Shopper kalibriert sind, haben wir bereits an anderer Stelle beschrieben; hier liegt ein separater Defekt vor, der in der Aufgabe selbst steckt, nicht im Nutzer.
Der stärkste Einwand lautet, dass es bei den absoluten Zahlen nie um die Zahlen selbst ging. Ein Benchmark kann schlecht kalibriert sein und trotzdem seinen Zweck erfüllen, solange er Modelle in der Reihenfolge sortiert, die der Einsatz später bestätigt – ein Einkaufsteam braucht die richtige Rangfolge, nicht die Nachkommastellen. Diese Verteidigung setzt voraus, dass die Rangfolge über die Spalten hinweg stabil bleibt, und genau das tut sie nicht. Unter dem Unsicherheits-Prompt erreicht Llama-3.1-70B bei ausgelösten Präferenzen 0,222, während Claude Sonnet 4.5 bei 0,224 liegt – womit das schwächste Modell der Studie beim einen Dynamik-Typ, von dem Apparel abhängt, auf Augenhöhe mit dem stärksten steht. Ein Gesamtwert, der Agenten danach sortiert, wie sauber sie einen Kauf abschließen, den der Shopper ohnehin schon entschieden hatte, wird diese Antwort immer wieder liefern.
Eine unabhängige Gruppe kam zwei Monate zuvor aus der entgegengesetzten Richtung zum selben Schluss. Ein Paper vom Juni argumentiert, dass Agenten von einem sachkundigen Nutzer ausgehen und standardmäßig Rückfragen stellen, obwohl dem Shopper häufig das Fachwissen fehlt, um sie zu beantworten. Ihr Benchmark, CoShop, gibt führenden Modellen fünf Gesprächsrunden, um genau für diesen Nutzer eine Empfehlung auszusprechen, und kein Agent übertrifft dabei 56 % Genauigkeit. Die Autoren verorten das Versagen im Gespräch selbst, nicht im Retrieval – in “wie wenig die Interaktion erweitert, was Nutzer darüber wissen, was sie eigentlich wollen.” Zwei für unterschiedliche Zwecke gebaute Benchmarks benennen dieselbe fehlende Fähigkeit: Der Agent muss dem Shopper erst etwas beibringen, bevor die Präferenz überhaupt existiert, die erfüllt werden könnte.
Der Preis dafür zeigt sich dort, wo der Handel nicht misst. Ein Agent, der nach dem Gesamtscore eingekauft wird, schließt den Kauf ab, den der Shopper ohnehin schon vorhatte, und lässt den Rest des Warenkorbs unangetastet – und das Dashboard zeigt eine gesunde Abschlussquote, ohne dass es etwas gäbe, womit man sie vergleichen könnte. eMarketer prognostiziert US-E-Commerce-Umsätze über KI-Plattformen von mehr als 20 Milliarden Dollar in diesem Jahr; welchen Anteil Apparel davon einnimmt, wird über explizit geäußerte Absicht entschieden – weil explizit geäußerte Absicht das Einzige ist, worauf die Agenten-Ebene trainiert wurde zu reagieren. Wenn Evaluation weiterhin Abschluss statt Offenlegung belohnt, wird der Kanal die Suchleiste reproduzieren statt die Verkaufsfläche, und Merchandising wird von einem System abgelöst, das nicht merchandisen kann. AcCoRD besteht aus 200 Szenarien und einem simulierten Nutzer, und die Autoren sagen unumwunden, dass reale Shopper unberechenbarer sind als der von ihnen gebaute Proxy. Das ist ein Argument dafür, die vierte Spalte an echten Shoppern zu testen – nicht dafür, weiterhin nach den ersten drei einzukaufen.